建议先阅读: 容器概览 — 理解栈的底层存储(数组 vs 链表)和扩容机制。
原理

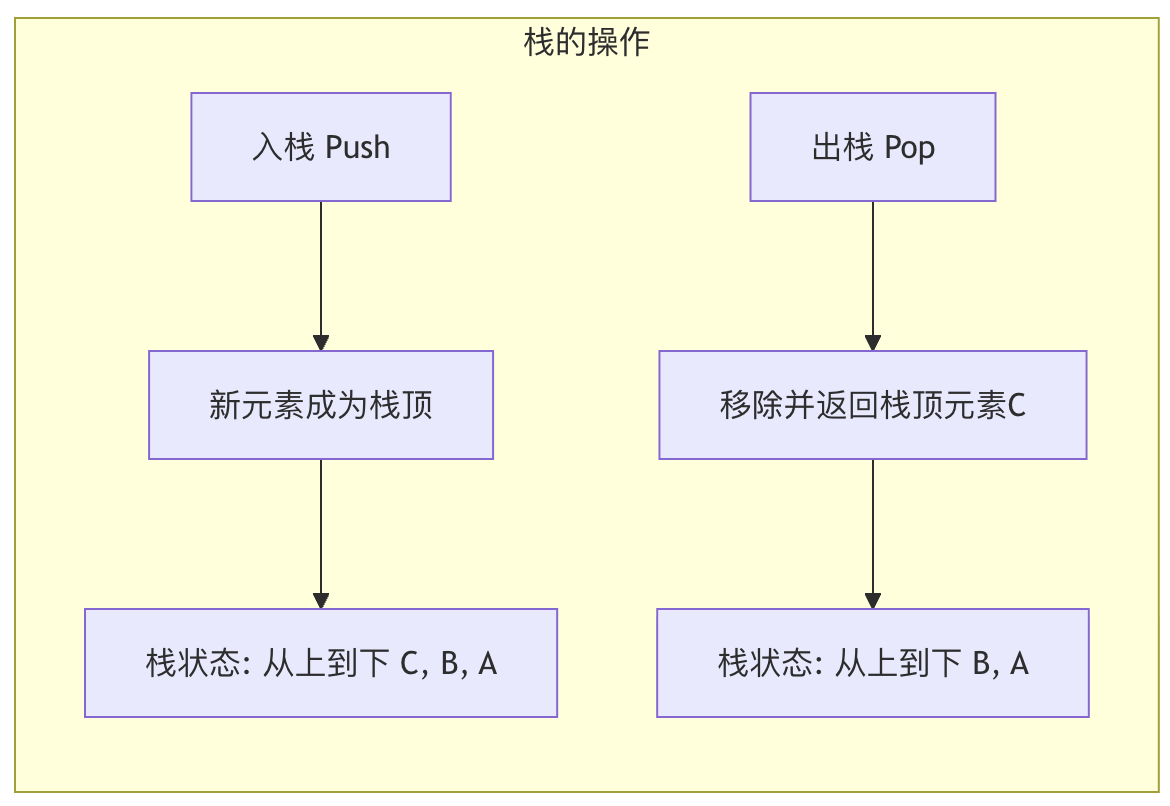
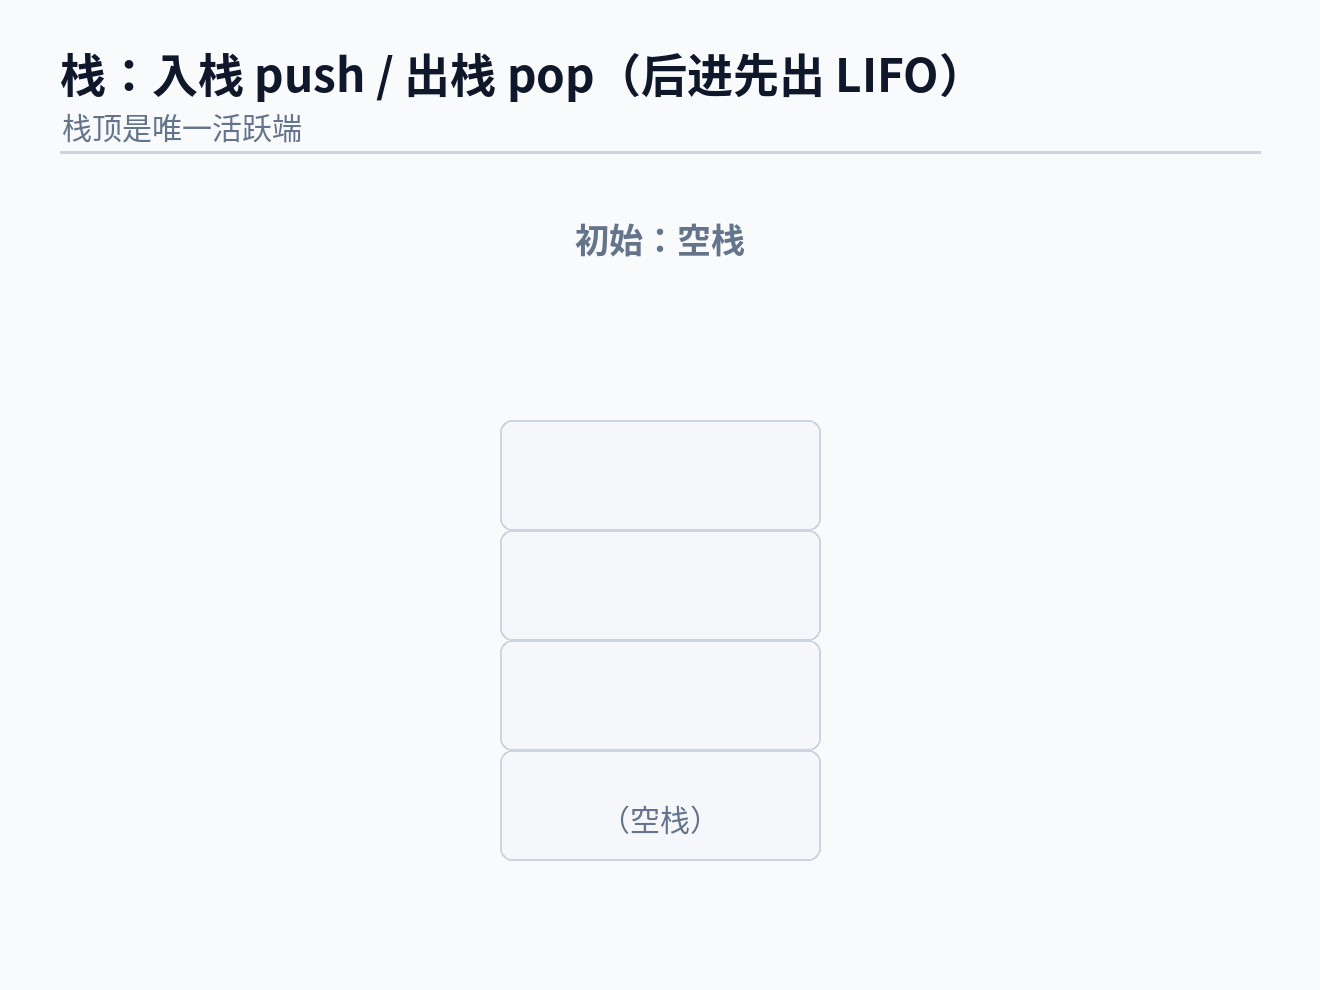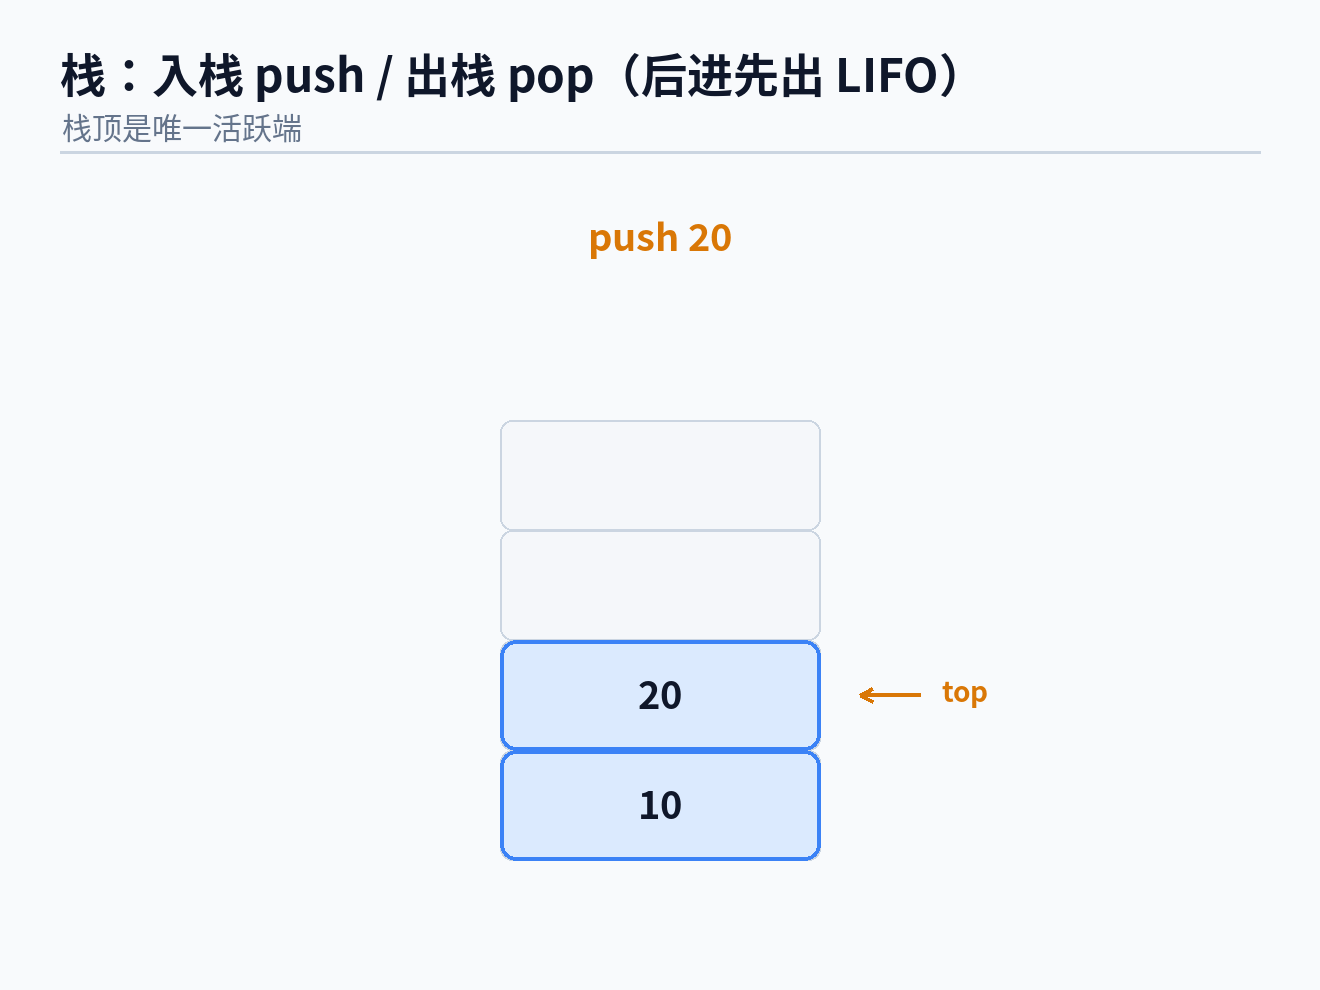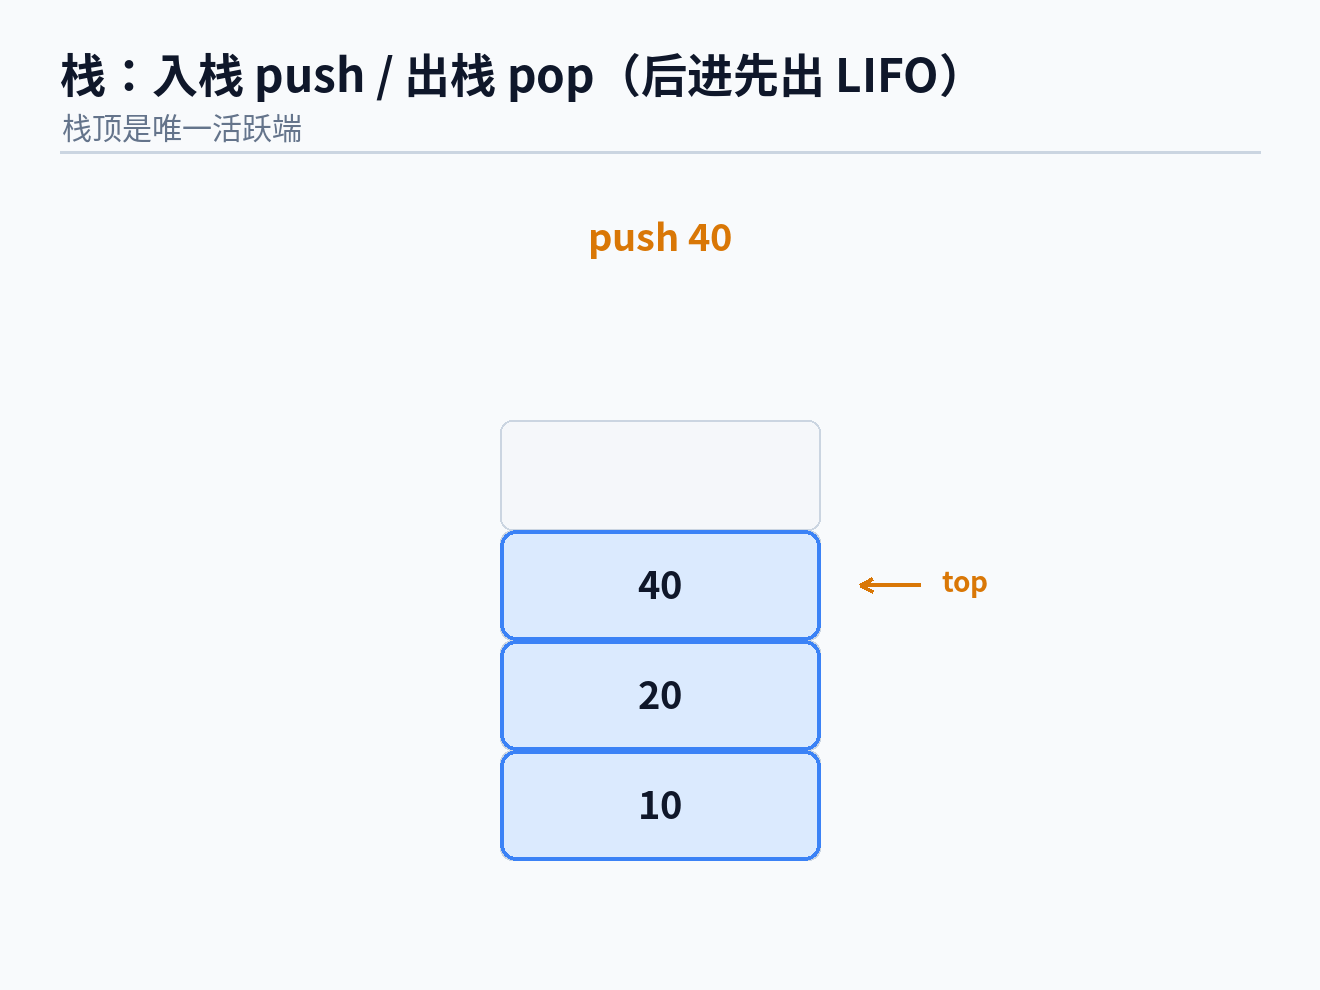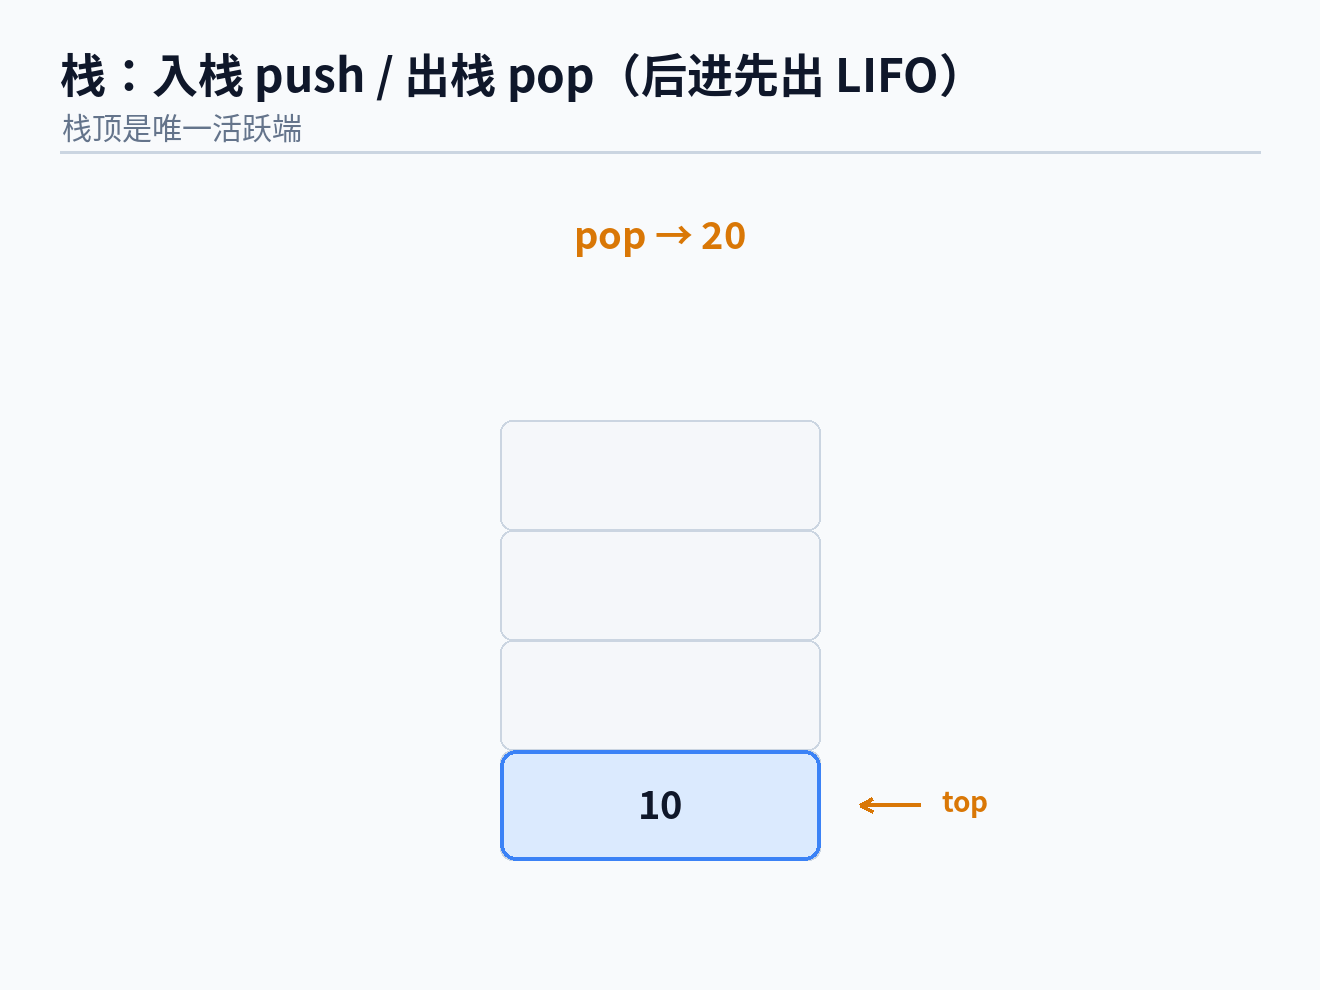
栈(Stack)是受限的线性数据结构——所有操作均发生在同端(栈顶),遵循后进先出(LIFO: Last In, First Out)。这种”单向开口”的约束看似限制了灵活性,实则赋予了栈一种精确的时序语义:最近入栈的数据最优先被处理。
栈在哪里
在写第一行栈代码之前,先看它已经在哪运转:每次函数调用都在向调用栈压入一个新栈帧,return 就是弹栈;编辑器的 Ctrl-Z 弹出的正是最近一次操作;浏览器的后退按钮弹出的是上一个页面;编译器判断 ({[]}) 是否配对靠的是括号栈。这些场景的共同主题——需要按”最近发生优先”的次序回溯——正是 LIFO 的用武之地。本章沿这条线展开:先把基础操作写扎实,再逐一拆解括号匹配与表达式求值,最后深入到硬件调用栈的底层机制。
| 操作 | 描述 | 时间复杂度 |
|---|---|---|
push(x) | 将 x 压入栈顶 | |
pop() | 弹出栈顶元素 | |
top() | 不弹出,只读栈顶 | |
empty() | 是否为空 | |
size() | 元素个数 |
栈的物理实现
栈作为抽象数据类型,有两种物理实现方式。选择取决于对容量、内存开销和缓存行为的需求。
数组实现(连续存储):
- 在内存中预留一块连续区域,用
top索引标记栈顶 - 扩容策略见 容器章节 的均摊分析
- 缓存友好——push/pop 都是顺序访问栈顶附近的内存
链表实现(节点存储):
- 无容量上限,每个节点单独
malloc - 每次 push 带有堆分配开销(~50-200ns),pop 有释放开销
- 由于只在头部操作,链表的”指针追踪”问题比完整链表遍历轻微——但连续 10 万次 push/pop 的累计堆开销远超数组版
栈的抽象数据类型、逻辑结构与存储结构
学习任何一个数据结构,都要回答四个问题:它的逻辑结构是什么、存储结构可能有哪几种、定义了哪些运算、这些运算如何用一套**抽象数据类型(ADT)**接口描述。栈的答案是:
| 维度 | 栈 |
|---|---|
| 逻辑结构 | 线性结构(元素一对一),但运算受限:只允许在同一端(栈顶)插入和删除 |
| 存储结构 | 顺序栈(数组)/ 链栈(单链表头部)/ 共享栈 |
| 基本运算 | InitStack、DestroyStack、StackEmpty、Push、Pop、GetTop |
| 重要特性 | 后进先出(LIFO);栈顶是唯一”活跃端” |
栈属于操作受限的线性表:逻辑上仍是一对一的线性关系,只是把”任意位置插删”收紧为”只能在端点插删”。因此顺序表的两种存储方式(顺序/链式)在这里都适用,只是实现更简单——所有操作都围绕端点。这与 线性表 中”同一套 ADT 接口,底层换数组或指针”的思想一脉相承。
栈与队列:共同点与差异
栈和队列经常成对出现,把它们的异同一张表理清,后面遇到组合题可以直接调用:
| 对比项 | 栈 | 队列 |
|---|---|---|
| 操作规则 | 后进先出 LIFO | 先进先出 FIFO |
| 逻辑结构 | 线性结构(一对一) | 线性结构(一对一) |
| 受限方式 | 仅在同一端(栈顶)插入、删除 | 在一端(队尾)插入、另一端(队首)删除 |
| 顺序存储 | 顺序栈(top 指针) | 循环队列(front/rear) |
| 链式存储 | 链栈(在头部操作,无需尾指针) | 链队列(需队首、队尾两个指针) |
| 空判定(顺序) | top == -1(视约定) | front == rear |
| 经典应用 | 括号匹配、表达式求值、递归、DFS | BFS、缓冲区、调度、生产者-消费者 |
共同点归纳:
- 都是操作受限的线性表,逻辑结构都是线性的(一对一),属于线性结构而非非线性;
- 都可以用顺序存储或链式存储实现,存储方式与逻辑结构无关;
- 插入、删除都只在端点进行,因此核心操作均为 (数组版在扩容均摊意义下也是 );
- 都可以用双端队列(Deque) 统一描述——限制 Deque 的一端只出不进得到栈,限制两端一进一出得到队列;
- 都能用于保存中间状态、消除递归、处理具有先后次序要求的问题。
一句话记忆:栈是”单端受限”的线性表,队列是”双端分工”的线性表,二者都是 Deque 的退化。
深入底层
硬件级栈:x86-64 调用栈
栈不仅是抽象数据结构,更是 CPU 硬件原生支持的核心机制。x86-64 架构通过 rsp(栈指针寄存器)和 rbp(基址指针寄存器)提供硬件级栈支持:
flowchart TB
  H["⬆ 高地址"]
  M["main 的栈帧(局部变量等)\n← rbp (main 的基址指针)"]
  R["返回地址 ← call 指令推入的 rip, 8 字节"]
  F["foo 的栈帧\n← rbp (foo 的基址指针) ← rsp\nint a = 3 [rbp-4]\nint b = 5 [rbp-8]\nchar buf[32] [rbp-40]"]
  L["⬇ 低地址"]
  H --- M --- R --- F --- L
; C 代码: int add(int a, int b) { return a + b; }

add:
 push rbp ; 保存调用者的 rbp
 mov rbp, rsp ; 建立自己的栈帧基址
 mov DWORD PTR [rbp-4], edi ; 参数 a (通过 edi 传入)
 mov DWORD PTR [rbp-8], esi ; 参数 b (通过 esi 传入)
 mov eax, DWORD PTR [rbp-4]
 add eax, DWORD PTR [rbp-8] ; eax = a + b
 pop rbp ; 恢复调用者的 rbp
 ret ; 弹出返回地址并跳转
call 指令等价于 push rip; jmp target。ret 指令等价于 pop rip。这两个指令在硬件层面由 CPU 的返回栈缓冲器(Return Stack Buffer, RSB)加速——RSB 是 CPU 内部的一个微型硬件栈,专门缓存返回地址,使得 ret 指令可以达到接近 0 周期的延迟。
栈溢出(Stack Overflow):
栈段的大小受操作系统限制(Linux 默认 8MB,ulimit -s)。以下场景触发栈溢出:
- 递归过深(如无终止条件的递归)
- 局部变量过大(如在栈上声明
int arr[1000000],占 4MB,超出剩余栈空间) - 无限递归相互调用(A 调 B,B 调 A)
栈溢出的后果是 SIGSEGV——CPU 访存时 MMU 检测到访问地址超出栈的映射范围,硬件触发 page fault,内核检查发现地址不合法后向进程发送段错误信号。
栈溢出利用(Stack Smashing):
在安全领域,栈溢出是最经典的攻击向量。当程序向栈上的局部缓冲区写入超出其大小的数据时,溢出数据会覆盖更高的栈帧内容——包括返回地址。攻击者构造恶意输入,使返回地址指向其注入的 shellcode 或 ROP 链中的 gadget。
// 典型的栈溢出漏洞
void vulnerable(char* input) {
 char buf[64];
 strcpy(buf, input); // 如果 input 长度 > 64,覆盖返回地址
}
graph TD subgraph "正常栈帧" BUF["buf[0..63] (64字节)"] --- SFP["保存的 rbp (8B)"] --- RET["返回地址 (8B)"] end subgraph "溢出后的栈帧" BUF2["buf[0..63] + 溢出数据"] -->|"覆盖"| SFP2["伪造的 rbp"] -->|"覆盖"| RET2["指向 shellcode 的地址"] end
现代防御:栈 canary(返回地址前放随机值,ret 前检查)、W^X(栈页不可执行)、ASLR(随机化地址)、影子栈(shadow stack,硬件/软件维护一份返回地址副本用于验证)。
递归如何映射到栈帧
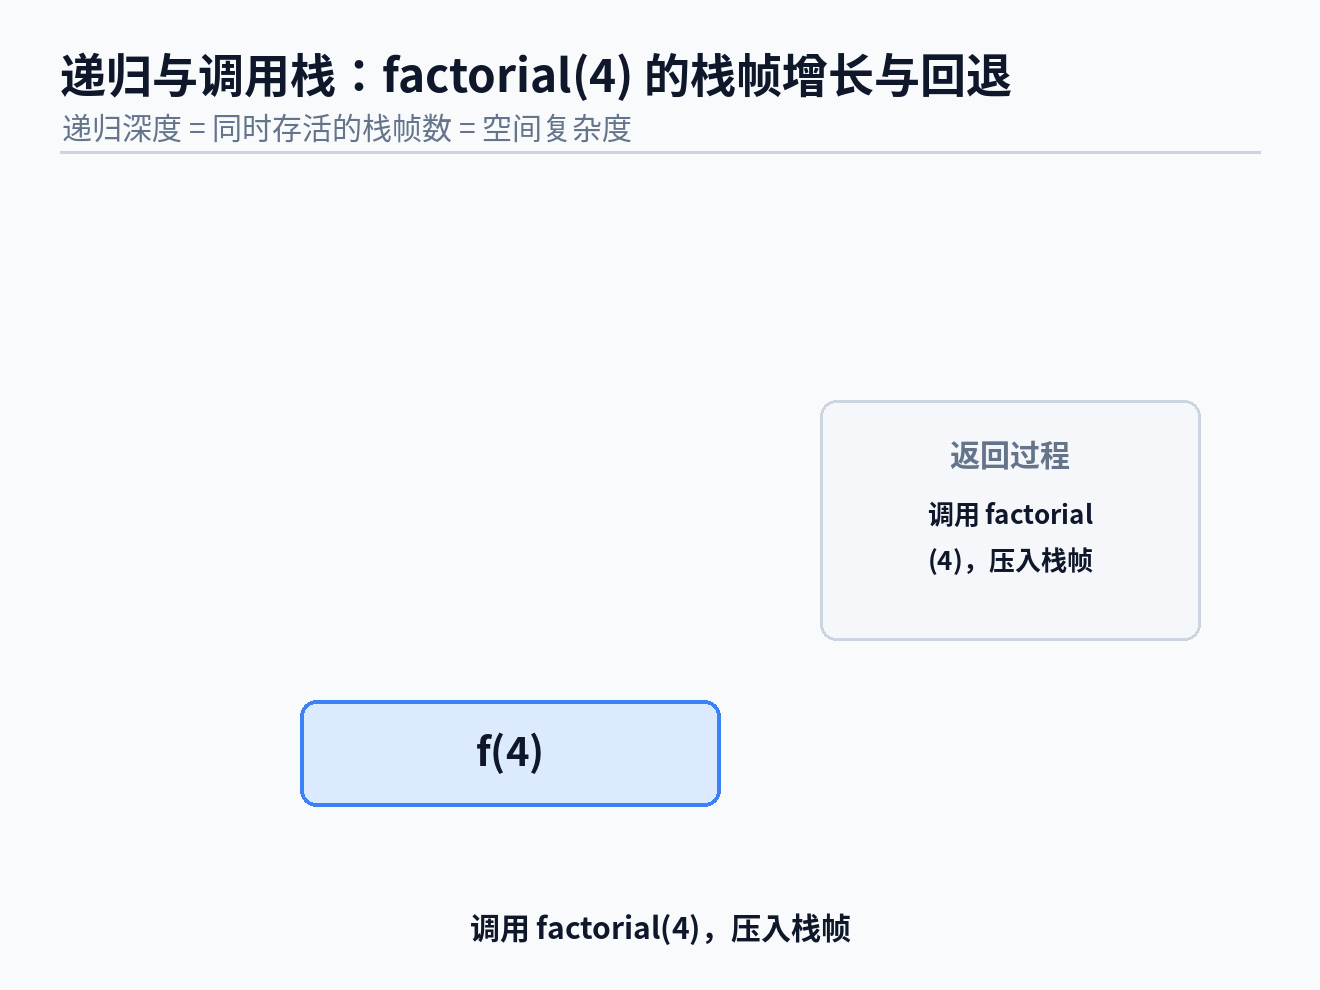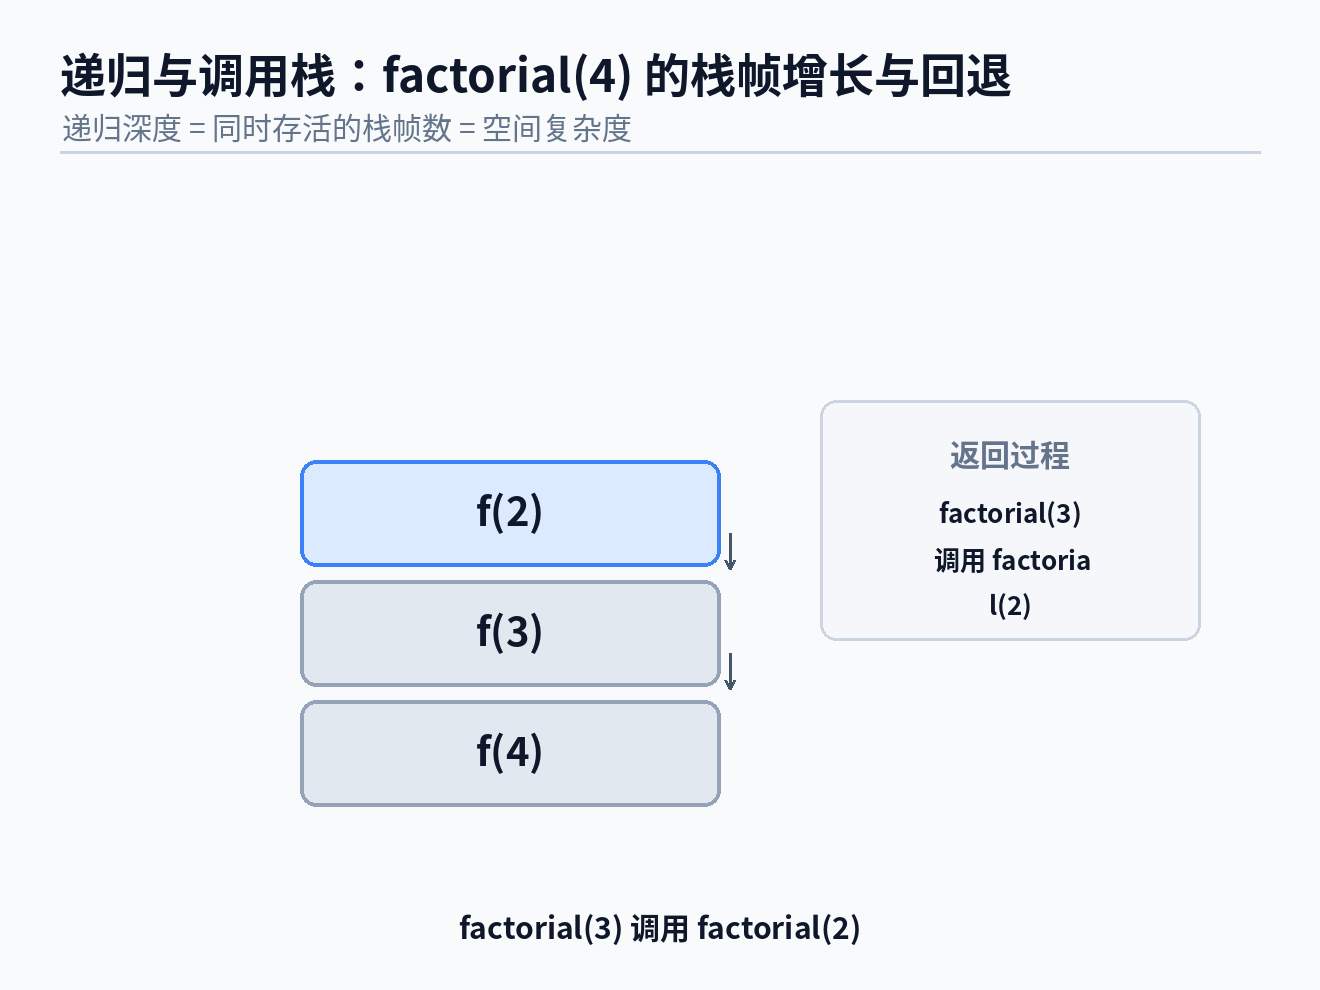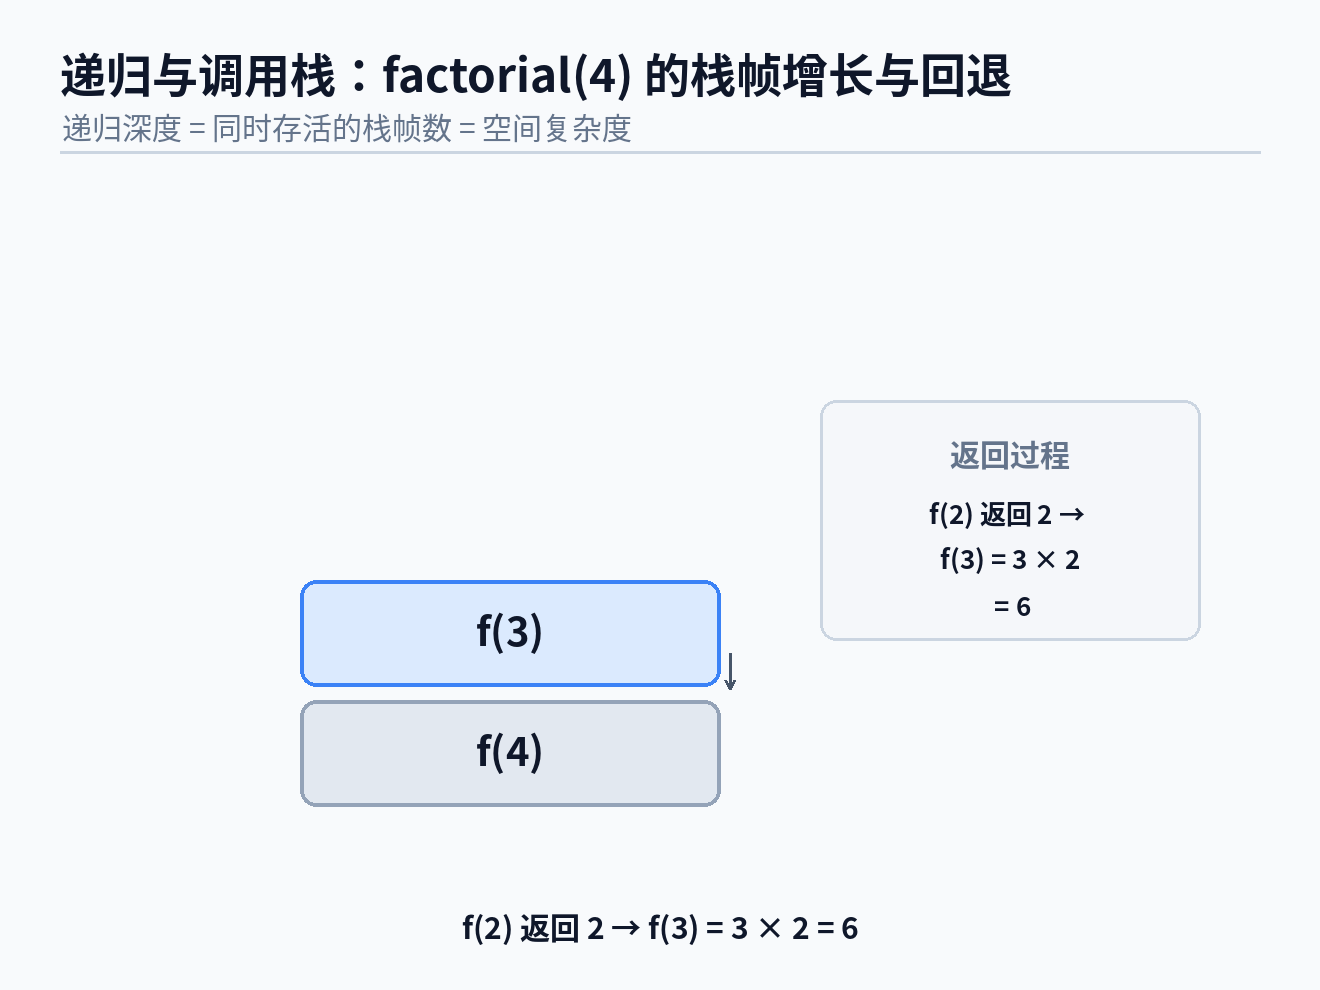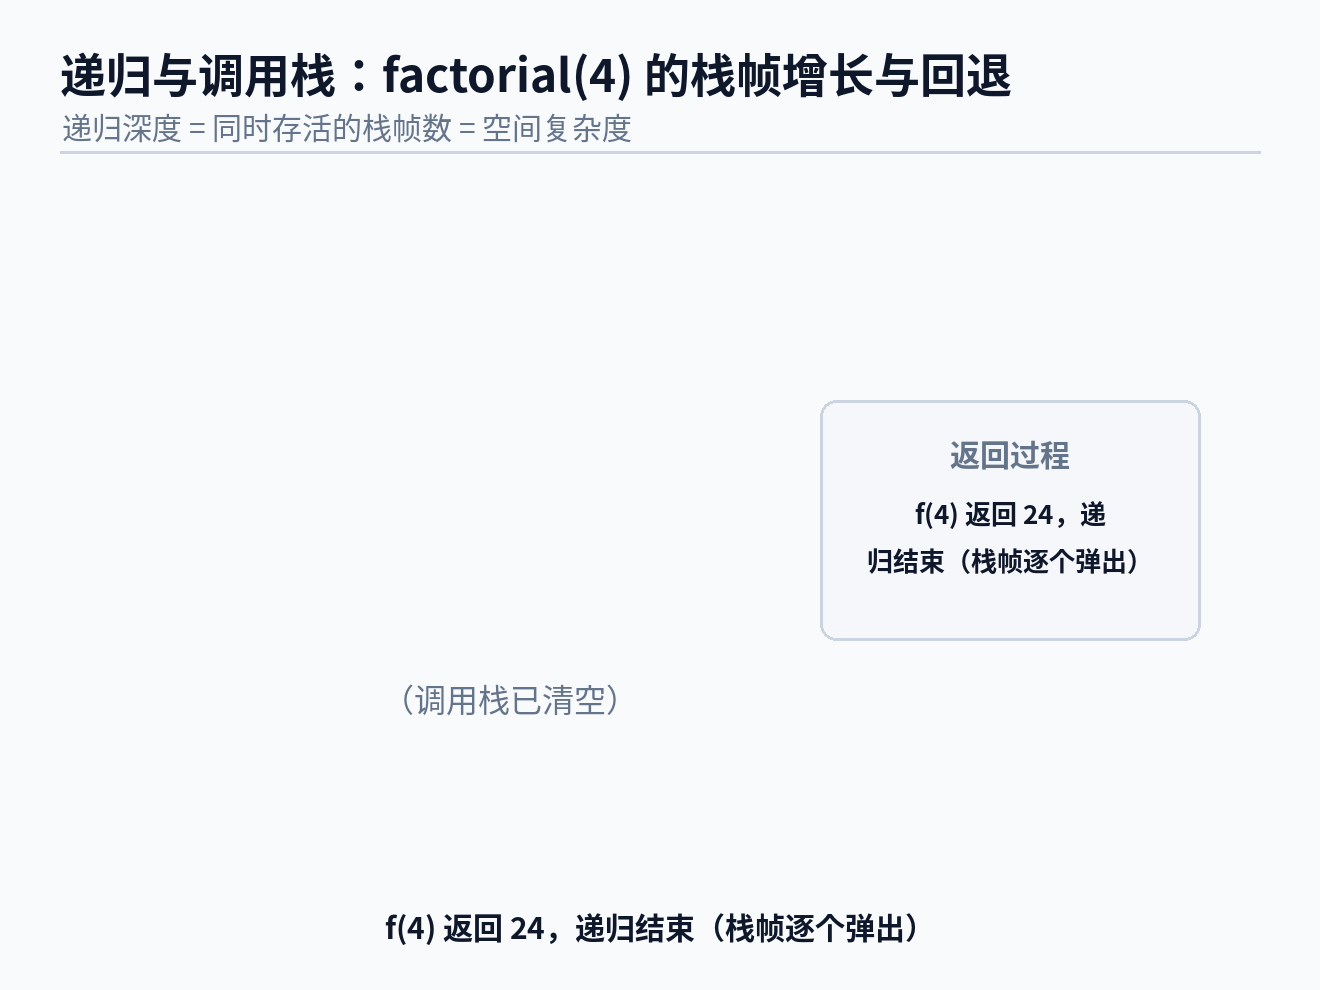
“递归就是系统替你维护了一个栈”——落到硬件上,每次递归调用执行 call 压入一个新栈帧(返回地址 + 参数 + 局部变量),基准情形触发后逐层 ret 弹栈。以 factorial(4) 为例,递推阶段栈帧的堆积:
flowchart TB
  M["main 帧"]
  F4["factorial(4)  [n=4 | 返回地址 | 等待 4 × f(3)]"]
  F3["factorial(3)  [n=3 | ...]"]
  F2["factorial(2)  [n=2 | ...]"]
  F1["factorial(1) ← 基准情形:直接返回 1"]
  M --> F4 --> F3 --> F2 --> F1
随后进入回归阶段:factorial(1) 返回 → 其帧弹出 → factorial(2) 拿到结果算出 2 → 弹出……直到 main。三个要点:
- 空间消耗 = 递归深度:同时存活的帧数即深度,——这正是链表章递归反转空间为 O(n) 的原因
- 深度超限 = 栈溢出:8MB 栈 ÷ 每帧几十字节 ≈ 十万量级深度上限(E2 实验可实测)
- 尾递归可优化:若递归调用是函数的最后一个动作(返回值不依赖后续计算),编译器可复用当前帧——gcc -O2 会做此优化,但 C 标准并不保证,不能依赖
单调栈(Monotonic Stack)
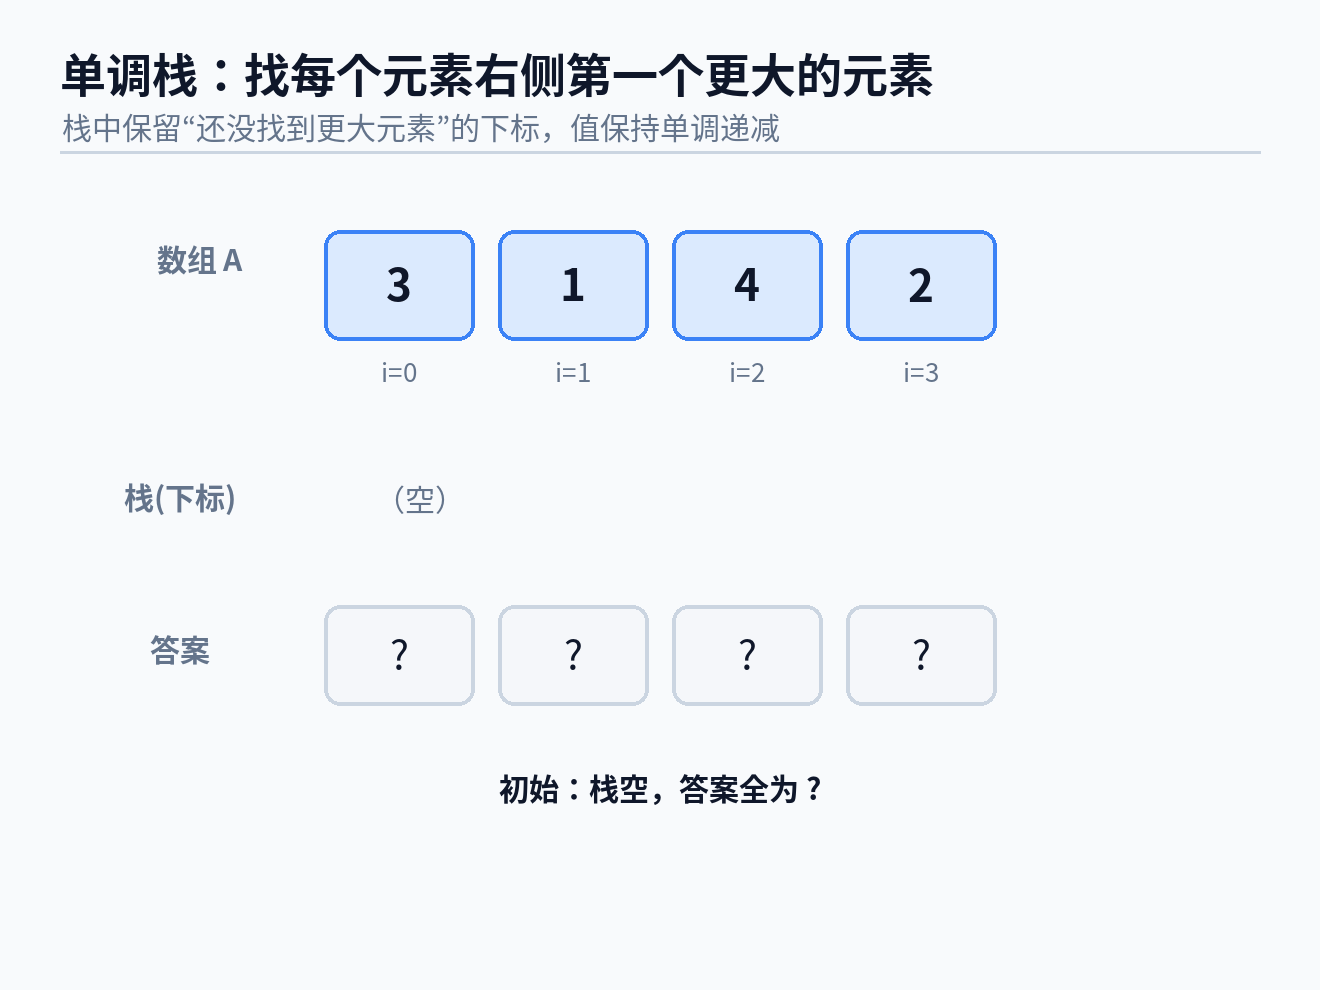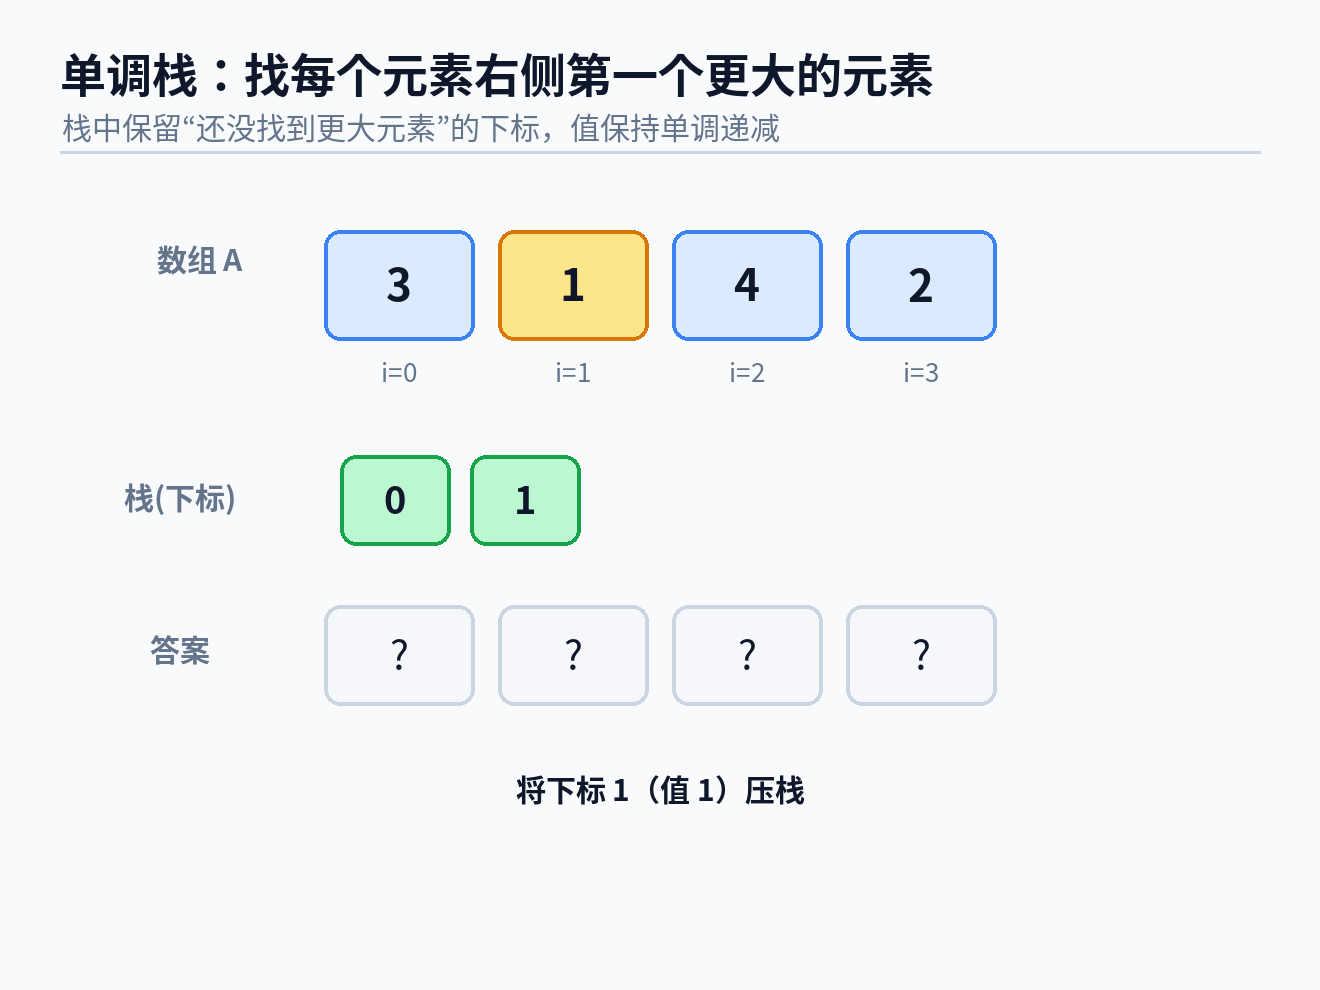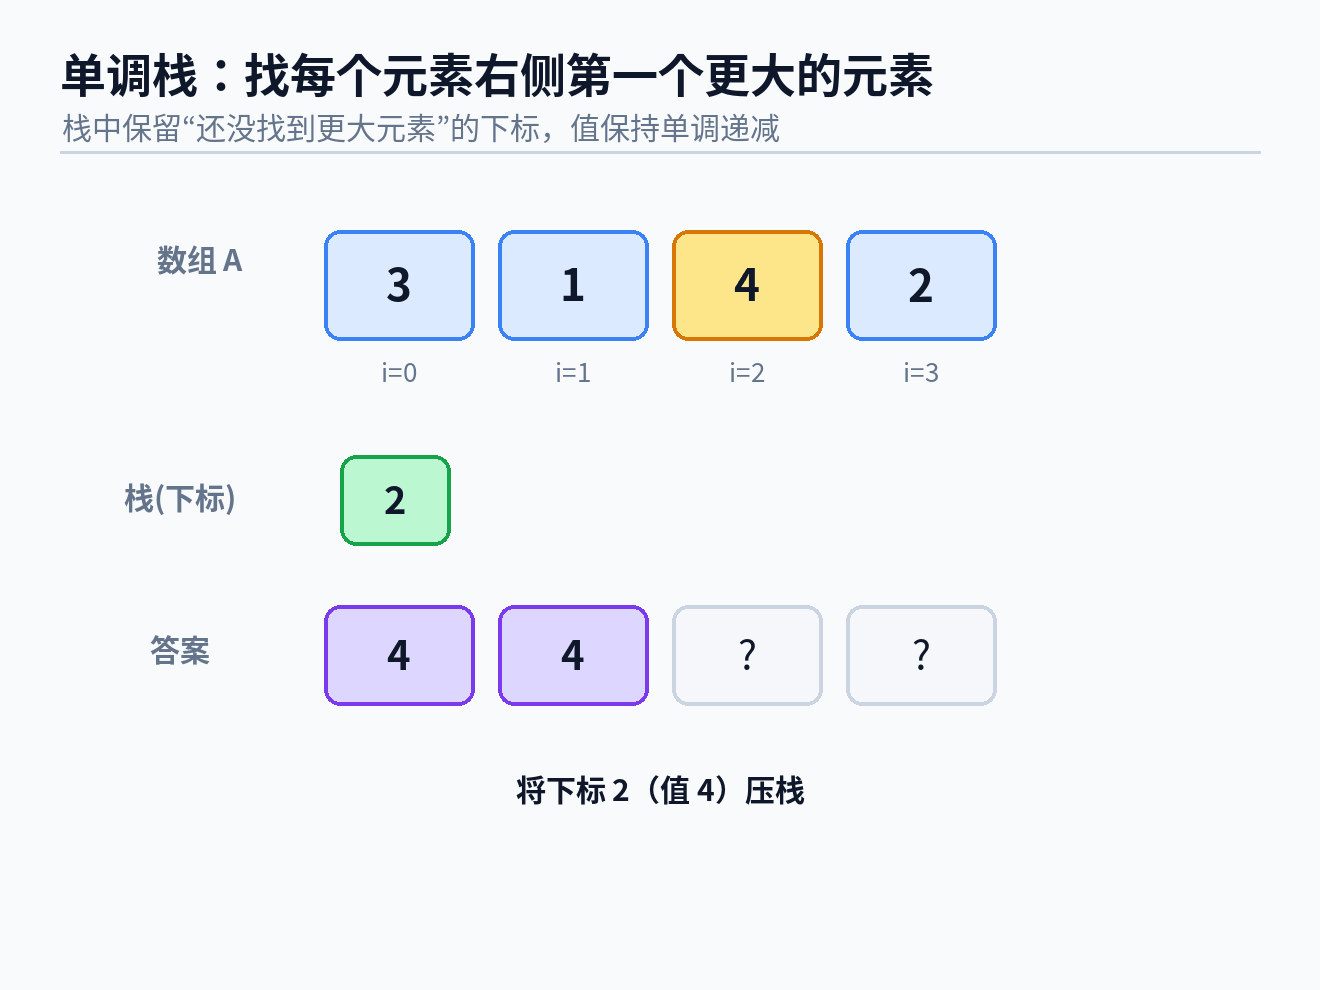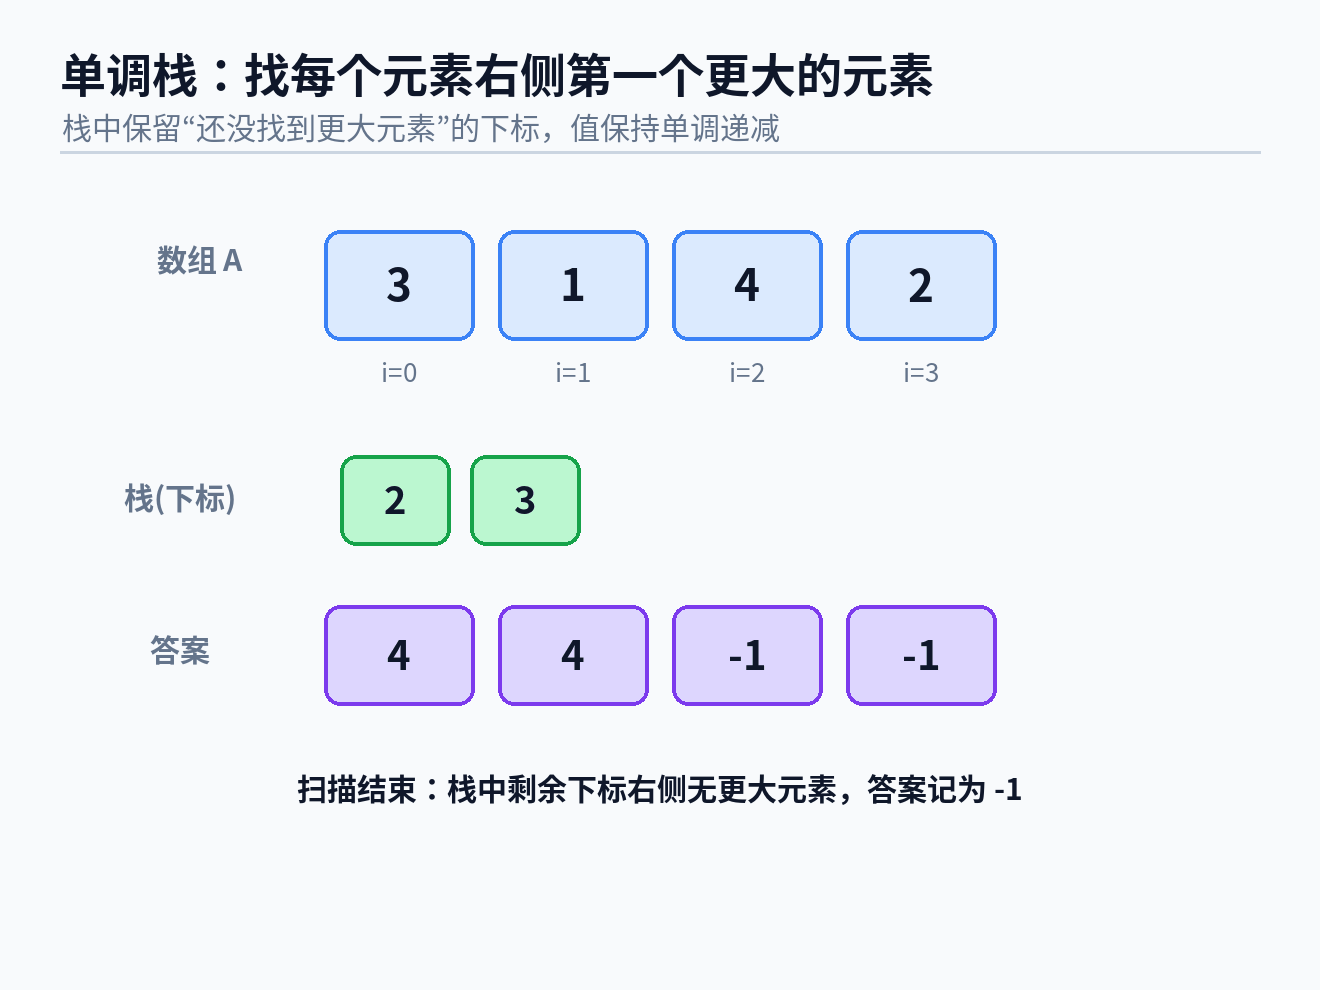
单调栈是栈的最强大变体之一——它维护栈内元素的单调性(递增或递减),通过 pop 掉破坏单调性的元素来找到”下一个更大/更小”的位置。
问题:给定数组 ,对每个位置 ,找出右侧第一个比 大的元素的下标。
例: A = [73, 74, 75, 71, 69, 72, 76, 73]

i=0 (73): 栈空,push 0
i=1 (74): A[1]=74 > A[栈顶=0]=73 → 答案[0]=1, pop 0, push 1
i=2 (75): A[2]=75 > A[栈顶=1]=74 → 答案[1]=2, pop 1, push 2
i=3 (71): A[3]=71 < A[栈顶=2]=75 → 栈单调递减,直接 push 3
i=4 (69): push 4
i=5 (72): A[5]=72 > A[栈顶=4]=69 → 答案[4]=5, pop 4
 A[5]=72 > A[栈顶=3]=71 → 答案[3]=5, pop 3, push 5
i=6 (76): A[6]=76 逐个弹出 5,2 → 答案[5]=6, 答案[2]=6, push 6
i=7 (73): A[7]=73 < A[栈顶=6]=76 → push 7
// 单调递减栈:找右侧第一个更大元素
void next_greater(const int* A, int n, int* result) {
 int* stk = malloc(n * sizeof(int));
 int top = 0;
 for (int i = 0; i < n; i++) {
 while (top > 0 && A[i] > A[stk[top - 1]]) {
 result[stk[--top]] = i; // 当前元素是栈顶的"第一个更大"
 }
 stk[top++] = i;
 }
 while (top > 0)
 result[stk[--top]] = -1; // 无更大元素
 free(stk);
}
时间复杂度 —— 每个元素入栈一次、出栈至多一次,总操作数不超过 。这是均摊分析在栈上的典型应用。
单调栈揭示了一个深层原理:需要比较”前后元素关系”的问题,往往可以通过维护一个单调序列来避免 的朴素扫描。从直方图最大矩形到每日温度,单调栈是这类问题的统一解法框架。
实现
基于数组的栈(顺序存储方式)
一,声明和初始化
首先要先创建栈的数据结构体。
typedef struct{
  int*data;         //一个指针,也可以用数组来表示。
  size_t top;      //栈顶指针,始终指向栈顶,其实是下标数字来表示
}Stack;
这里使用int * data,是一个指针,在基于数组的栈里,我们的操作是对于数组的限制化操作,用指针来代指数组里的位置,是动态数组操作的标志。
其实还可以用下面更加易于理解的方式。
typedef struct{
  int data[100];  //这里用静态数组直接表示,但是有空间限制
  size_t top;  //栈顶指针不变
}Stack;
使用静态数组表示,有空间限制,要标明空间大小,若不然无法控制溢出边界
声明栈
无论是那种顺序栈,静态还是动态,在创建好之后需要对其声明
在主函数里使用结构体的变量创建对象。
直接使用
Stack S;即可
初始化操作
void Init(Stack *S){
  S.top=-1;
}
初始化操作的逻辑是让栈顶指针指向空处。
在链表中,所有操作都是针对栈顶指针进行操控的,栈顶指针始终指向栈顶。
因此初始化只需要让指针指向的“顶部”赋值为指定值即可。
实际上,在一些可变化的栈设定里,对顶部赋值是一定需要的,若不然,指针会变为野指针,整个栈都会失效。而赋值操作是随意,并不一定要为-1,可以是任意数
注意:静态数组里确定空间大小,指针赋值一定要小于最大值-1
在一般初始化逻辑里有两种操作,一种就是如上所示,赋值为-1,加下来的数组空间是,整个数组大小,从下标0开始,符合数组逻辑
还有一种如下:
void Init(Stack *S){
S.top=0;
}
是按照数学和日常逻辑来的,将0设定为无,统计从1开始,接下来的操作也是按照数组下标+1的逻辑进行。
top指针指向的是插入元素的位置。
二,进栈与出栈
进栈
新元素入栈的逻辑思路很简单。就是指定让新的栈顶为你所准备的值。
根据上方的两种不同初始化思路,其入栈思路也不同。
S.top=-1的那种,思路如下:
bool Push(Stack* S,ElemType x){  //EltmType在这里可以换成任意实际需要的数据类型,比如int
  S.top ++;
  S.data[S.top]=x;
}
首先让栈顶指针进一位,此时新的top指向的位置是空的,这个时候对其进行赋值,就是我们准备好的x值
可以写成一个操作来简化流程:
S.data[++S.top]=x; //先自增,所以++放在前面而S.top=0的思路里,顺序相反,因为top指针指向的是插入元素的位置,所以先进行赋值,再进行进位。如下:
S.data[S.top++]=x;动态操作和静态操作思路一样,唯一区别在于边界判断。
边界判断
在进行入栈时,为了防止溢出,要优先进行边界判断,看看栈是否已满。
静态下的两种判断方式:
if(S.top==MAX-1)return false; //Max是数组的最大值,这是S.top初始化为=-1的情形。数组的最大下标是Max-1,因此当判断此时指针就是这个值的时候,已经最大了,无法进一位。
而如果设定top为输入位置呢?情况是另一种,
if(S.top==MAX)false;当是栈顶的下一位的时候,才判定已经满了。
接下来是动态的边界判断
理论上动态数组从堆上分配内存,空间大小取决于硬件设施。
因此我们需要自己定义一个静态的最大边界。手动检查是否越过最大值。
if(S.top == S.MAX)判断区别与上方静态一样,S.top一开始是-1就是当等于时返回,如果是0则只赋值,不进位。
实际上就算进位也没有影响,在堆上是没有硬性最大值的。
出栈
在栈的逻辑力,进出栈只能在栈顶操作,所以出栈只能找到最上层的数据。
而想让最上层离开,最基本的思路就是指针向下移动一位,保证栈顶是原本栈顶的下一位。
而判断方式则是判断当前是不是在栈底部。
有的时候栈底初始化不一样,操作顺序也不一样。比如S.top=-1的情况如下:
bool pop(Stack*S,ElemType x){
x=S.data[S.top--];
}
因为top是指向栈顶的,所以优先取值,再进行下移。
那么同理,如果S.top=0则要相反:
bool pop(Stack*S,ElemType x){
x=S.data[--S.top];
}
边界判断的思路如下:
在S.top=-1的情况下,判断S.top是否为栈底,也就是top是否为-1。
如果是则返回。
在S.top=0的情况下,判断S.top是否为0,如果是则返回。
动态和静态在出栈思路一致。
获取栈顶值
bool pop(Stack*S,ElemType x){
x=S.data[S.top];
}
//或者
bool pop(Stack*S,ElemType x){
x=S.data[S.top-1];
}
三,清空栈与销毁栈
清空栈的思路就是让所有东西都回到远点。
比如我们top指针已经在n了,需要让他重新指向-1或0,对于动态数组,还需要释放中途调用的指针。
bool clear(Stack*S){
S.top=-1;
}
不用特意清空数组,重新操作又是栈顶操作,会继续覆盖。逻辑上不会报错。
但是要不没被覆盖的部分已经被写好了数据,也会会有信息泄露的风险,可以配合循环遍历函数,使其全部赋值为空。
for(size_t i=-1;i<Max;i++){
  S.data[i]=0;
}
亦或者使用封装库
void clear(int *a, size_t n) {
    memset(a, 0, n * sizeof(*a));
}
如果数组作为函数传参,也就是动态分析下,其已经退化为指针,不能再用sizeof求长度,可以使用指针赋值为空的操作来做到归零操作。
free(p);
p = NULL;                  // 释放
静态分配的栈是无法进行整个销毁的,不过可以完全清空,也能释放所有内存。
而想要真正做到销毁整个栈,需要进行动态分配。
比如CPP里的
Stack *S = new Stack; //或者stack();

delete[] S->data;    //先释放内部数组。
delete S;
S=nullptr;      //防止悬空指针。
在C里
Stack*S = malloc(sizeof(Stack*));

free(S->data); //先释放内容
S->data=NULL;
free(S);
销毁和完全清空不完全一样,销毁是释放全部内存,包括栈,后续无法再使用。
而安全清空,也就是完全清空,是不销毁指针的,只把有效数据清空,后续还可以使用。
完整实现:
这里是动态数组的完整实现,静态数组过于简单,这里不做示范
#include <stdlib.h>

typedef struct {
 int* data;
 size_t capacity;
 size_t top; // 指向下一个空位,也是元素个数
} ArrayStack;

void as_init(ArrayStack* s) {
 s->data = NULL;
 s->capacity = 0;
 s->top = 0;
}

void as_destroy(ArrayStack* s) {
 free(s->data);
 s->data = NULL;
 s->capacity = s->top = 0;
}

static int as_expand(ArrayStack* s) {
 size_t new_cap = s->capacity == 0 ? 8 : s->capacity * 2;
 int* new_data = realloc(s->data, new_cap * sizeof(int));
 if (!new_data) return -1;
 s->data = new_data;
 s->capacity = new_cap;
 return 0;
}

int as_push(ArrayStack* s, int value) {
 if (s->top >= s->capacity)
 if (as_expand(s) != 0) return -1;
 s->data[s->top++] = value;
 return 0;
}

int as_pop(ArrayStack* s) {
 if (s->top == 0) return -1;
 s->top--;
 return 0;
}

int as_top(const ArrayStack* s, int* out) {
 if (s->top == 0) return -1;
 *out = s->data[s->top - 1];
 return 0;
}
顺序栈的两种栈顶指针约定(易错点)
顺序栈所有的判空、判满、入栈、出栈都依赖 top 的初值约定。教材主要有两种流派,做题第一步必须先看清题目用的是哪一种:
| 约定 | top 的初值 | top 指向 | 判空 | 判满(容量 MaxSize) | 入栈 | 出栈 |
|---|---|---|---|---|---|---|
| 约定 A(主流) | -1 | 栈顶元素 | top == -1 | top == MaxSize - 1 | S[++top] = x | x = S[top--] |
| 约定 B | 0 | 下一个可写位置 | top == 0 | top == MaxSize | S[top++] = x | x = S[--top] |
两种约定都能正确工作,但判界的表达式与代码完全互换:约定 A 的 ++top/top-- 到了约定 B 就成了 top++/--top。本节”基于动态数组的栈”用的是约定 B(top 指向下一个空位,同时也是元素个数)。408 选择题常给出其中一种约定,让你写出另一操作的语句或判断边界,务必按题给约定推导,不要凭记忆套公式。
记忆抓手:约定 A 的
top是”元素下标”,所以空在-1、满在MaxSize-1;约定 B 的top是”元素个数”,所以空在0、满在MaxSize。
基于链表的栈
链表版栈所有操作均在头部——单向链表的 push_front + pop_front:
简单的说,链栈就是单向链表,且只在顶部(也就是链表的尾部)进行操作,自然分出有无头结点的区别。具体在出栈还有初始化上
一,创建与初始化
其实可以参照D_链表_LinkedList里的相关知识,这里简单引述:
首先定义链表类型的结构体。
typedef struct SNode{
  int data;
  struct SNode* next;
}SNode;
不带头结点的初始化。
SNode *top=NULL;带头节点的初始化。
Snode *initStack(void) {
    Snode *head = (Snode *)malloc(sizeof(Snode));
    head->next = NULL;
    return head;
}
二,入栈还有出栈
不带头结点的:
简单来说,链栈有一个头指针,始终指向顶部,要想入栈,就需要新增加节点,然后让头指针指向它,做到更新顶部。
void push(SNode **top,int val){
  SNode *newNode=(SNode*)malloc(sizeof(SNode));
  newNode->data=val;
  newNode->next=*top;
  *top=newNode;
}
SNode** top就是那个顶部的头指针
让新节点指向这个头指针位置,然后更新头指针指向这个新节点。和不带头结点的单链表使用头插是一样的思路。
同理,出栈的话需要保存栈顶节点,然后让指针右移,从而做到去掉顶部。
void pop(SNode **top,int *out){
  SNode *tmp=*top; //创建指针指向顶部
  *out=tmp->data; //获取顶部值
  *top=tmp->next; //头指针右移
  free(tmp);  //销毁指针
}
从这里就可以知道为什么要使用头插单链表来模拟栈而不是尾插了。单链表里每个节点只能获知后一位节点的信息,同样,在只有一个节点的情况下,只能通过后移来进行跳跃,更新指针。
更具体一点的例子:
假如你有一个指针p,一个链表的某个节点Q,p指向Q(p=Q),因为你只能得到Q的下一位,也就是Q->next,而不能得到Q的上一位,所以要想变换指针p,只能做到p=p->next,或者更加往后的p=p->next->next,而做不到往前。
因此使用头插还有头删。
可以尝试使用尾插法的链表变体来模仿链栈。但是相对麻烦,除了示例,或一些特殊场景,否则很少使用。
带头结点:
入栈操作和单向链表的头插是一样的:
void push(Snode *head, int val) {
    Snode *newNode = (Snode *)malloc(sizeof(Snode)); //创建新节点
    newNode->data = val;
    newNode->next = head->next;   // 新结点指向原栈顶,记住是head->next,head是空节点
    head->next = newNode;         // 头结点指向新栈顶
}
同理出栈操作也是一样的:
void pop(Snode *head, int *out) {
    Snode *tmp = head->next;          //创建指针指向顶部位置
    *out = tmp->data;                  //存储值
    head->next = tmp->next;         //头指针指向原顶部下一位
    free(tmp);                       //销毁指针
}
三,清理和销毁栈
清空和销毁不一样,清空释放所有数据节点,最后要求:所有节点被释放,top == NULL,栈还能使用可以接着push,销毁则不能继续使用。
在不带头结点的链栈里,所有节点都是数据节点,没有额外的头结点,所以清空和销毁的代码基本一样。
不带头节点的清空:
循环释放所有数据结点,最后 top = NULL
清空后:
所有结点被释放;
top == NULL;
栈还能继续用,可以继续 push。
void clearStack(Snode **top) {
    Snode *p = *top;
    while (p != NULL) {
        Snode *tmp = p;
        p = p->next;
        free(tmp);
    }
    *top = NULL;
}
不带头结点的销毁
不带头结点的链栈里,所有结点都是数据结点,没有额外的头结点。
void destroyStack(Snode **top) {
    clearStack(top);
}
带头节点的清空:
释放所有数据结点,但保留头结点
清空后:
数据结点全部释放;
头结点还在;
head->next == NULL;
栈还能继续用。
void clearStack(Snode *head) {
    if (head == NULL) return;

    Snode *p = head->next;
    while (p != NULL) {
        Snode *tmp = p;
        p = p->next;
        free(tmp);
    }
    head->next = NULL;
}
带头结点的销毁:
先释放所有数据结点,再释放头结点,最后把头指针置空
销毁后:
所有结点包括头结点都被释放;
外部 head == NULL;
栈不能再使用。
void destroyStack(Snode **head) {
    if (head == NULL || *head == NULL) return;

    Snode *p = (*head)->next;
    while (p != NULL) {
        Snode *tmp = p;
        p = p->next;
        free(tmp);
    }

    free(*head);      // 释放头结点
    *head = NULL;     // 外部头指针置空
}
具体实现(不带头结点):
带头结点的版本可以自行实现
#include <stdlib.h>

typedef struct SNode {
 int data;
 struct SNode* next;
} SNode;

typedef struct {
 SNode* head;
 size_t count;
} LinkedStack;

void ls_init(LinkedStack* s) { s->head = NULL; s->count = 0; }

void ls_destroy(LinkedStack* s) {
 while (s->head) {
 SNode* tmp = s->head;
 s->head = s->head->next;
 free(tmp);
 }
 s->count = 0;
}

int ls_push(LinkedStack* s, int value) {
 SNode* node = malloc(sizeof(SNode));
 if (!node) return -1;
 node->data = value;
 node->next = s->head;
 s->head = node;
 s->count++;
 return 0;
}

int ls_pop(LinkedStack* s) {
 if (!s->head) return -1;
 SNode* tmp = s->head;
 s->head = s->head->next;
 free(tmp);
 s->count--;
 return 0;
}
两栈共享空间(双端栈)
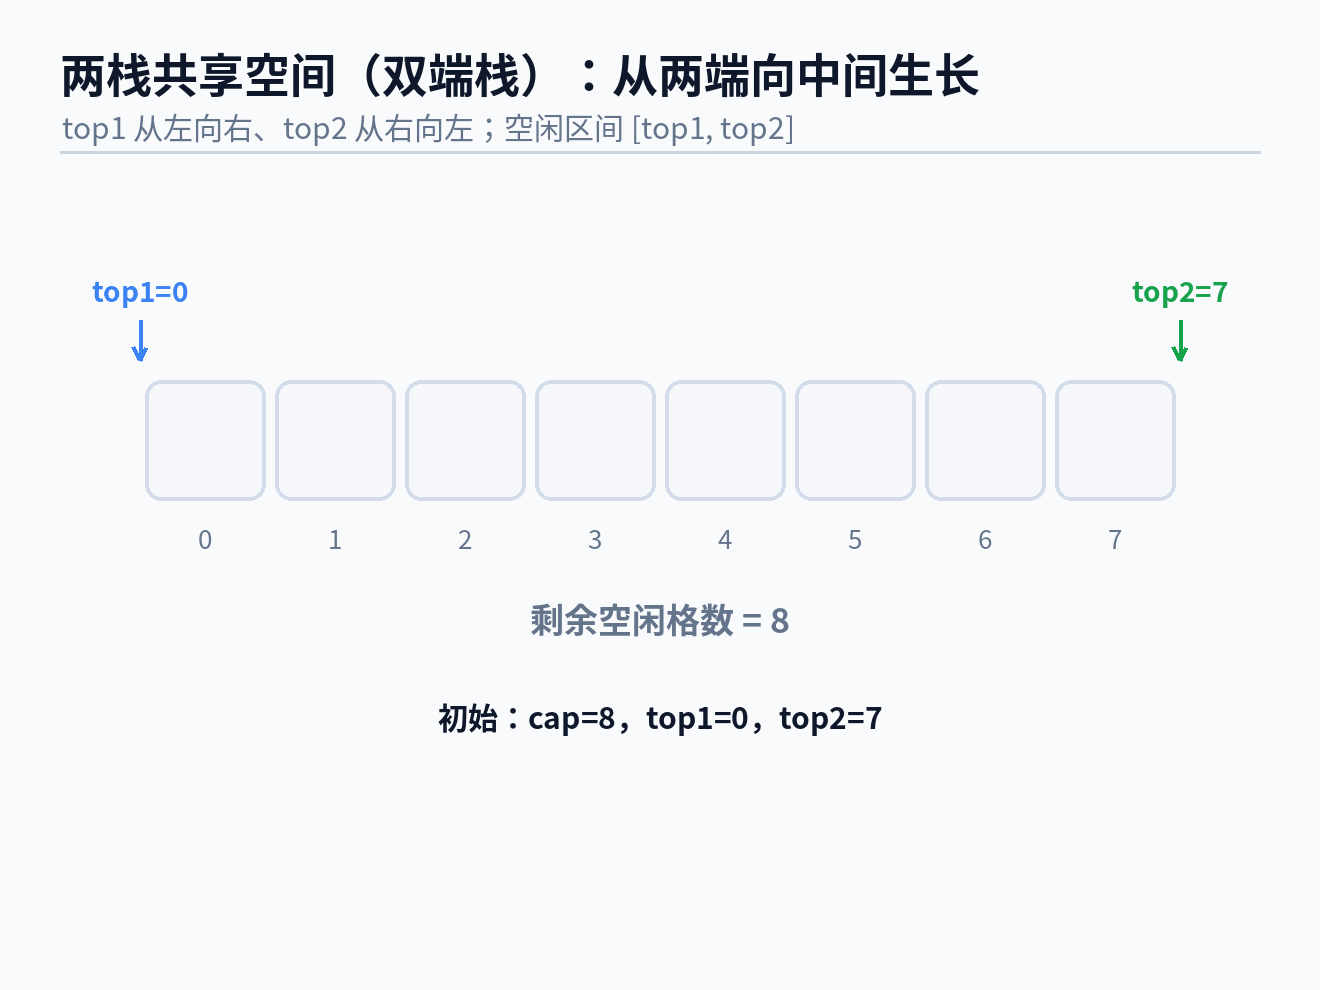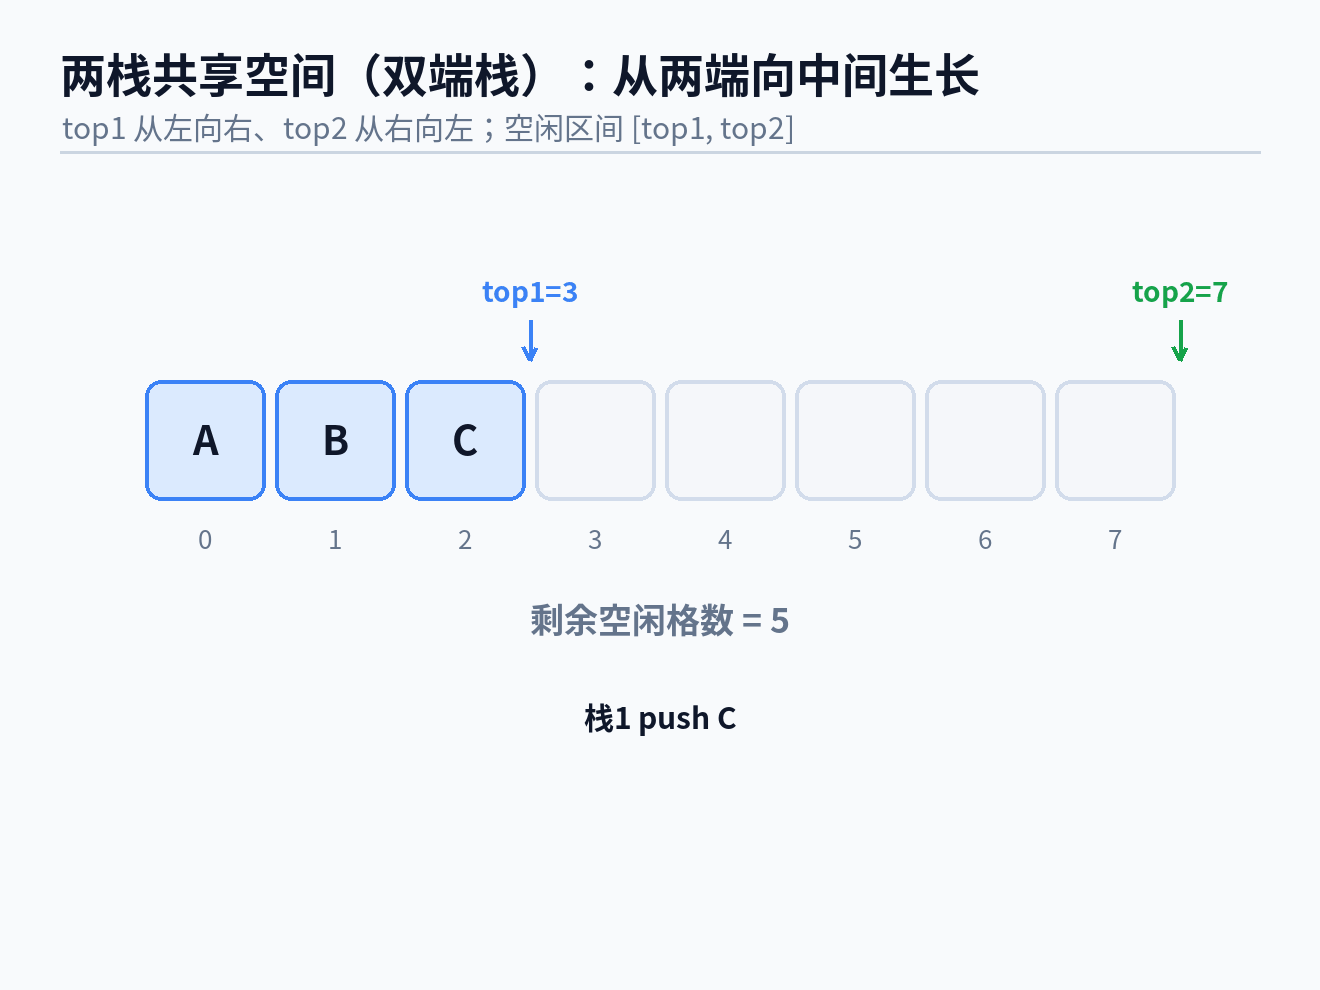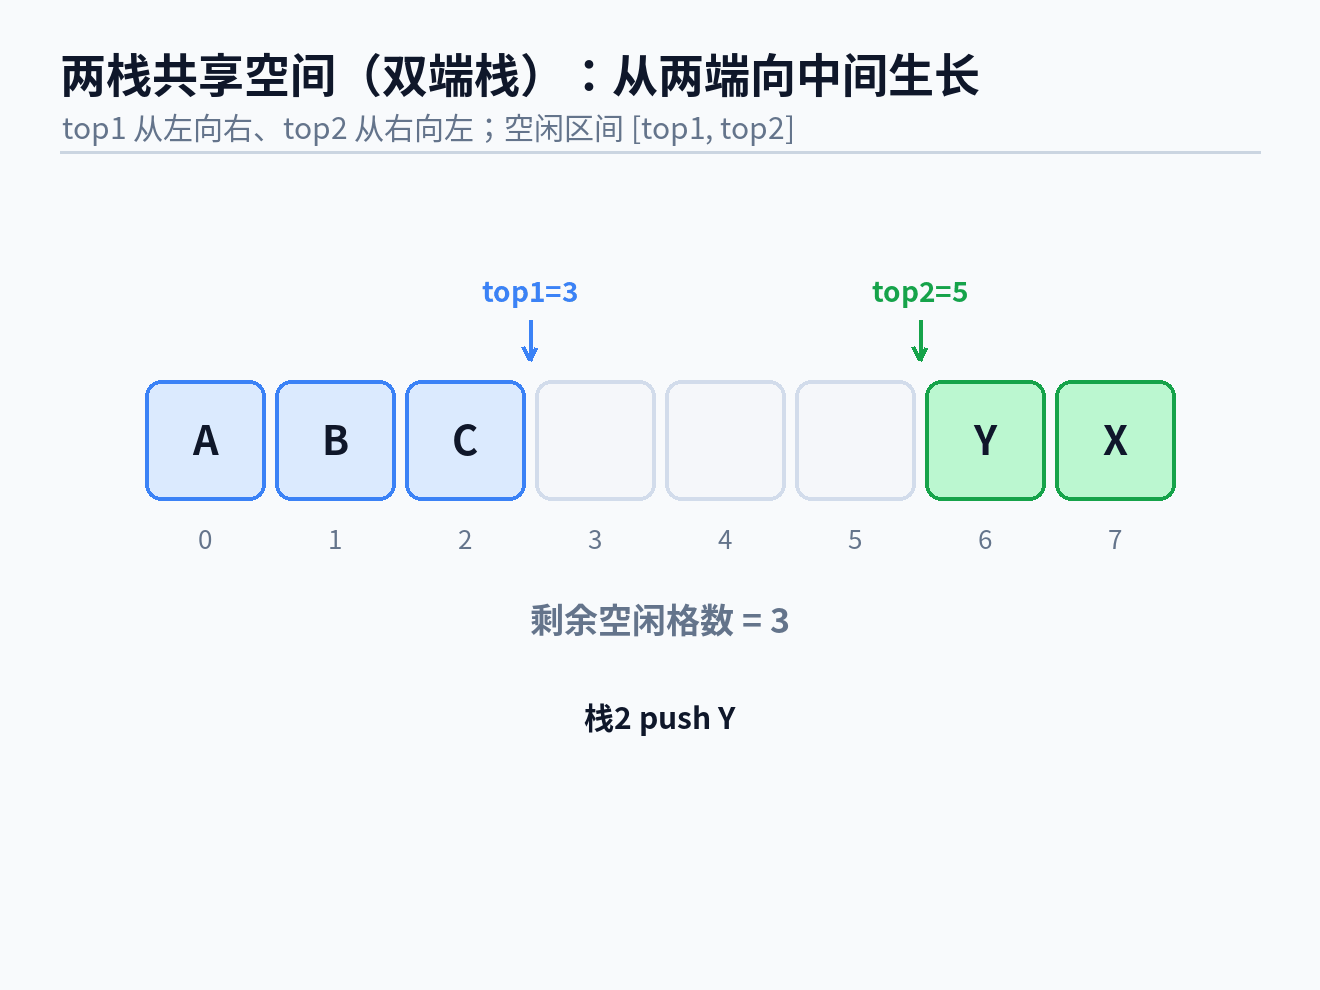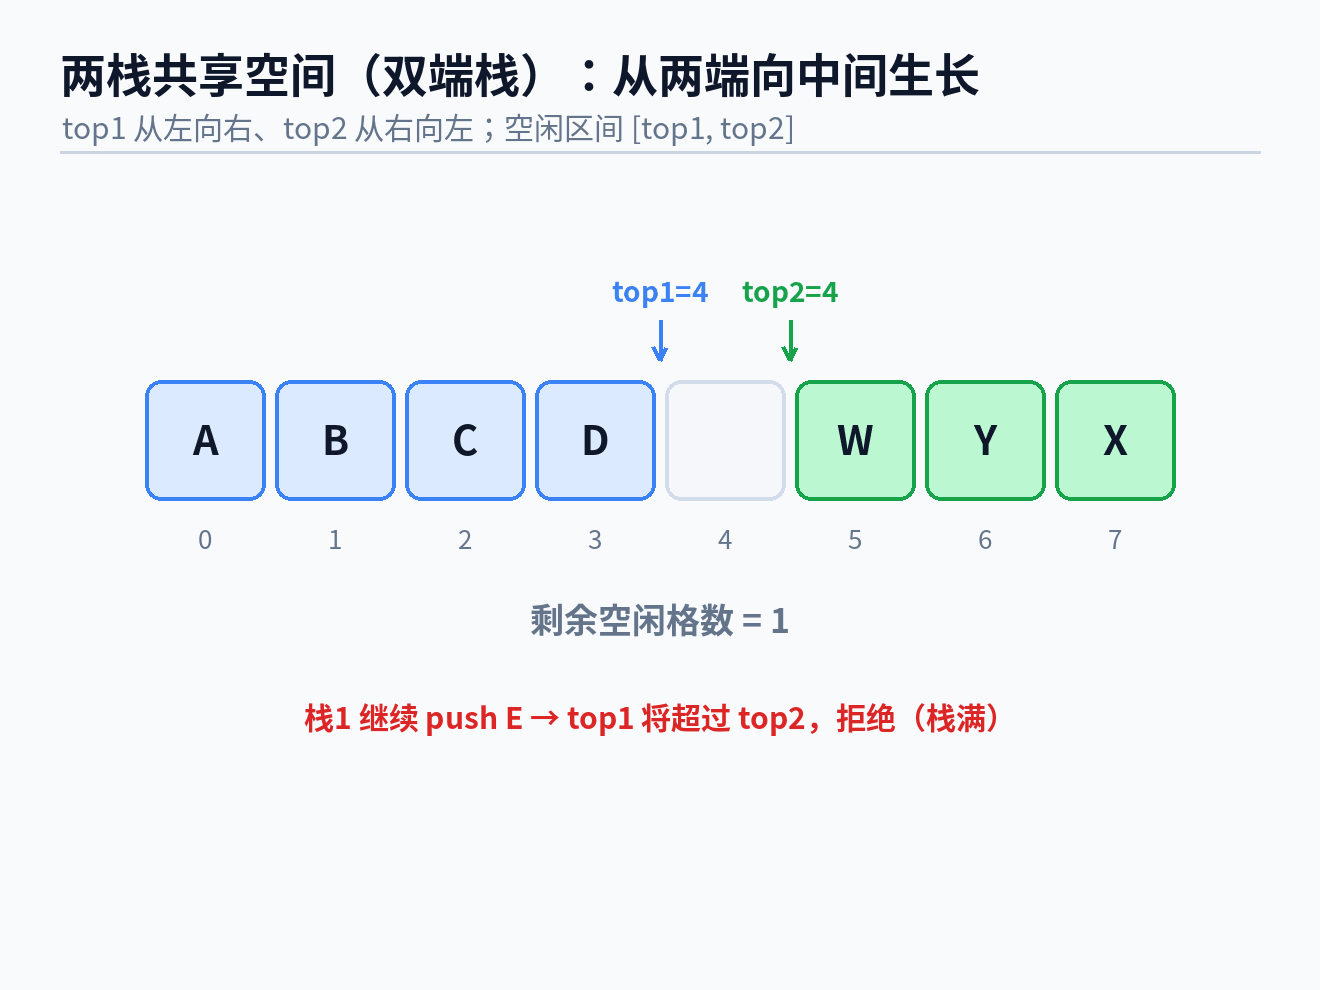
固定大小的内存区域里,两个栈从两端向中间生长,共享同一段空间——这是经典模型:
graph LR
 subgraph "双端栈 — 共享数组"
 direction LR
 PUSH1["Stack 1 →<br/>push → top1++"] -->|"← 空闲空间 →"| PUSH2["← Stack 2<br/>top2-- ← push"]
 end
typedef struct {
 int* data;
 size_t capacity;
 size_t top1; // Stack 1: 从左向右增长
 size_t top2; // Stack 2: 从右向左增长
} TwoStacks;

void ts_init(TwoStacks* ts, size_t cap) {
 ts->data = malloc(cap * sizeof(int));
 ts->capacity = cap;
 ts->top1 = 0;          // 栈 1 的下一个写入位(左端起)
 ts->top2 = cap - 1;    // 栈 2 的下一个写入位(右端起)
}

// push 到栈 1
int ts_push1(TwoStacks* ts, int value) {
 if (ts->top1 > ts->top2) return -1; // 两栈碰撞
 ts->data[ts->top1++] = value;
 return 0;
}

// push 到栈 2
int ts_push2(TwoStacks* ts, int value) {
 if (ts->top1 > ts->top2) return -1;
 ts->data[ts->top2--] = value; // 索引递减
 return 0;
}
三个必背结论(本代码的下标约定:top1 从 0 起、top2 从 cap−1 起,均指向”下一个写入位”):
栈满条件推导:空闲格是下标区间 ,共 个;它归零等价于 ,即代码里的碰撞检查。这种设计让两侧空间动态调剂——比对半分成两个独立数组更抗溢出,且全程无 realloc。
注意教材另有 top1=-1 / top2=cap 的”指向栈顶元素”约定,其判满为 、判空分别为 -1 与 cap——做题第一步先确认题目采用哪种初始值。
手算示范:cap=8,栈 1 压 3 次、栈 2 压 2 次 → top1=3,top2=5;空闲格 个,总元素 个。
自测:两栈共享
cap=10,栈 1 已压 4 次、栈 2 已压 3 次。① 当前还能再压几个元素?② 若此后只在栈 1 一侧继续压,压几次溢出?
答案:
① top1=4、top2=6,空闲格 个——两侧合计最多再压 3 个。
② 只压栈 1:top1 从 4 走到 7 时 触发拒绝,故能再压 3 次(top1=5、6 时都还满足 ,第 4 次被拒)。注意临界:top1==top2 时那一格仍可写入,属于最后的机会。
括号匹配:栈的第一应用
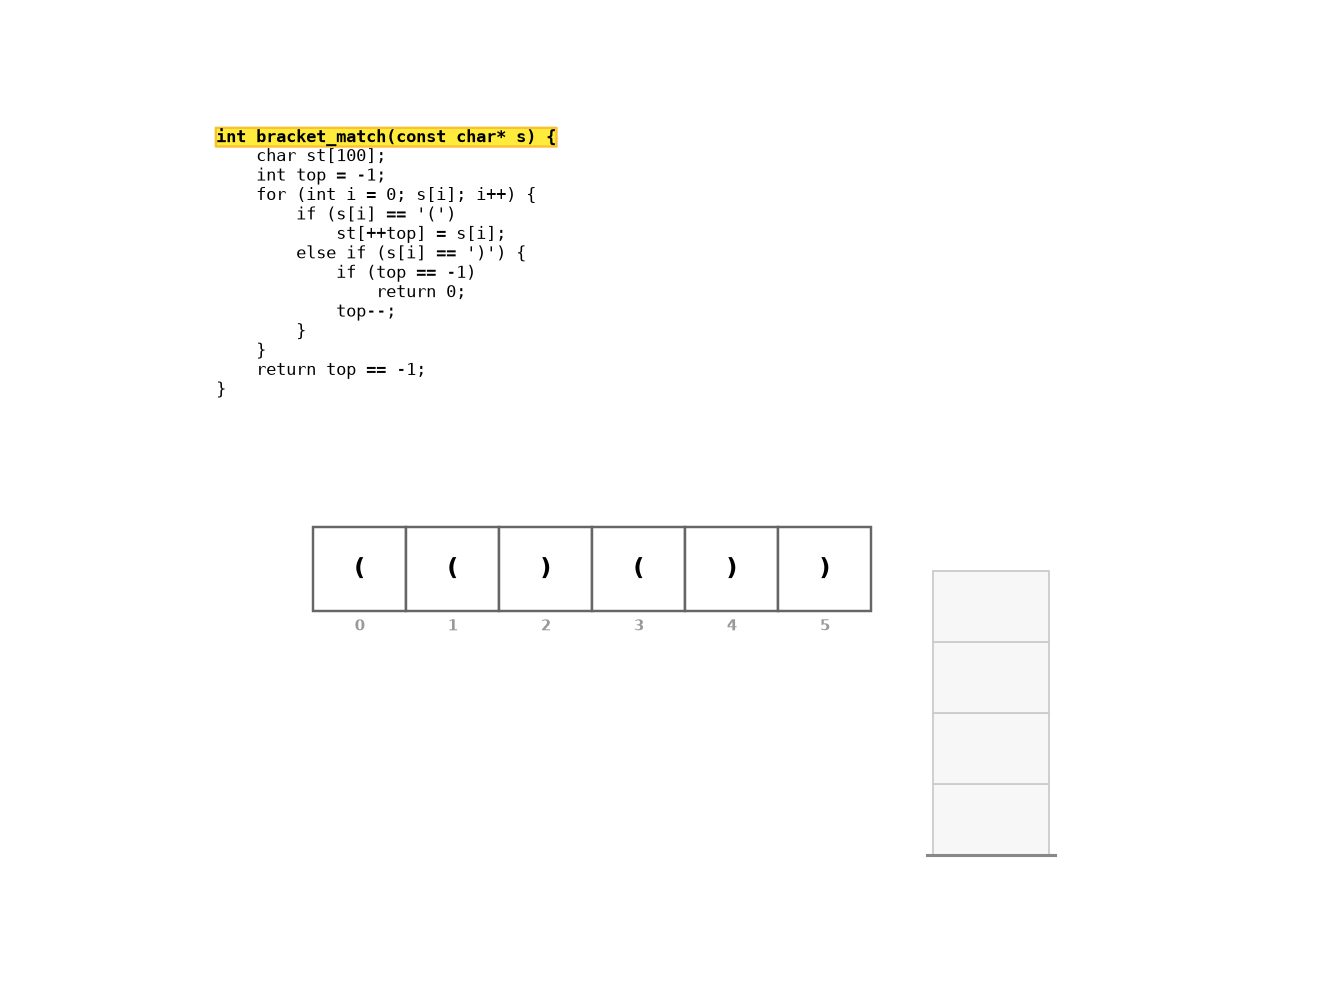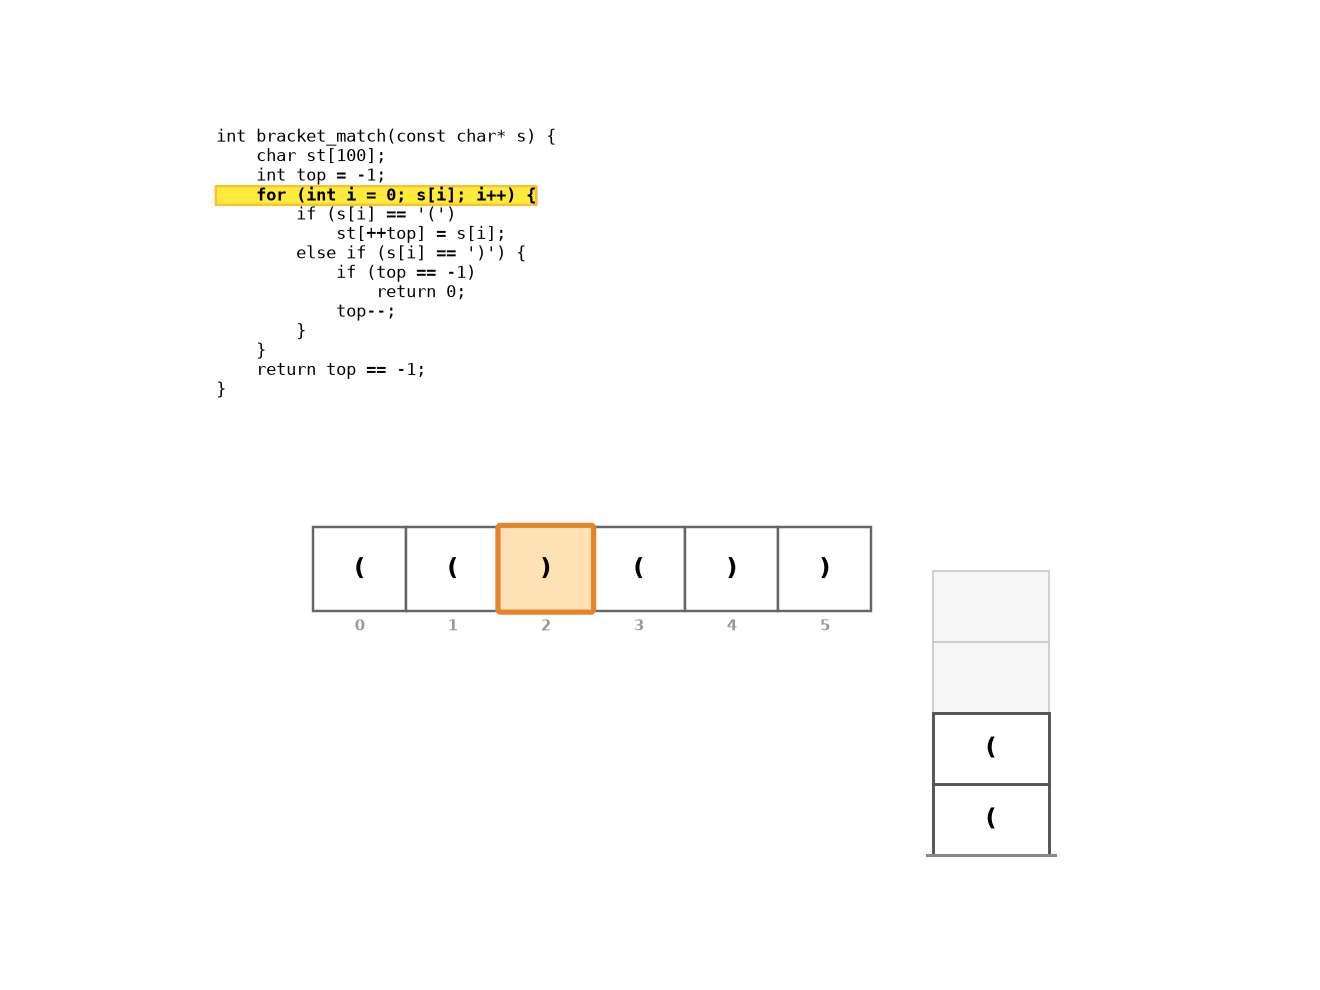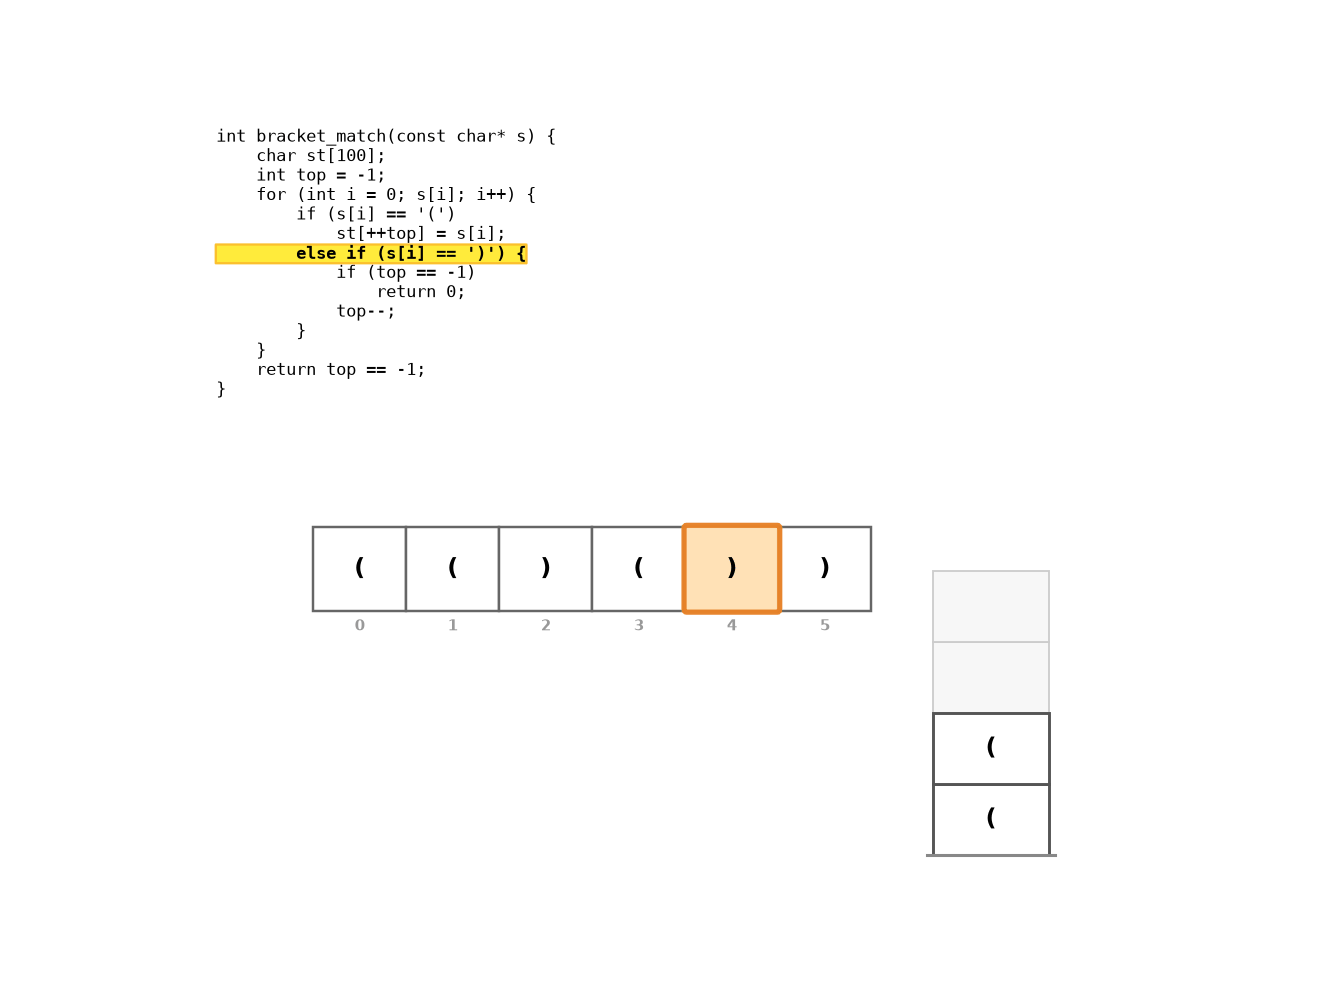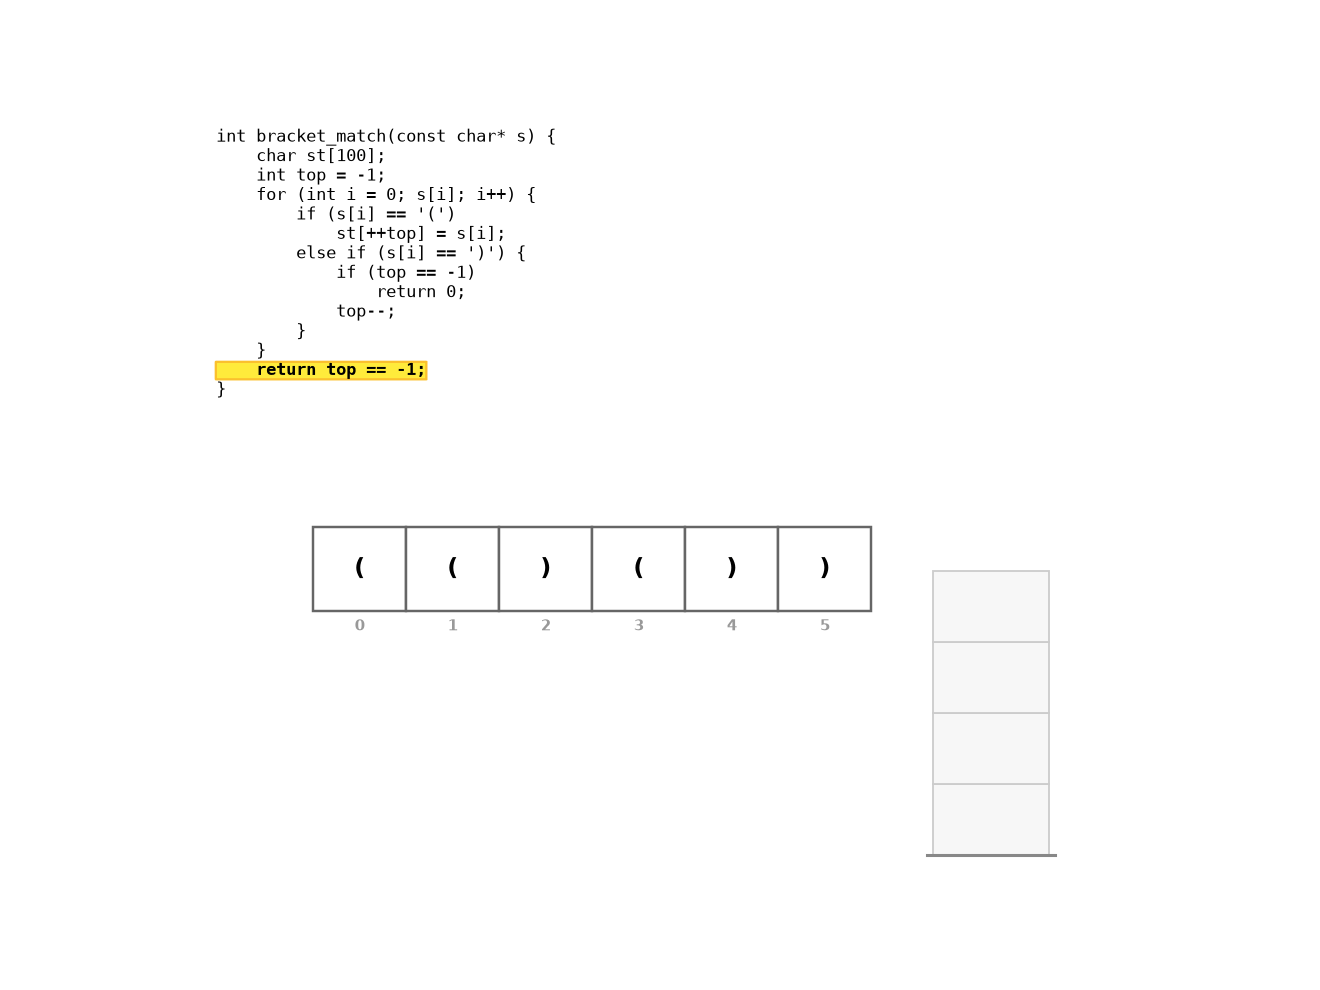
规则只有三条:左括号一律进栈;右括号到来时弹栈比对类型(( 配 )、[ 配 ]、{ 配 });扫描结束时栈必须为空。对应三种失败情形:
| 失败时机 | 错误类型 | 例 |
|---|---|---|
| 弹栈时类型不符 | 交叉嵌套 | ([)] |
| 栈空遇右括号 | 右括号多余 | ()) |
| 结束时栈非空 | 左括号多余 | (() |
int brackets_ok(const char* s) {
    char stk[256]; int top = 0;
    for (int i = 0; s[i]; i++) {
        char ch = s[i];
        if (ch == '(' || ch == '[' || ch == '{') {
            stk[top++] = ch;
        } else if (ch == ')' || ch == ']' || ch == '}') {
            if (top == 0) return 0;                    // 右括号多余
            char open = stk[--top];
            if ((ch == ')' && open != '(') ||
                (ch == ']' && open != '[') ||
                (ch == '}' && open != '{')) return 0;  // 类型交叉
        }
    }
    return top == 0;                                   // 结束时必须空
}手算轨迹:判定 {[()]}——
| 步 | 字符 | 动作 | 栈内容(底→顶) |
|---|---|---|---|
| 1 | { | 进栈 | { |
| 2 | [ | 进栈 | { [ |
| 3 | ( | 进栈 | { [ ( |
| 4 | ) | 弹 (,匹配 | { [ |
| 5 | ] | 弹 [,匹配 | { |
| 6 | } | 弹 {,匹配 | (空) |
结束时空栈 → 合法。反例 ([)]:第 3 步遇 ) 时弹出的却是 [,类型不符立即失败。
自测:括号匹配
① 判定 ([]{}) 的合法性并写出栈变化。
② 判定 ((] 在哪一步失败、属于哪种错误。
③ 若串中只含一种括号 (),能否用 空间判定合法性?
答案:
① 合法。轨迹:
(→([→]弹出后剩(→({→}弹出后剩(→)弹出后空;结束空栈,判定成立。
② 第 3 步失败:遇]时弹出的栈顶是(,类型不符——属于交叉嵌套错误(]只应配[)。
③ 可以。用一个计数器:左括号 +1、右括号 −1;中途出现负值(右多)或结束时非零(左多)即非法。这是栈在”只有一种括号”时的退化形式,也是面试的经典追问。
最小栈(MinStack)—— 用差值压缩空间
常规 MinStack 用两个同步栈(一个存数据,一个存前缀最小值)。更紧凑的做法是只存差值:栈内不存原始值,而存”当前值与当前最小值的差值”。
// 差值法:栈存储 value - min_sofar。通过差值的正负恢复 value 和 min
typedef struct {
 long* diff; // value - min_sofar (可能需要 long 防溢出)
 int* min_val; // 栈顶元素对应的当前最小值
 size_t capacity;
 size_t top;
} MinStackDiff;
此方案将空间从 2n 降至 n+1(只需 diff 数组和当前 min_val 变量),但每个 push 都涉及一次减法计算和溢出判断。常规的双栈法(空间 2n)因其简单性和无溢出风险,在实际工程中更为常用。
表达式求值
中缀 → 后缀(调度场算法)
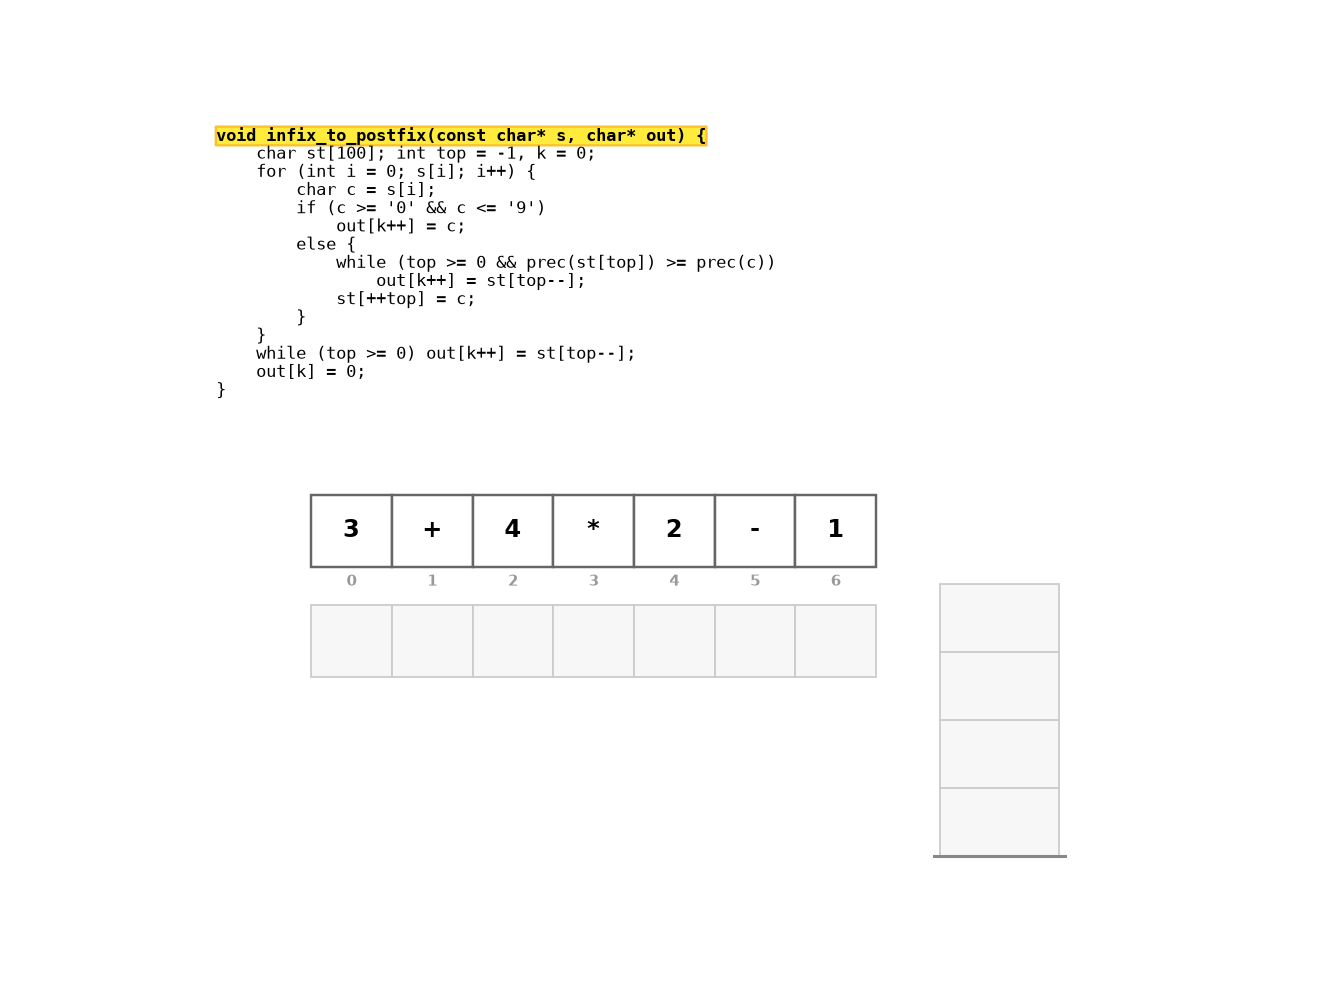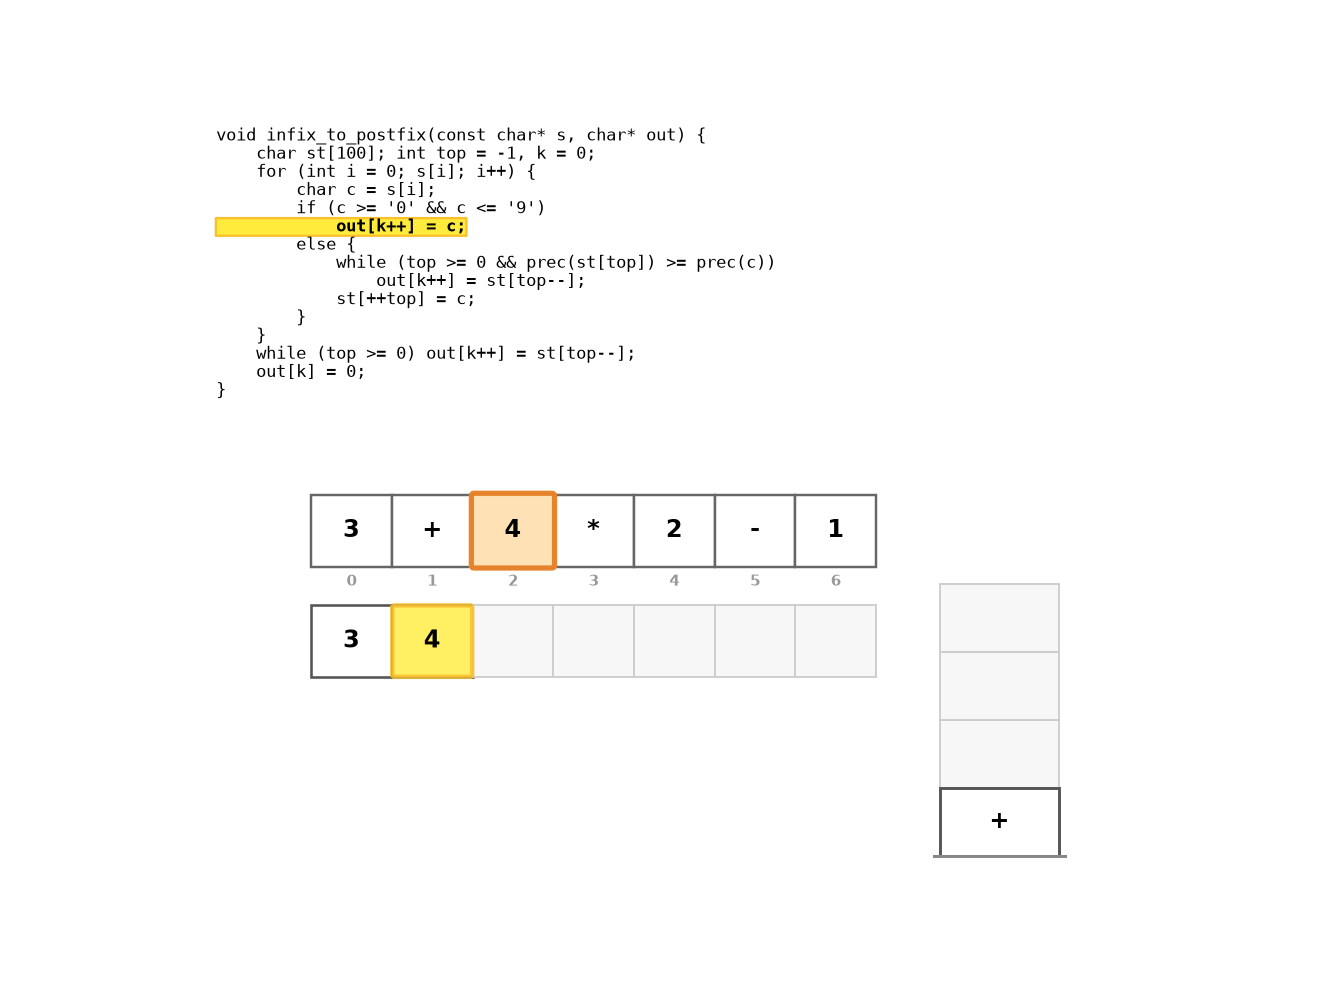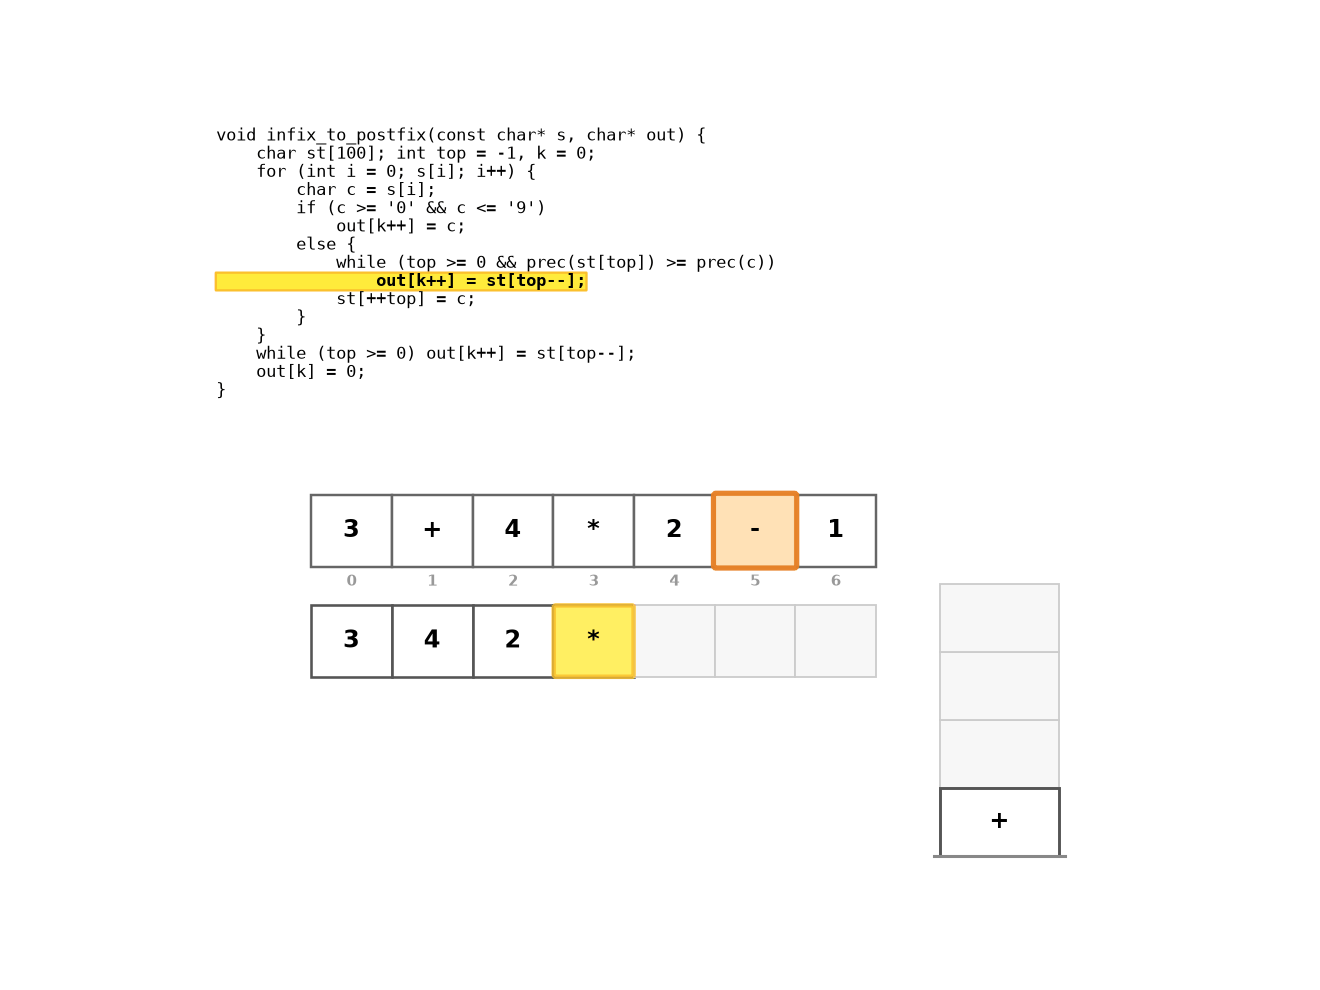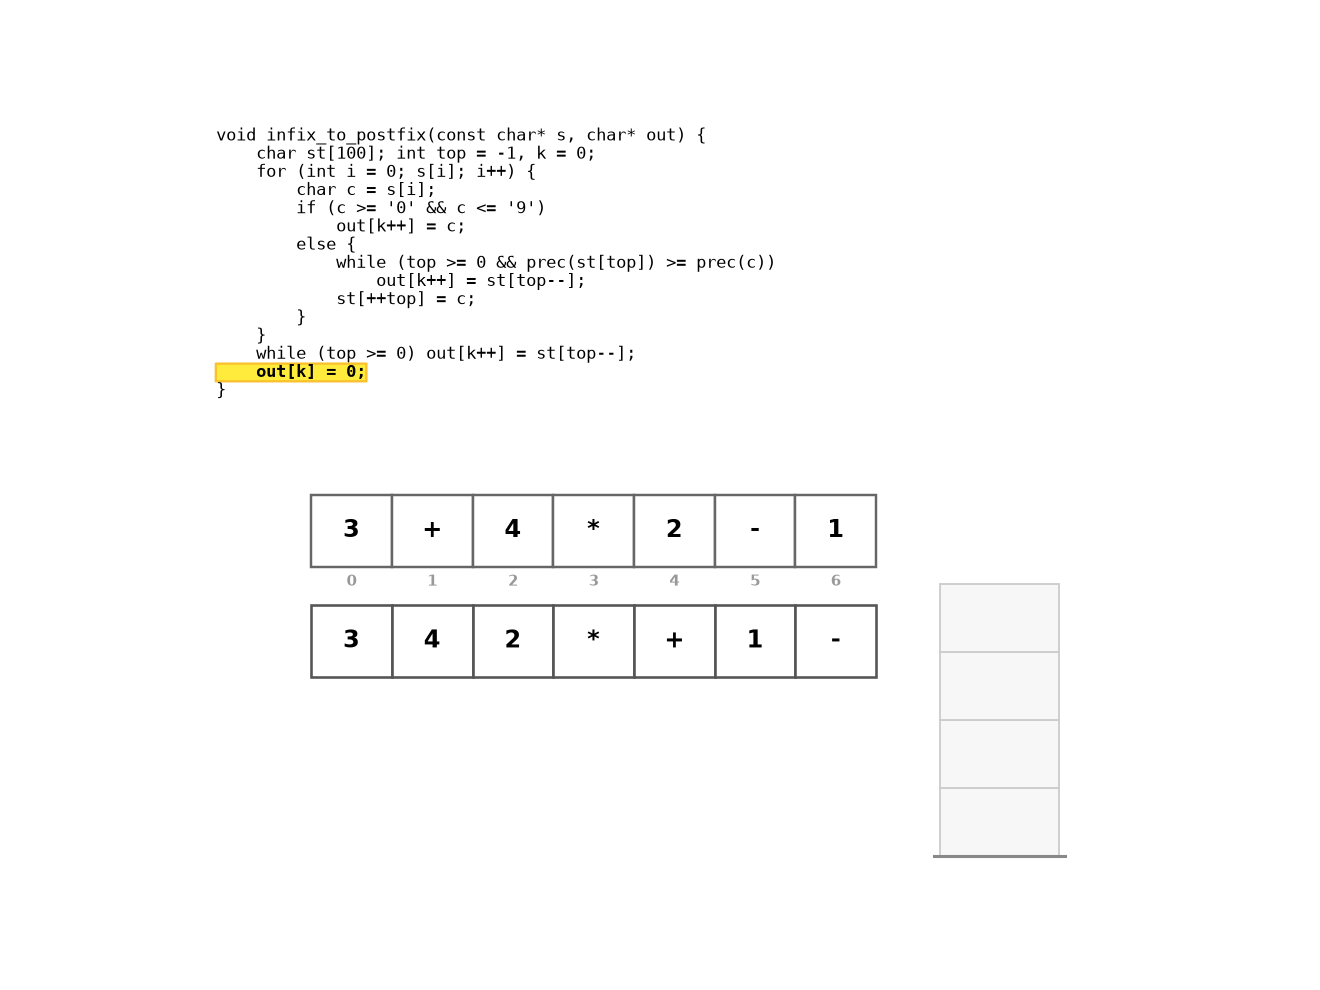
int precedence(char op) {
 if (op == '+' || op == '-') return 1;
 if (op == '*' || op == '/') return 2;
 return 0;
}

// 将中缀表达式转为后缀(RPN)表示
void infix_to_postfix(const char* expr, char* output) {
 int len = strlen(expr);
 char* stk = malloc(len);
 int top = 0, out_idx = 0;
 for (int i = 0; i < len; i++) {
 char ch = expr[i];
 if (ch >= '0' && ch <= '9') {
 output[out_idx++] = ch;
 } else if (ch == '(') {
 stk[top++] = ch;
 } else if (ch == ')') {
 while (top > 0 && stk[top - 1] != '(')
 output[out_idx++] = stk[--top];
 top--; // 丢弃 '('
 } else { // 运算符
 while (top > 0 && precedence(stk[top - 1]) >= precedence(ch))
 output[out_idx++] = stk[--top];
 stk[top++] = ch;
 }
 }
 while (top > 0)
 output[out_idx++] = stk[--top];
 output[out_idx] = '\0';
 free(stk);
}手算轨迹:把 9+(3-1)*3+10/2 转为后缀——逐步列出运算符栈与输出区:
| 步 | 读入 | 动作 | 运算符栈(底→顶) | 输出区 |
|---|---|---|---|---|
| 1 | 9 | 直接入输出 | (空) | 9 |
| 2 | + | 栈空,进栈 | + | 9 |
| 3 | ( | 进栈 | + ( | 9 |
| 4 | 3 | 入输出 | + ( | 9 3 |
| 5 | - | 栈顶是 (,进栈 | + ( - | 9 3 |
| 6 | 1 | 入输出 | + ( - | 9 3 1 |
| 7 | ) | 弹栈输出至 (:弹出 -,丢弃 ( | + | 9 3 1 - |
| 8 | * | 栈顶 + 优先级低,进栈 | + * | 9 3 1 - |
| 9 | 3 | 入输出 | + * | 9 3 1 - 3 |
| 10 | + | 弹出 *、+(均 ≥ 新运算符),再进栈 | + | 9 3 1 - 3 * + |
| 11 | 10 | 入输出 | + | 9 3 1 - 3 * + 10 |
| 12 | / | 栈顶 + 优先级低,进栈 | + / | 同上 |
| 13 | 2 | 入输出 | + / | ... 10 2 |
| 14 | 结束 | 连续弹栈:先 / 后 + | (空) | 9 3 1 - 3 * + 10 2 / + |
最终后缀式 9 3 1 - 3 * + 10 2 / +。三个关键规则对照表格记忆:括号内的运算符被 ( 保护(第 5 步 - 得以压在 + 上);弹栈条件是”栈顶优先级 ≥ 当前”(左结合);) 触发一次性清到 ( 为止。
自测:写出 (a+b)*c-d 的后缀式。
答案:
a b + c * d -。轨迹要点:)把+弹入输出;*进栈后遇到-,因*≥-先弹*再压-;结尾弹-。
后缀表达式求值
// 计算后缀表达式(操作数为单个数字 0-9)
int eval_postfix(const char* postfix) {
 int len = strlen(postfix);
 int* stk = malloc(len * sizeof(int));
 int top = 0;
 for (int i = 0; i < len; i++) {
 char ch = postfix[i];
 if (ch >= '0' && ch <= '9') {
 stk[top++] = ch - '0';
 } else {
 int b = stk[--top]; // 弹出右操作数
 int a = stk[--top]; // 弹出左操作数
 switch (ch) {
 case '+': stk[top++] = a + b; break;
 case '-': stk[top++] = a - b; break;
 case '*': stk[top++] = a * b; break;
 case '/': stk[top++] = a / b; break;
 }
 }
 }
 int result = stk[0];
 free(stk);
 return result;
}
sequenceDiagram participant Input as 输入: "3 4 2 * +" participant Stack as 求值栈 Input->>Stack: push 3 Note over Stack: [3] Input->>Stack: push 4 Note over Stack: [3, 4] Input->>Stack: push 2 Note over Stack: [3, 4, 2] Input->>Stack: op '*': pop 2, pop 4 Note over Stack: [3] Input->>Stack: push 8 (4*2) Note over Stack: [3, 8] Input->>Stack: op '+': pop 8, pop 3 Note over Stack: [] Input->>Stack: push 11 (3+8) Note over Stack: [11 ← 结果]
前缀表达式(波兰表达式)的转换与求值
后缀(逆波兰)由 Lukasiewicz 提出,前缀(波兰)也是同一思想:运算符写在操作数之前。例如中缀 1 + 2 的前缀式是 + 1 2。三种记法对照:
| 中缀 | 前缀(波兰) | 后缀(逆波兰) |
|---|---|---|
a + b | + a b | a b + |
(a + b) * c | * + a b c | a b + c * |
a + b * c | + a * b c | a b c * + |
前缀式没有括号且求值方向从右向左:从右往左扫描,遇到操作数就压栈,遇到运算符就弹出两个操作数(先弹出的是左操作数)做运算,再把结果压栈。以 - * + 3 4 5 6(即 ((3+4)*5)-6)为例:
| 扫描(右→左) | 动作 | 栈(底→顶) |
|---|---|---|
6 | 压栈 | 6 |
5 | 压栈 | 6 5 |
4 | 压栈 | 6 5 4 |
3 | 压栈 | 6 5 4 3 |
+ | 弹 3、4 → 3+4=7 | 6 5 7 |
* | 弹 7、5 → 7×5=35 | 6 35 |
- | 弹 35、6 → 35−6=29 | 29 |
// 前缀(波兰)表达式求值:从右向左扫描
int eval_prefix(const char* prefix) {
    int len = strlen(prefix);
    int* stk = malloc(len * sizeof(int));
    int top = 0;
    for (int i = len - 1; i >= 0; i--) {
        char ch = prefix[i];
        if (ch == ' ') continue;
        if (ch >= '0' && ch <= '9') {
            stk[top++] = ch - '0';
        } else {
            int a = stk[--top];   // 先弹出的是左操作数
            int b = stk[--top];
            switch (ch) {
                case '+': stk[top++] = a + b; break;
                case '-': stk[top++] = a - b; break;
                case '*': stk[top++] = a * b; break;
                case '/': stk[top++] = a / b; break;
            }
        }
    }
    int result = stk[0];
    free(stk);
    return result;
}
中缀 → 前缀(两种写法都要会):
- 先转后缀、再翻前缀(适合手算):把中缀表达式整体倒序(同时交换左右括号),当成普通中缀转后缀得到后缀式,再把这个后缀式整体倒序,即为前缀式。
例:a + b * c→ 倒序得c * b + a→ 转后缀得c b * a +→ 再倒序得+ a * b c✅ - 双栈法(适合写代码):一个操作数栈、一个运算符栈,从右向左扫描;遇到操作数入操作数栈,遇到运算符按优先级弹栈,最后把两栈拼成”运算符 + 左操作数 + 右操作数”。
408 与期末题里,中缀转前缀的要求出现得比后缀少,但”给中缀写前缀/给前缀求值”很常见。记住对照:前缀 = 后缀整体倒序,只是运算符落在最左。
递归:逻辑与实现
递归与栈是同一件事的两面:递归 = 系统替你维护一个栈(见 递归如何映射到栈帧)。这一节从算法层面讲清”递归怎么想、怎么写、怎么分析、怎么改成循环”,考点提炼放在下面的 高频考点(含真题)。
递归的逻辑:先递推,再回归
一个递归算法把大问题化成同类型的小问题,过程分两个阶段:
- 递推(下行):不断把问题规模缩小,直到缩小到可以直接求解的最小规模;
- 回归(上行):从最小规模的结果出发,逐层把结果算回来,拼出原问题的解。
以 factorial(4) 为例:下行 4→3→2→1(递推),到 1 触发终止条件;上行 1→2→6→24(回归)。映射到调用栈,就是一路压栈再一路弹栈。递归成立的前提是:每缩小一次,问题都变成”同类型的更小问题”。
递归的三要素
- 终止条件(基准情形):满足时直接返回,不再递归;
- 递归部分(递归步):把问题规模缩小后调用自身;
- 收敛性:每次递归都让规模严格减小,保证有限步内到达终止条件。
缺终止条件 → 无限递归 → 栈溢出;缺收敛性 → 可能永远到不了终止条件。
递归的实现:四种典型写法
// ① 线性递归:每层一个递归调用(阶乘 / 求和)
long factorial(int n) {
    if (n <= 1) return 1;              // 终止条件
    return n * factorial(n - 1);       // 递归步
}

// ② 树形递归:每层多个递归调用(斐波那契 / 汉诺塔)
long fib(int n) {
    if (n <= 1) return n;
    return fib(n - 1) + fib(n - 2);
}
void hanoi(int n, char a, char b, char c) {
    if (n == 0) return;                // 终止条件
    hanoi(n - 1, a, c, b);             // 把上面 n-1 个从 a 借 c 移到 b
    printf("%c -> %c\n", a, c);        // 移动最大盘
    hanoi(n - 1, b, a, c);             // 再把 n-1 个从 b 借 a 移到 c
}

// ③ 分治递归:缩小后求解再合并(二分 / 归并)
int bsearch(int* a, int lo, int hi, int x) {
    if (lo > hi) return -1;
    int mid = lo + (hi - lo) / 2;
    if (a[mid] == x) return mid;
    return a[mid] < x ? bsearch(a, mid + 1, hi, x)
                      : bsearch(a, lo, mid - 1, x);
}

// ④ 回溯递归:试探 + 撤销(全排列 / N 皇后),是树形递归的变体
void permute(int* a, int k, int n) {
    if (k == n) { /* 输出一个排列 */ return; }
    for (int i = k; i < n; i++) {
        swap(&a[k], &a[i]);            // 选择
        permute(a, k + 1, n);          // 进入下一层
        swap(&a[k], &a[i]);            // 撤销(回溯)
    }
}
递归怎么改成非递归
| 方法 | 做法 | 适用 |
|---|---|---|
| 尾递归改循环 | 递归调用是最后一步且返回值不被后续使用,可改写成 while | 阶乘、累加、线性递归 |
| 显式栈模拟 | 用自定义栈保存”待处理的现场/返回点” | 二叉树遍历、DFS、快排、回溯 |
| 记忆化 / 动态规划 | 保存已求解的子问题,避免重复计算 | 斐波那契、背包、LCS |
| 队列层序展开 | 把递归的层序过程改成队列迭代 | BFS、层序遍历 |
任何递归都能用显式栈改写成迭代——这就是”栈消除递归”的含义;反过来,用栈模拟系统调用就是手动维护栈帧。
递归的复杂度怎么估
- 递归调用次数 = 递归树的结点数(决定时间);
- 递归深度 = 递归树的高度(决定空间,也就是系统栈的最大帧数)。
常用分析工具:递推方程 (主定理)、递归树展开、猜解归纳。
| 递归算法 | 递推关系 | 时间复杂度 | 空间(深度) |
|---|---|---|---|
| 阶乘 | |||
| 朴素斐波那契 | |||
| 汉诺塔 | |||
| 二分查找 | |||
| 归并排序 |
递归的优缺点
优点:代码简洁、贴近数学定义、天然契合分治 / 回溯 / 树形结构。
缺点:函数调用有开销、可能重复计算(朴素斐波那契)、递归过深会栈溢出、常数因子通常比迭代大。
高频考点(含真题)
这一节把栈的概念题与手算推演题集中起来,与正文的教学内容分开,便于考前对照复习。历年统考真题另见下一节 408 真题精选。
考点 1:出栈序列合法性判定
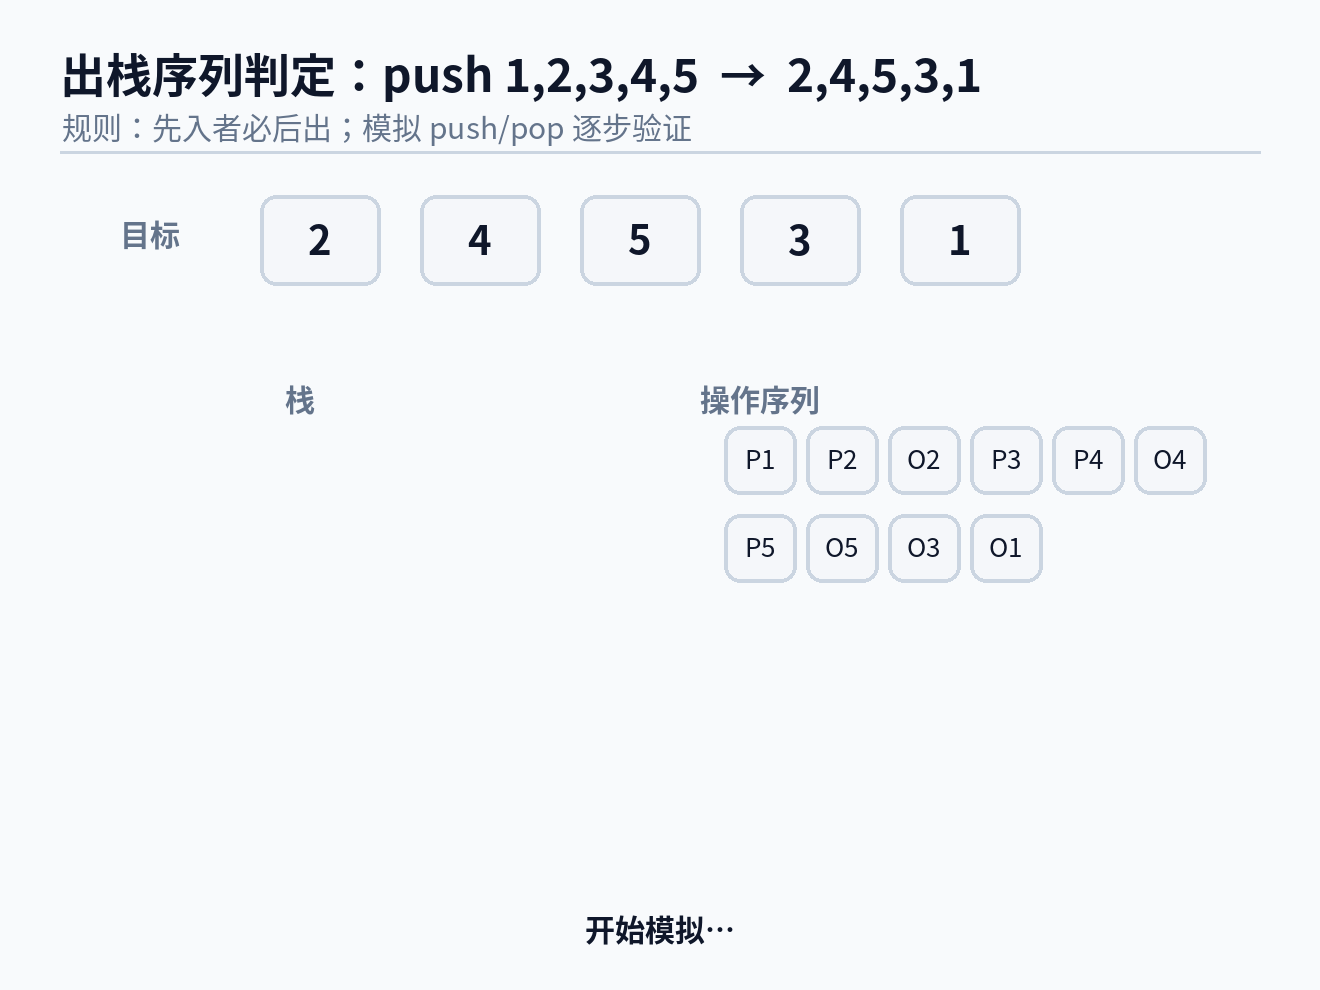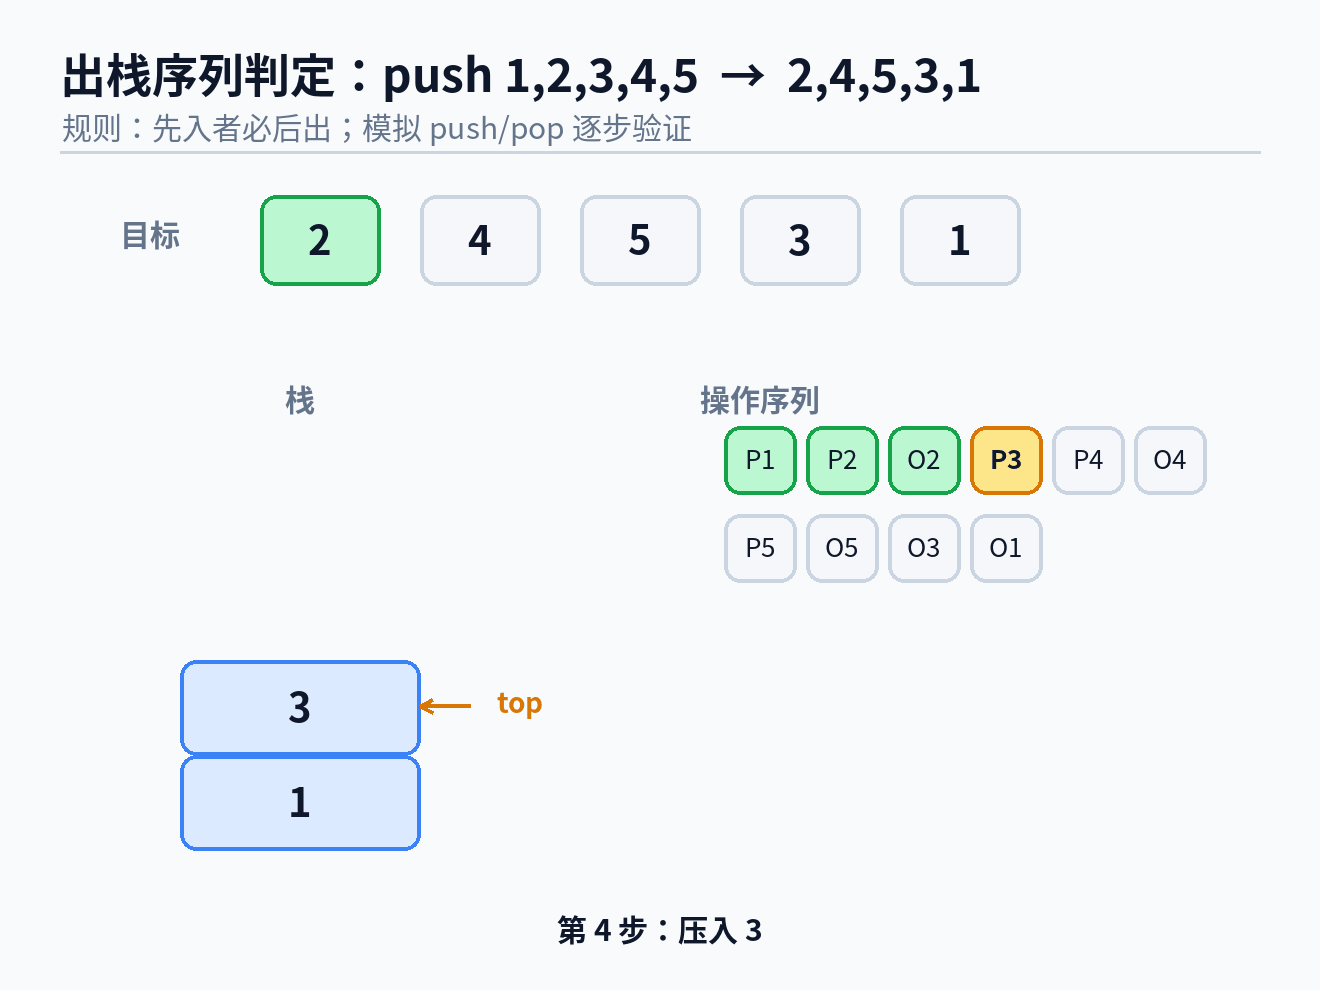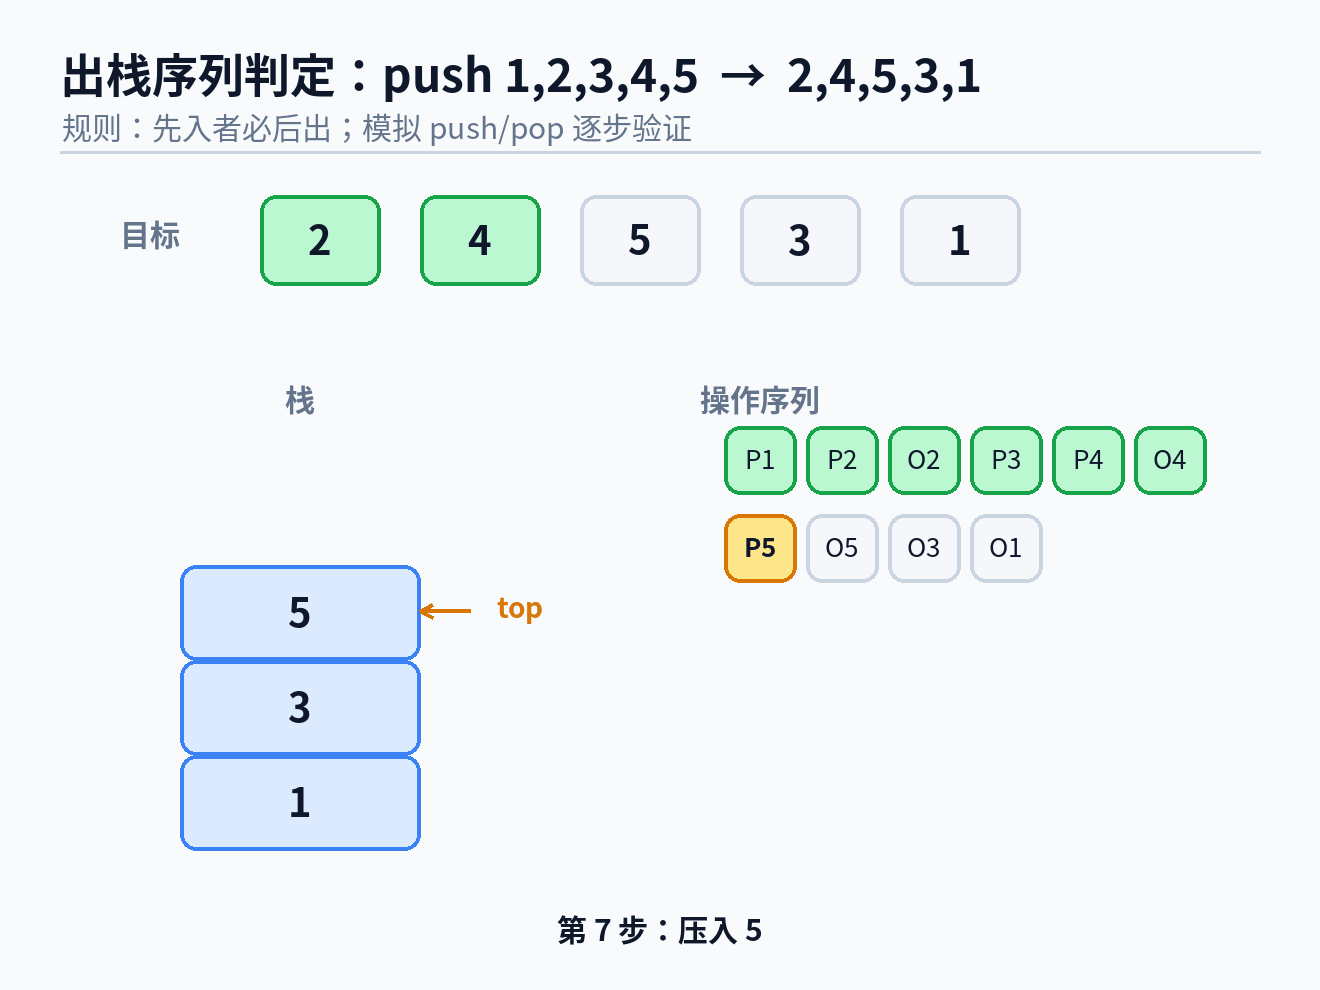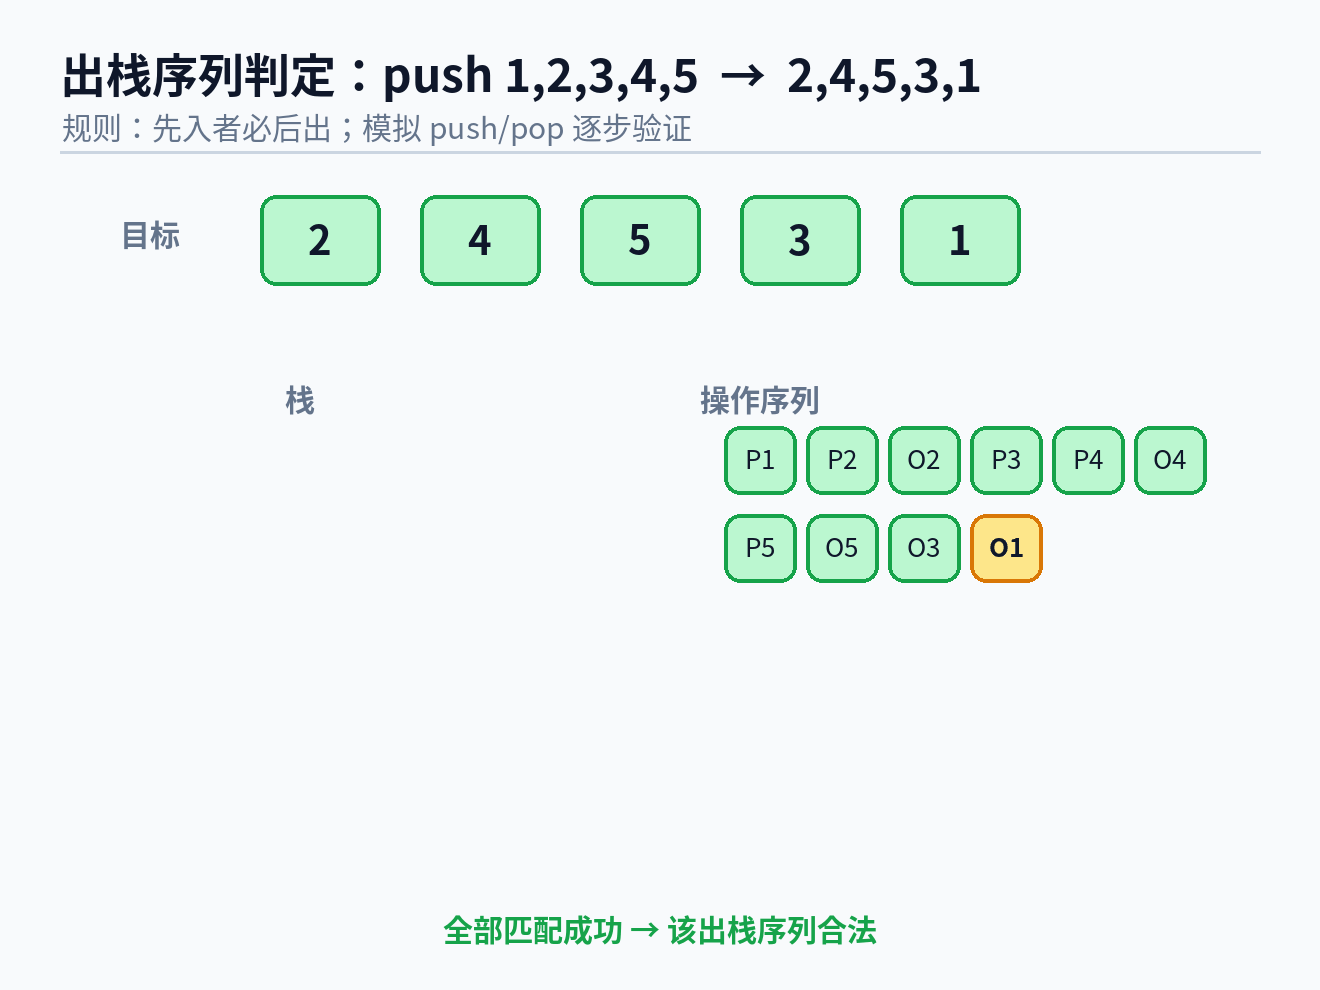
问题:给定入栈序列(通常为 )与一个候选出栈序列,判断后者能否由前者产生。
判定准则:对任意一个元素 ,在它之后出栈、且比它后入栈的元素,必须保持”入栈顺序的逆序”出现。等价地说,若候选序列中存在 使得 (即出现 312 模式),则不合法——这就是”栈排序排列”与 312 模式的关系(见 扩展:更多栈模型与数学)。
通用判定算法(模拟法,):
// 入栈序列固定为 1..n,判断 pop[] 是否为合法出栈序列
int is_valid_pop(int n, const int* pop) {
    int stk[100]; int top = 0; int next_push = 1;
    for (int i = 0; i < n; i++) {
        while (top == 0 || stk[top - 1] != pop[i]) {
            if (next_push > n) return 0;   // 已无可压入的元素,仍未匹配
            stk[top++] = next_push++;      // 继续压入,直到栈顶正好是目标
        }
        top--;                             // 匹配成功,弹出
    }
    return 1;
}手算口诀:先入者必后出。例如入栈顺序 1 2 3,出栈序列 3 1 2 不合法——要让 3 先出,1、2 必然都已按序入栈,栈顶是 2,因此 2 只能比 1 先出。
考点 2:出栈序列的枚举与计数(卡特兰数)
个互不相同的元素依次入栈,所有可能的出栈序列个数为第 个卡特兰数:
| 1 | 2 | 3 | 4 | 5 | 6 | |
|---|---|---|---|---|---|---|
| 1 | 2 | 5 | 14 | 42 | 132 |
记忆与推导:把”入栈”记作 、“出栈”记作 ,则任意前缀和都 (不能出多于入)。所有 个含 个 、 个 的序列中,不合法的序列(存在某前缀和 )与”含 个 、 个 “的序列一一对应(反射原理),故
注意区分:卡特兰数说的是” 个不同元素的出栈序列数”。若元素有重复,需去重,不能直接套 。出栈序列的个数也等于: 个结点能构成的不同形态的二叉树个数、 对括号的合法匹配方案数——它们都是卡特兰数族(见 扩展:更多栈模型与数学)。
考点 3:由入栈序列与目标出栈序列反推操作序列
问题:给入栈序列与想要的出栈序列,写出每一步执行的是 push 还是 pop。
方法:从左到右扫描目标出栈序列,维护指针 i 指向下一个待压入元素。对每个目标元素 x:若栈顶等于 x,则 pop;否则把尚未压入的元素依次 push,直到把 x 压入,再 pop。若所有元素都压完仍无法匹配,则目标序列非法。
例:入栈 1 2 3 4 5,目标出栈 2 4 5 3 1:
push 1, push 2, pop(2), push 3, push 4, pop(4),
push 5, pop(5), pop(3), pop(1)
即操作序列 P P O P P O P O O O(P=push,O=pop)。这套操作序列是唯一确定的(对应 LeetCode 946 验证栈序列)。
考点 4:根据操作序列 / 出栈序列计算栈的最小容量
问题:给定入栈与出栈的完整操作序列,求栈在整个过程中达到过的最大深度,就是能完成该任务的最小栈容量。
方法:直接模拟,用计数器 size 记录当前栈内元素数,每 push 加一、每 pop 减一,全程取最大值。
例:入栈顺序 1 2 3 4,操作序列 P P P O O P O O:
| 操作 | P | P | P | O | O | P | O | O |
|---|---|---|---|---|---|---|---|---|
| 栈内数 | 1 | 2 | 3 | 2 | 1 | 2 | 1 | 0 |
最大深度为 3,故栈容量至少为 3。
考点 5:栈与队列组合模拟求栈容量
当元素的输入顺序由队列决定时(队列出队的元素才依次入栈),求栈的最小容量,思路仍是模拟——只是”下一个入栈元素”要从队首取。题目常见的两种表述:
- 队列 → 栈 → 输出:元素先按 入队,允许”出队并入栈”或”出栈”,求实现目标输出所需的最小栈容量;
- 栈 → 队列 → 输出:类似。
统一做法:把”队首元素”当作考点 4 中”下一个待压入元素”,按同一套模拟统计栈内最大元素数即可。不要被”队列”干扰——队列只改变”入栈次序”,栈容量的定义不变。
考点 6:限制连续退栈次数的出栈序列判定
问题:入栈序列 a b c d e f 依次入栈,允许进栈、退栈交替进行,但不允许连续三次退栈,判断某出栈序列是否可能(2010 年 408 第 1 题,见 408 真题精选)。
快速判定法:连续退栈时,弹出的必然是入栈顺序的逆序连续片段。因此若出栈序列中含长度 的连续逆序子串(就题给字母表而言),则违反”不允许连续三次退栈”。例如 d c e b f a 中没有连续三个逆序,可行;而 a f e d c b 的尾部 f e d c b 是连续 5 个逆序,必然需要连续退栈 ≥ 3 次,因此不可能。
考点 7:栈空时弹出元素构成序列的判定
问题:在”允许任意时刻入栈/出栈(含入栈未完成时)“的混合操作下,判定一个带限制的目标序列是否可达。
- 若允许任意时刻进出,判定方法与考点 1 的模拟法一致;
- 若限制某一侧的操作(如”入栈未完成前不允许出栈""只允许在某时刻出栈”),则在模拟时把限制编码进状态机,枚举/回溯所有合法操作序列;
- 若问”栈为空时还能否 pop”,答案是不能:对空栈执行 pop 属于下溢(underflow),是非法操作。
考点 8:中缀转后缀时运算符栈的最大容量估算
问题:把一个中缀表达式转成后缀,估算运算符栈(调度场算法里那个栈)最多需要多少格。
结论:运算符栈的最大深度 = 括号的最大嵌套深度 + 同时挂起的运算符个数。而”同时挂起的运算符”至多等于表达式涉及的不同优先级层数(通常 一层、 一层,共 2 层;含括号时再加 1 层保护),所以一个实用的上界是
例:9+(3-1)*3+10/2 的运算符栈最多同时容纳 2 个运算符(+ * 或 + /),嵌套深度 1、优先级层数 2,故容量 3 足够。最坏情况也不会超过”运算符总数”,但通常远小于它。填估算值时要按具体表达式逐步模拟,不要直接写运算符个数。
考点 9:顺序栈栈顶指针的不同初始约定
见 顺序栈的两种栈顶指针约定(易错点):约定 A(top=-1,指向栈顶元素)与约定 B(top=0,指向下一个空位)的判空、判满、入栈、出栈表达式全部成对互换。做题第一步确认约定,再套公式。
考点 10:递归调用次数计算
定义:递归调用次数 = 递归树中结点的总数(含初始调用),递归深度 = 递归树的最大层数。
| 递归 | 递推关系 | 调用次数 | 深度 |
|---|---|---|---|
factorial(n) | |||
| Fibonacci(朴素) | 约 量级 | ||
汉诺塔 hanoi(n) | |||
| 二分查找 |
汉诺塔推导: 展开得 次移动,也对应 次函数调用。
复杂度对比:递归调用次数决定时间,递归深度决定空间(系统栈帧数)。二者不一定同阶——斐波那契朴素递归调用是 、但深度只有 。
考点 11:算法设计策略与递归技术的关系
递归不是一种独立的算法,而是实现策略的通用手段。常见关系:
| 策略 | 与递归的关系 | 是否必须递归 |
|---|---|---|
| 分治 | 把问题分成同类子问题递归求解,再合并(快排、归并、大整数乘法) | 可用递归或显式栈/循环 |
| 减治 | 每步排除一部分规模(二分、快速选择),是递归的特例 | 通常可改写成循环 |
| 动态规划 | 递归 + 记忆化 = 自顶向下;填表 = 自底向上 | 可递归可迭代 |
| 回溯 | 递归枚举所有候选,失败则撤销(N 皇后、全排列) | 强烈依赖递归 |
| 树/图遍历 | DFS 天然递归,BFS 用队列迭代 | DFS 可手动栈改写 |
任何递归都能用显式栈改写为迭代(“栈消除递归”的核心);反过来,用栈模拟系统调用就是手动维护栈帧。
考点 12:递归算法必须包含终止条件与递归部分
一个正确的递归算法由三要素构成,缺一不可(选择题高频):
- 终止条件(基准情形 / base case):满足时直接返回,不再递归;
- 递归部分(递归步):把问题规模缩小后调用自身;
- 收敛性:每次递归都让规模严格减小,保证有限步内到达终止条件。
缺少终止条件会导致无限递归、进而栈溢出;缺少收敛性则可能永远到不了终止条件。例如 factorial 的终止条件是 n == 0 || n == 1,递归部分是 n * factorial(n-1)。
考点 13:递归与迭代的对比
| 对比项 | 递归 | 迭代(循环) |
|---|---|---|
| 实现方式 | 函数调用自身 | for / while 重复执行 |
| 空间 | 靠系统调用栈, | 通常 (用显式栈时除外) |
| 时间 | 每层有函数调用开销,常数因子大 | 常数因子小 |
| 可读性 | 贴近数学定义,简洁 | 直白,但有时繁琐 |
| 风险 | 递归过深 → 栈溢出 | 无栈溢出风险 |
| 适用 | 分治、回溯、树形/嵌套结构 | 线性、简单重复 |
| 转换 | 递归一般可改迭代(用显式栈) | 迭代不一定能直接改递归 |
会考:判断题”递归一定比迭代慢 / 一定更占空间”(一般成立但不绝对——尾递归可被优化成循环);选择题问”哪些问题更适合递归 / 迭代”。
考点 14:递归的复杂度分析
- 递归调用次数 = 递归树的结点数(决定时间);递归深度 = 递归树的高度(决定空间)。
- 递推方程 用主定理求解;也可用递归树展开或猜解归纳。
- 常见结果(必背):
| 递归算法 | 递推关系 | 时间复杂度 | 空间(深度) |
|---|---|---|---|
| 阶乘 / 线性递归 | |||
| 朴素斐波那契 | () | ||
| 汉诺塔 | |||
| 二分查找 | |||
| 归并排序 | |||
| 快速排序(均摊/最坏) | —— | / | / |
会考:给一段递归代码,求其调用次数或时间/空间复杂度;比较朴素斐波那契 与记忆化后的 。
考点 15:尾递归与”递归转非递归”
尾递归:递归调用是函数体的最后一个动作,且其返回值不被后续计算使用。此时编译器可复用当前栈帧(尾调用优化),把空间降到 。注意:C 标准不保证尾调用优化,gcc -O2 通常会做,但考试中”能否依赖它”要谨慎。
// 普通递归:O(n) 空间
long fact(int n) { return n <= 1 ? 1 : n * fact(n - 1); }
// 尾递归写法:O(1) 空间(编译器优化后),可等价改写成 while 循环
long fact_iter(int n, long acc) {
    return n <= 1 ? acc : fact_iter(n - 1, n * acc);
}递归转非递归的四种方法:
| 方法 | 做法 | 是否用栈 |
|---|---|---|
| 尾递归改循环 | 直接把递归改写为 while | 否 |
| 显式栈模拟 | 保存”待处理现场 / 返回点” | 是 |
| 记忆化 / DP | 自底向上填表,消除重复子问题 | 否(用表) |
| 队列层序展开 | 把层序过程改成队列迭代(BFS) | 队列 |
会考:判断一段递归能否改写成循环(尾递归可以);填空”把二叉树先序遍历的递归改成非递归”(用栈);辨析”递归转非递归一定需要栈吗”(不一定,尾递归直接循环;分治/回溯通常需要栈)。
考点 16:带头结点 vs 不带头结点(链栈 / 单链表)
链栈可复用单链表的两种实现方式,差别集中在初始化、入栈(头插)、出栈(头删)与边界处理上:
| 对比项 | 带头结点 | 不带头结点 |
|---|---|---|
| 初始化 | 分配头结点:head->next = NULL,返回 head | top = NULL |
| 栈顶是谁 | head->next(头结点的后继) | top 本身(指向首元结点) |
| 判空 | head->next == NULL | top == NULL |
| 入栈(头插) | new->next = head->next; head->next = new;(改 head->next) | new->next = top; top = new;(改 top) |
| 出栈(头删) | p = head->next; head->next = p->next; free(p);(head 不变) | p = top; top = p->next; free(p);(top 被改) |
| 是否需要二级指针 | 不需要,传 SNode* 即可 | 需要 SNode**(或返回新栈顶) |
| 空栈处理 | 统一,空栈也有头结点 | 需特判 top == NULL |
| 清空 | 释放数据结点、保留头结点,head->next = NULL | 释放全部结点,top = NULL |
| 销毁 | 先释放数据结点、再释放头结点,head = NULL | 释放全部结点即可,top = NULL |
| 空间开销 | 多一个头结点 | 无额外结点 |
核心结论:带头结点让”入栈/出栈”和普通头插/头删共用一套逻辑,不必修改头指针;代价是多一个不存数据的结点。链栈与单链表的这套区别完全一致(见 链表)。
考察内容:选择/填空比较两种实现;判断题考”带头结点链栈的栈顶到底是哪个结点""入栈是否修改头指针”。
考点 17:顺序栈 vs 链式栈
| 对比项 | 顺序栈 | 链式栈(链栈) |
|---|---|---|
| 存储结构 | 一段连续数组 | 单链表结点,只在链头(栈顶)操作 |
| 栈顶标记 | top 下标(约定 A:-1 / 约定 B:0) | top 指针(不带头)或头结点后继(带头) |
| 初始化 | 分配数组,top = -1(或 0) | top = NULL(不带头)/ 创建头结点(带头) |
| 判空 | top == -1(A)/ top == 0(B) | top == NULL / head->next == NULL |
| 判满 | 需要:top == MaxSize-1(静态)或扩容(动态) | 无需判满,除非内存耗尽 |
| 入栈 | 先判满再写,均摊 | 头插, |
| 出栈 | 先判空再取, | 头删, |
| 扩容 / 溢出 | 静态会上溢;动态 realloc 要搬移全部元素 | 按需申请结点,天然可扩展,不会”上溢”(除非内存耗尽) |
| 空间效率 | 存储密度 = 1,但可能预留/浪费 | 每结点多一个指针,存储密度 < 1 |
| 缓存行为 | 连续、缓存友好,访问快 | 指针追踪,缓存不友好 |
| 多栈共享 | 两栈共享空间很自然(双端栈) | 需特殊设计,一般不共享 |
| 适用场景 | 容量可预估、追求性能 | 容量不可预估、插删频繁 |
选型口径:能预估上限且追求速度选顺序栈;上限未知、怕溢出选链栈。二者核心操作都是 ,差别在扩容、空间开销与缓存。
考察内容:结构选型选择/简答;比较判满条件、扩容代价、空间与缓存。
考点 18:清空 vs 销毁
| 对比项 | 清空(Clear) | 销毁(Destroy) |
|---|---|---|
| 目的 | 删除所有数据元素,回到初始空状态 | 释放结构占用的全部内存 |
| 结构是否可用 | 仍可用,可继续入栈 | 不可用(除非重新初始化) |
| 顺序栈 | 只把 top = -1(或 0),数组空间不释放(可循环覆写 0 防信息泄露) | free(data); data = NULL; capacity = top = 0; |
| 链栈(带头) | 释放数据结点,保留头结点,head->next = NULL | 先释放数据结点、再释放头结点,head = NULL |
| 链栈(不带头) | 释放全部结点,top = NULL | 同清空(代码几乎相同),top = NULL |
| 典型复杂度 | 顺序 ;链式 | |
| 误用风险 | 安全(回到空态) | 悬空指针/双重释放——销毁后必须置空头指针 |
易错点:不带头结点的链栈里,“清空”和”销毁”的代码基本一样(都释放所有结点并置
top = NULL);只有带头结点时二者才明显不同——清空保留头结点、销毁连头结点一起释放。顺序栈的”清空”只改top,不释放数组。
考察内容:概念选择/填空”清空后能否继续使用""销毁后头指针的值""带头结点清空保留什么""顺序栈清空做了哪件事”。
408 真题精选
这一节只放历年 408 统考真题,按年份排列。栈与队列、双端队列的题目互相穿插,队列相关的真题汇总在 F_队列_Queue > 408 真题精选,两处用交叉链接互相引用。
真题索引(栈与双端队列相关)
| 年份 | 题号 | 题目 | 本题解位置 |
|---|---|---|---|
| 2010 | 1 | 不允许连续三次退栈,不可能的出栈序列 | 2010 第 1 题:不允许连续三次退栈 |
| 2013 | 2 | 入栈 、 时 的取值个数 | 2013 第 2 题:出栈序列中元素取值个数 |
| 2018 | 1 | 操作数栈 + 运算符栈,调用 3 次 F() | 2018 第 1 题:双栈求表达式值 |
| 2020 | 2 | 空栈 Push/Pop 操作序列的出栈序列 | 2020 第 2 题:给定操作序列求输出 |
双端队列的真题(2010 第 2 题、2014 第 3 题、2021 第 2 题)与循环链队列应用题(2019 第 42 题)见 F_队列_Queue > 408 真题精选。
2010 第 1 题:不允许连续三次退栈
真题题干:
若元素 a, b, c, d, e, f 依次进栈,允许进栈、退栈操作交替进行,但不允许连续三次进行退栈操作,则不可能得到的出栈序列是( )。
A. d, c, e, b, f, a B. c, b, d, a, e, f C. b, c, a, e, f, d D. a, f, e, d, c, b
考察内容:把”连续退栈”翻译成”连续逆序子串”。连续退栈时弹出的元素必然按入栈顺序的逆序排列,因此只要出栈序列中出现长度 的连续逆序片段,就必然需要连续退栈至少 3 次。
解析:D 的尾部 f, e, d, c, b 是长度 5 的连续逆序,需要连续退栈 5 次,违反约束,故不可能。其余选项都能找到不含”连续 3 次退栈”的操作序列。
正确答案:D。
2013 第 2 题:出栈序列中元素取值个数
真题题干:
一个栈的入栈序列为 ,其出栈序列是 。若 ,则 可能取值的个数是( )。
A. B. C. D. 无法确定
考察内容:在不写出完整序列的前提下,分析 能否取某值。
解析:
- 由 可知只有两种开局:先弹出 2(,此时 1 还在栈中),或先弹出 1(,随后 2、3 入栈再弹出 3);
- 若 ,栈中剩 1,后续元素 尚未入栈, 可取 ;
- 若 ,栈中剩 2, 可取 ;
- 合并后 可取除 3 以外的全部值,共 个。
正确答案:C()。
2018 第 1 题:双栈求表达式值
真题题干:
若栈 S1 中保存整数,栈 S2 中保存运算符,函数 F() 依次执行下述各步操作:① 从 S1 中依次弹出两个操作数 a 和 b;② 从 S2 中弹出一个运算符 op;③ 执行相应的运算 b op a;④ 将运算结果压入 S1。假定 S1 中的操作数依次是 5, 8, 3, 2(2 在栈顶),S2 中的运算符依次是 ×, −, +(+ 在栈顶)。调用 3 次 F() 后,S1 栈顶保存的值是( )。
A. −15 B. 15 C. −20 D. 20
考察内容:后缀表达式求值的过程,以及”弹出顺序反了会算错”这一易错点。注意题目明确 b op a,即先弹的 a 是右操作数。
解析:
| 次数 | S1(底→顶) | S2(底→顶) | a, b | op | 计算 b op a | 结果入栈后 S1 |
|---|---|---|---|---|---|---|
| 1 | 5, 8, 3, 2 | ×, −, + | a=2, b=3 | + | 3+2=5 | 5, 8, 5 |
| 2 | 5, 8, 5 | ×, − | a=5, b=8 | − | 8−5=3 | 5, 3 |
| 3 | 5, 3 | × | a=3, b=5 | × | 5×3=15 | 15 |
正确答案:B(15)。
2020 第 2 题:给定操作序列求输出
真题题干:
对空栈 S 进行 Push 和 Pop 操作,入栈序列为 a, b, c, d, e,经过 Push, Push, Pop, Push, Pop, Push, Push, Pop 操作后得到的出栈序列是( )。
A. b,a,c B. b,a,e C. b,c,a D. b,c,e
考察内容:纯模拟,逐个操作手推栈状态。
解析:
| 操作 | 栈内(底→顶) | 出栈元素 |
|---|---|---|
| Push | a | |
| Push | a b | |
| Pop | a | b |
| Push | a c | |
| Pop | a | c |
| Push | a d | |
| Push | a d e | |
| Pop | a d | e |
出栈序列为 b, c, e。
正确答案:D。
扩展:更多栈模型与数学
这一节是”比较深入的地方”,不追求覆盖考纲;对栈的数学结构与工程变体感兴趣的读者可以读。
卡特兰数为什么是 个元素出栈序列的个数
用反射原理给出严格证明。把一次入栈记作向上的 、一次出栈记作向下的 ,则整个操作序列是一条从 到 、含 步上升与 步下降的路径;合法操作序列要求路径始终不低于横轴(任意时刻出栈数 ≤ 入栈数),即从不触及直线 。
- 所有路径数为 ;
- 由反射原理,触及 的非法路径与”从 到 、含 步上升、 步下降”的路径一一对应(把起点反射到 ),后者数为 。
于是合法数 。同一结构还出现在:括号匹配方案数、不同形态二叉树个数、凸多边形三角剖分数——它们都归约为”始终不低于横轴的格路”,属卡特兰数族。
栈排序与 312 模式
一个排列能否由”入栈 、出栈得到目标排列”产生,等价于它是否避免 312 模式:不存在下标 使 。Knuth 证明:排列是栈排序可达的当且仅当它避免 312 模式,其个数正是卡特兰数 ——与”出栈序列个数”殊途同归。
多轨道火车调度问题(Railroad / 列车编组)
问题:列车由输入轨道驶入,经过若干条旁轨(栈),要求按目标顺序驶出输出轨道,求最少需要几条旁轨。
- 单旁轨(单栈):能得到的输出顺序正是”栈排序排列”(避免 312 模式);经典变体问”某输出顺序能否只用一条旁轨完成”。
- 多旁轨(多栈):旁轨数对应栈的条数,问题升级为”用 个栈能否排序该排列”; 足够大时任何排列都可排。这与栈的容量/条数、递推计数有关,是栈在调度中的经典映射。
- 工程对应:列车编组站、洗车流水线的”缓存轨道”,本质都是受限的栈/队列组合;生产-消费流水线也常用这种”输入序列 → 栈/队列 → 输出序列”的抽象。
表达式树与三种遍历
表达式除用栈求值外,还可建成表达式树:叶子是操作数,内部结点是运算符。
- 中序遍历 → 中缀表达式(需补括号还原优先级);
- 前序遍历 → 前缀(波兰)式;
- 后序遍历 → 后缀(逆波兰)式。
这解释了”前缀/后缀不需要括号”:树的前/后序天然携带运算结构,而中序会丢失父子优先级信息。用栈构造表达式树再遍历求值,是编译器表达式处理的标准流程。
栈的工程变体
- 带最小值的栈(MinStack):辅助栈或差值法(见正文);
- 栈的池化:预分配大块内存,避免频繁
malloc(对应链栈的分配开销); - 调用栈的硬件化:x86 的返回栈缓冲器 RSB、影子栈(见 硬件级栈:x86-64 调用栈)。
各语言标准库对比
| 语言 | 栈类型 | 说明 |
|---|---|---|
| C | 无(手写) | 标准库不提供容器 |
| C++ | std::stack<T> | 适配器,默认底层 std::deque |
| Java | ArrayDeque<T> | 推荐;Stack 是遗留类 |
| Python | list | append() / pop() |
| Rust | Vec<T> | push() / pop() |
| Go | 无内置 | 用 slice 模拟:stack = append(stack, x) |
应用场景
- 函数调用:x86-64 的硬件栈。每次函数调用(
call指令)自动 push 返回地址,返回时(ret)自动 pop。C++ 异常处理中的栈展开(stack unwinding)沿调用链逐帧 destroy 局部对象 - 表达式求值:编译器将中缀表达式转后缀(RPN),用栈求值。计算器、SQL 查询引擎的表达式树求值均依赖此模型
- 括号匹配:编译器/编辑器的语法验证。左括号 push,右括号时检查栈顶是否匹配。栈空但仍有右括号 = 多余右括号;结束时栈非空 = 多余左括号
- DFS 非递归:手动用显式栈替代递归,避免系统调用栈的深度限制。详见 图的 DFS
- 撤销(Undo):编辑器将每个编辑操作推入栈。Ctrl-Z = pop 栈顶操作并执行反向操作。Text Editor 的 Undo/Redo 用两个栈(undo stack + redo stack)
- 浏览器的前进/后退:两个栈分别维护后退历史与前进历史。每次跳转将当前页面推入后退栈,清空前进栈
练习
LeetCode 题单
基础与括号类
| 题号 | 题目 | 难度 | 知识点 |
|---|---|---|---|
| 20 | 有效的括号 | 简单 | 栈匹配(见正文括号匹配节) |
| 921 | 使括号有效的最少添加 | 中等 | 计数器退化(呼应自测③) |
| 1249 | 移除无效的括号 | 中等 | 栈记录下标 + 标记删除 |
| 1021 | 删除最外层的括号 | 简单 | 括号深度计数 |
| 856 | 括号的分数 | 中等 | 栈 / 深度计数 |
| 32 | 最长有效括号 | 困难 | 栈存下标 / DP |
| 1190 | 反转每对括号间的子串 | 中等 | 栈保存前缀 |
| 394 | 字符串解码 | 中等 | 双栈(数字栈 + 字符栈) |
表达式求值类
| 题号 | 题目 | 难度 | 知识点 |
|---|---|---|---|
| 150 | 逆波兰表达式求值 | 中等 | 后缀表达式 |
| 224 | 基本计算器 | 困难 | 中缀求值 + 括号 |
| 227 | 基本计算器 II | 中等 | 优先级 + 栈 |
| 772 | 基本计算器 III(会员) | 困难 | 中缀转后缀完整版 |
| 682 | 棒球比赛 | 简单 | 简单栈模拟 |
设计类(用栈)
出栈序列 / 栈模拟类(呼应考点 1–7)
| 题号 | 题目 | 难度 | 知识点 |
|---|---|---|---|
| 946 | 验证栈序列 | 中等 | 出栈序列合法性判定(考点 1/3) |
| 1047 | 删除字符串中的所有相邻重复项 | 简单 | 栈消消乐 |
| 1209 | 删除字符串中的所有相邻重复项 II | 中等 | 栈存 (字符, 计数) |
| 71 | 简化路径 | 中等 | 栈处理 ../. |
| 1598 | 文件夹操作日志搜集器 | 简单 | 路径栈 |
单调栈类
| 题号 | 题目 | 难度 | 知识点 |
|---|---|---|---|
| 739 | 每日温度 | 中等 | 下一个更大元素 |
| 496 | 下一个更大元素 I | 简单 | 单调栈 + 哈希 |
| 503 | 下一个更大元素 II | 中等 | 环形数组单调栈 |
| 42 | 接雨水 | 困难 | 单调栈 / 双指针 |
| 84 | 柱状图中最大的矩形 | 困难 | 单调栈经典 |
| 85 | 最大矩形 | 困难 | 逐行转 84 |
| 316 | 去除重复字母 | 中等 | 单调栈 + 贪心 |
| 402 | 移掉 K 位数字 | 中等 | 单调栈 + 贪心 |
核心推演清单
练习题与上面的 LeetCode 互补——侧重手算推演,全部在正文中带完整答案:
| 自测 | 位置 | 内容 |
|---|---|---|
| 两栈共享 ×2 问 | 双端栈节末 | top 推演、剩余容量、临界格判断 |
| 括号匹配 ×3 问 | 括号匹配节 | 三种失败情形识别、单括号计数器退化 |
| 中缀转后缀 | 表达式求值节 | 运算符栈逐步轨迹与三条弹栈规则 |
| 出栈序列合法性/计数 | 高频考点 1、2 | 模拟判定、卡特兰数 |
| 反推操作序列 / 求栈容量 | 高频考点 3、4 | push/pop 序列、最大深度 |
| 连续退栈限制 | 高频考点 6 | 连续逆序子串判定 |
| 递归调用次数 / 复杂度 | 高频考点 10、14 | 递归树结点数、主定理、常见递归复杂度 |
| 递归 vs 迭代 / 尾递归 | 高频考点 13、15 | 空间差异、尾调用优化、递归转非递归 |
| 带头/不带头结点对比 | 高频考点 16 | 初始化、判空、入栈/出栈、清空/销毁差异 |
| 顺序栈 vs 链式栈 | 高频考点 17 | 判满、扩容、空间与缓存对比 |
| 清空 vs 销毁 | 高频考点 18 | 结构是否可用、头指针处理、复杂度 |
动手实验
| 编号 | 题目 | 说明 |
|---|---|---|
| E1 | 中缀→后缀→求值流水线 | 手写中缀表达式 (3+4)*(5-2)/2,先后通过调度场算法转后缀和求值,验证结果。对比直接用 C 的运算符优先级计算,确认两者结果一致 |
| E2 | 递归深度 vs 手动栈 | 实现深度优先遍历二叉树:(a) 递归方式,(b) 手动栈方式。对深度为 100000 的退化树(链)分别运行,记录递归的栈溢出阈值和手动栈的无限制特性 |
| E3 | 单调栈图形化验证 | 随机生成长度 100 的数组 A,用单调递减栈计算每个位置的”右侧第一个更大元素”。打印 A 和结果数组,人工检查:对每个 i,A[result[i]] 确实是 i 右侧第一个 > A[i] 的元素 |