建议先阅读: 容器概览
原理
哈希表是什么
想象一本纸质通讯录:你不需要从第一页翻到最后一页找”张三”——你知道它在”Z”开头的区域,直接翻过去就行。哈希表把这个直觉变成了算法:用一个函数(哈希函数)把名字”算”出一个页码,直接跳到那一页。
形式化定义:哈希表是一个数组 table[0..M-1],配合一个哈希函数 。对键 , 给出它在数组中的位置——查找、插入、删除都只需一步定位,平均时间 。
与其他数据结构的对比:
| 数组 | BST | 哈希表 | |
|---|---|---|---|
| 按下标/键查找 | 下标 | 平均 | |
| 有序遍历 | 可以 | 中序遍历 | 不支持 |
| 插入/删除 | 移动 | 平均 | |
| 适用场景 | 已知下标 | 需要有序 | 只需快速查找 |
哈希表的代价是放弃有序性——如果需要按键排序遍历,应该用 BST。但如果只需要”存进去、找出来”,哈希表是最快的。
哈希表在哪里
- 去重:网页爬虫用哈希集合记录已访问 URL,O(1) 判断是否重复——10 亿 URL 也只需一次哈希定位
- 缓存:Redis/Memcached 的核心数据结构就是哈希表——GET 操作 O(1) 查找,SET 操作 O(1) 写入。CDN 缓存用一致性哈希将 URL 映射到缓存节点
- 数据库索引:MySQL Memory 引擎用哈希索引做等值查找——O(1) 直接定位行。RocksDB 的 memtable 底层是哈希表
- 编译器符号表:C 编译器遇到
int x = 5;时,把x的名字哈希到符号表——后续遇到x时 O(1) 查找类型和作用域 - Python dict / Java HashMap:这些语言的核心映射类型底层都是哈希表——字典推导
{k:v for ...}底层就是哈希表插入 - 网络路由:交换机的 MAC 地址表用哈希表存储 MAC→端口映射,O(1) 查找转发端口
这些场景的共同特征——键值对存储、需要 O(1) 查找、不关心顺序——正是哈希表的用武之地。
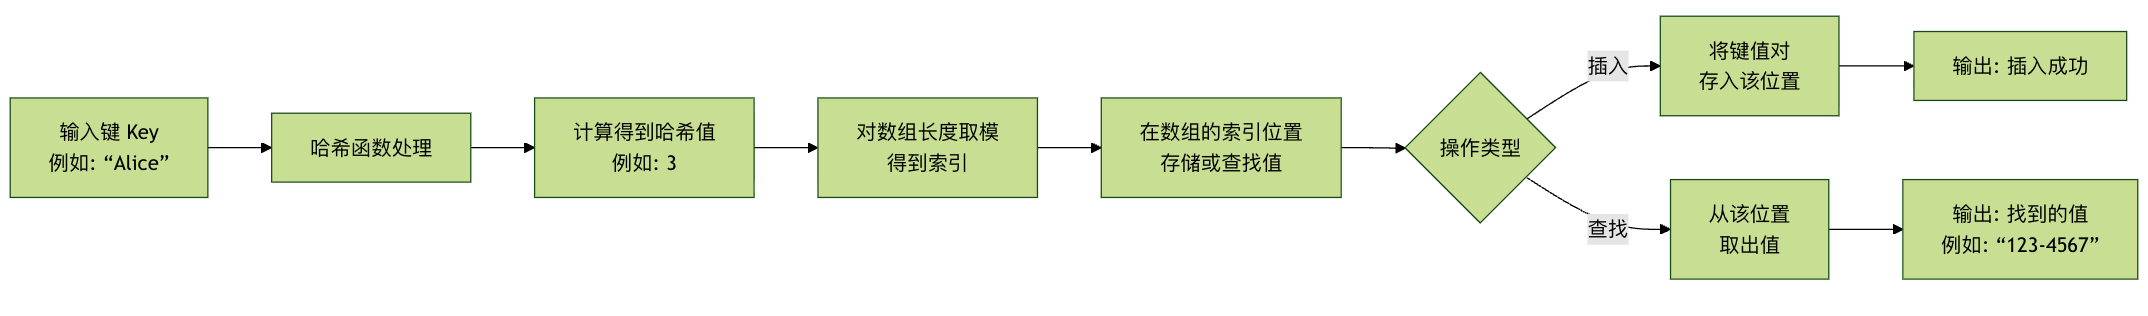
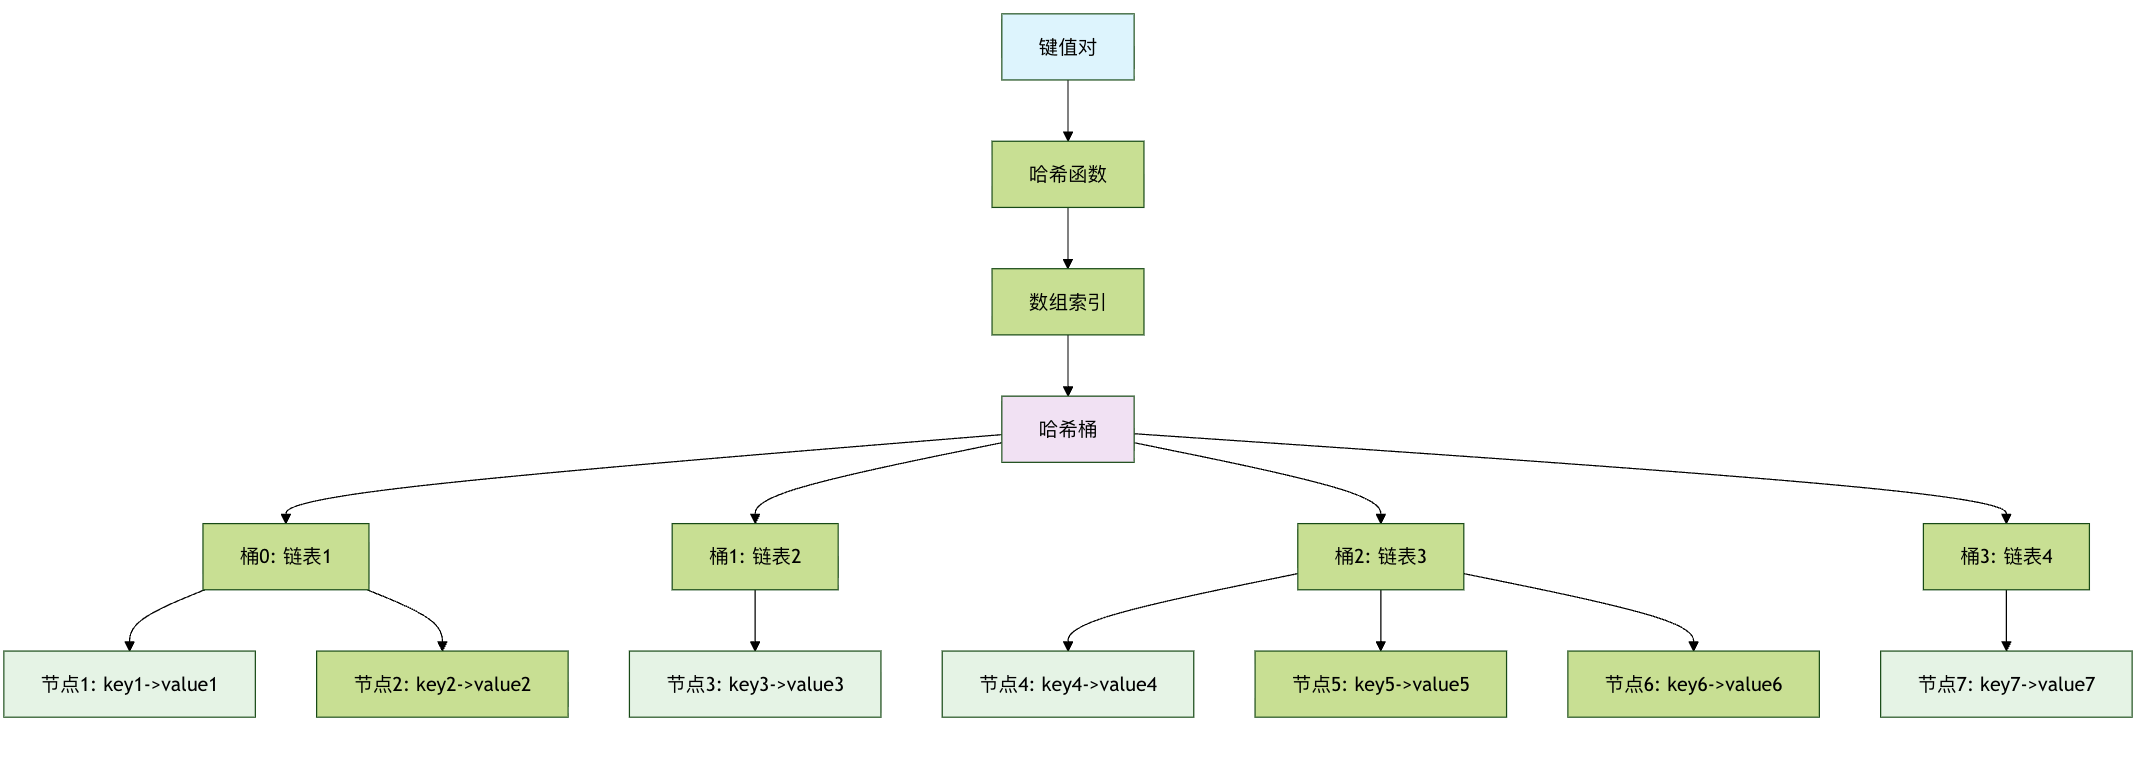
哈希表(Hash Table)是工程中最常用的数据结构——通过哈希函数将任意键映射到固定大小的数组索引,使查找在平均情况下达到 。它的工程实现比理论基础复杂得多:哈希函数的选择、冲突解决策略、装载因子的控制、rehash 策略——每一项都在直接影响实际性能。
两个核心问题
哈希表设计必须同时回答两个问题:
- 映射(Hashing):如何将一个可能无界的键空间压缩到 的有界空间内?
- 冲突解决(Collision Resolution):当两个不同的键映射到相同的数组位置时怎么办?
哈希函数
哈希函数的质量直接决定了哈希表的性能。一个”好”的哈希函数需要:
- 确定性:相同键 → 相同哈希值
- 均匀性:所有输出值同等概率出现
- 雪崩效应:输入改变 1 bit → 输出约半数 bit 变化
- 快速性:计算速度与键大小成正比
乘法哈希(Knuth 推荐):
其中 (黄金比例的倒数,为二次无理数因此有均匀分布保证), 通常是 2 的幂。
DJB2(Bernstein, 经典字符串哈希):
unsigned long hash(const char* str) {
 unsigned long hash = 5381;
 int c;
 while ((c = *str++))
 hash = ((hash << 5) + hash) + c; // hash * 33 + c
 return hash;
}
DJB2 在”乘以 33”(即 (hash << 5) + hash)和”加上下一个字符”之间建立了良好的混合。尽管没有数学上的最优性证明,但数十年实践证实了其分布均匀性。
现代哈希函数:SipHash(用于 Python dict, Rust HashMap)提供 DOS 攻击防护——哈希表拒绝服务攻击通过构造大量碰撞键使查找从 退化为 。SipHash 使用伪随机密钥,使攻击者无法预测键的哈希值——即使获得了大量键-哈希对,也无法反推其他键的哈希值。
哈希函数手算
乘法哈希:,取 (桶数),。
| 键 | 小数部分 | 取整 | 桶号 | |
|---|---|---|---|---|
| 10 | 6.18 | 0.18 | 2.88 → 2 | 2 |
| 25 | 15.45 | 0.45 | 7.20 → 7 | 7 |
| 42 | 25.956 | 0.956 | 15.296 → 15 | 15 |
| 7 | 4.326 | 0.326 | 5.216 → 5 | 5 |
除留余数法(最常用):,取 (质数推荐)。
| 键 | 桶号 | |
|---|---|---|
| 15 | 2 | 2 |
| 28 | 2 | 2(碰撞!) |
| 7 | 7 | 7 |
| 41 | 2 | 2(第三次碰撞) |
注意: 取质数可以减少碰撞——如果 是合数(如 12 = 3×4),所有 3 的倍数的键都会映射到 3 的倍数桶,分布不均匀。
自测:哈希函数
除留余数法 ,对键序列 25, 36, 18, 9, 47 依次哈希,写出每个键的桶号。
答案:25 mod 11 = 3,36 mod 11 = 3(碰撞),18 mod 11 = 7,9 mod 11 = 9,47 mod 11 = 3(第三次碰撞到桶 3)。5 个键中有 3 个映射到桶 3——这就是为什么 取质数很重要:11 是质数但 25、36、47 恰好都是 形式。
冲突解决:链地址法 vs 开放地址法
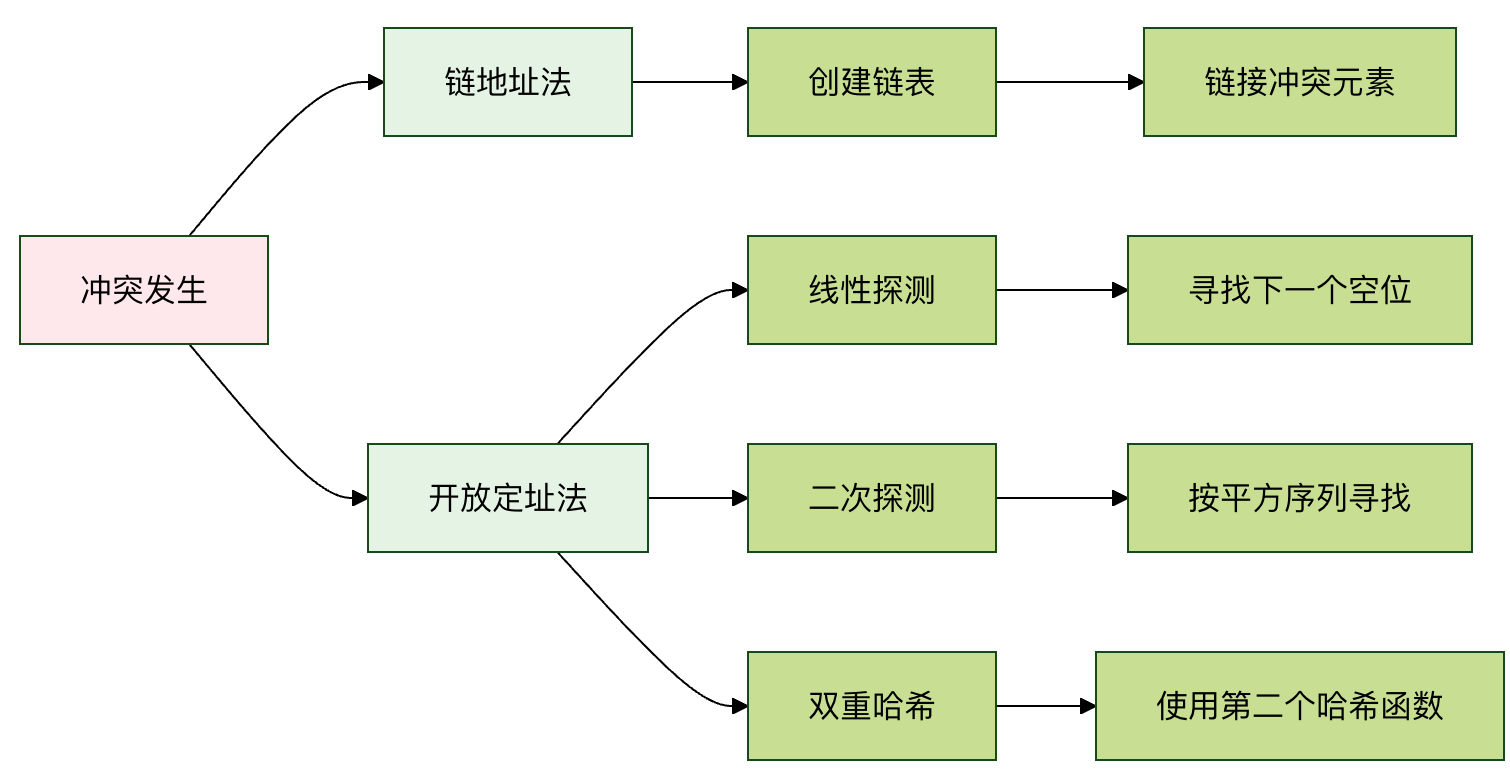
链地址法
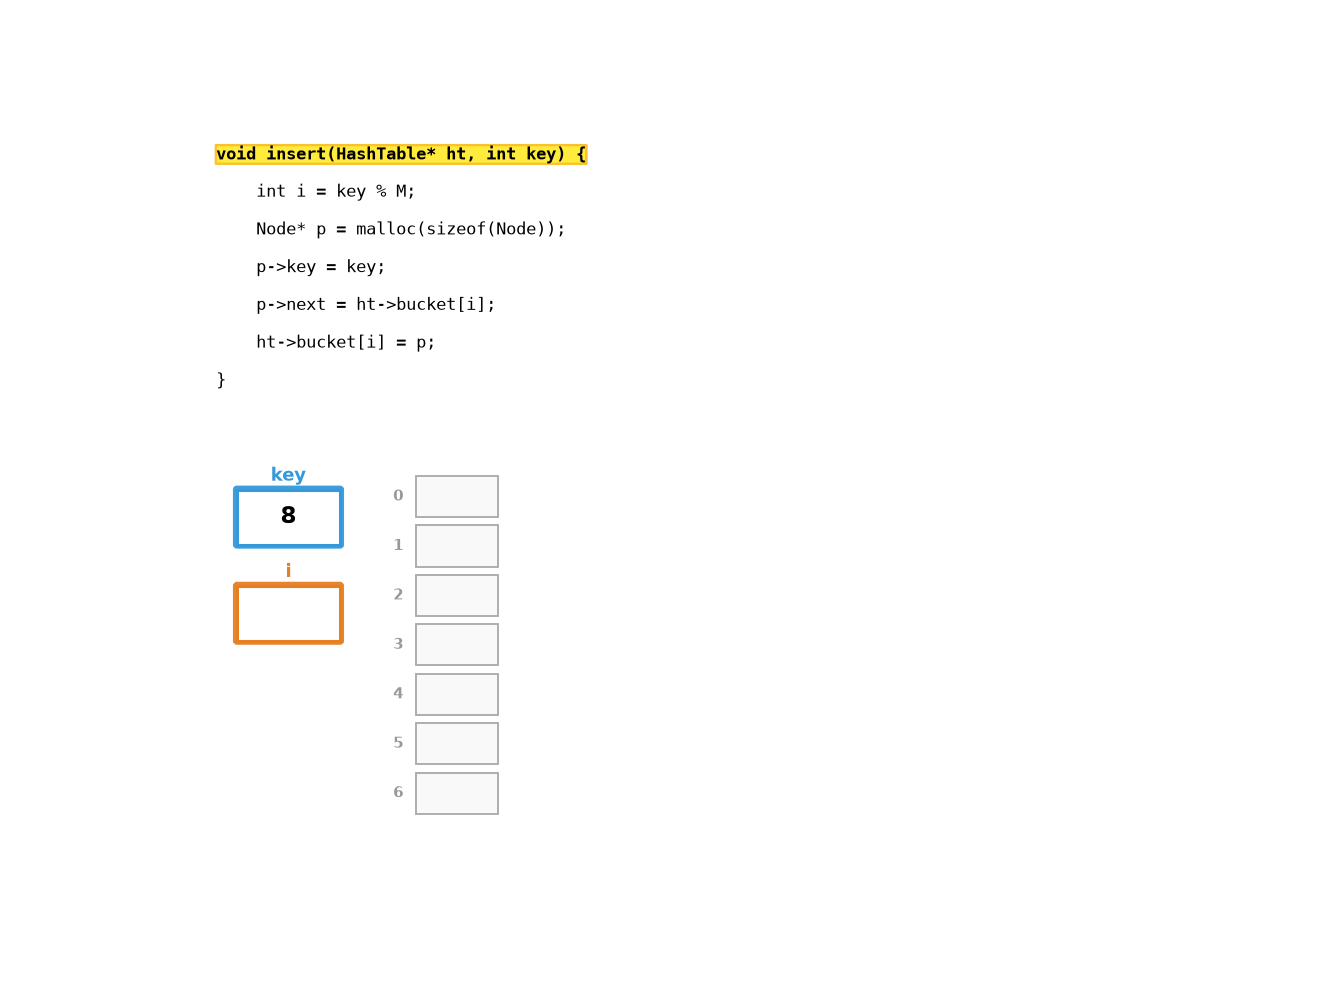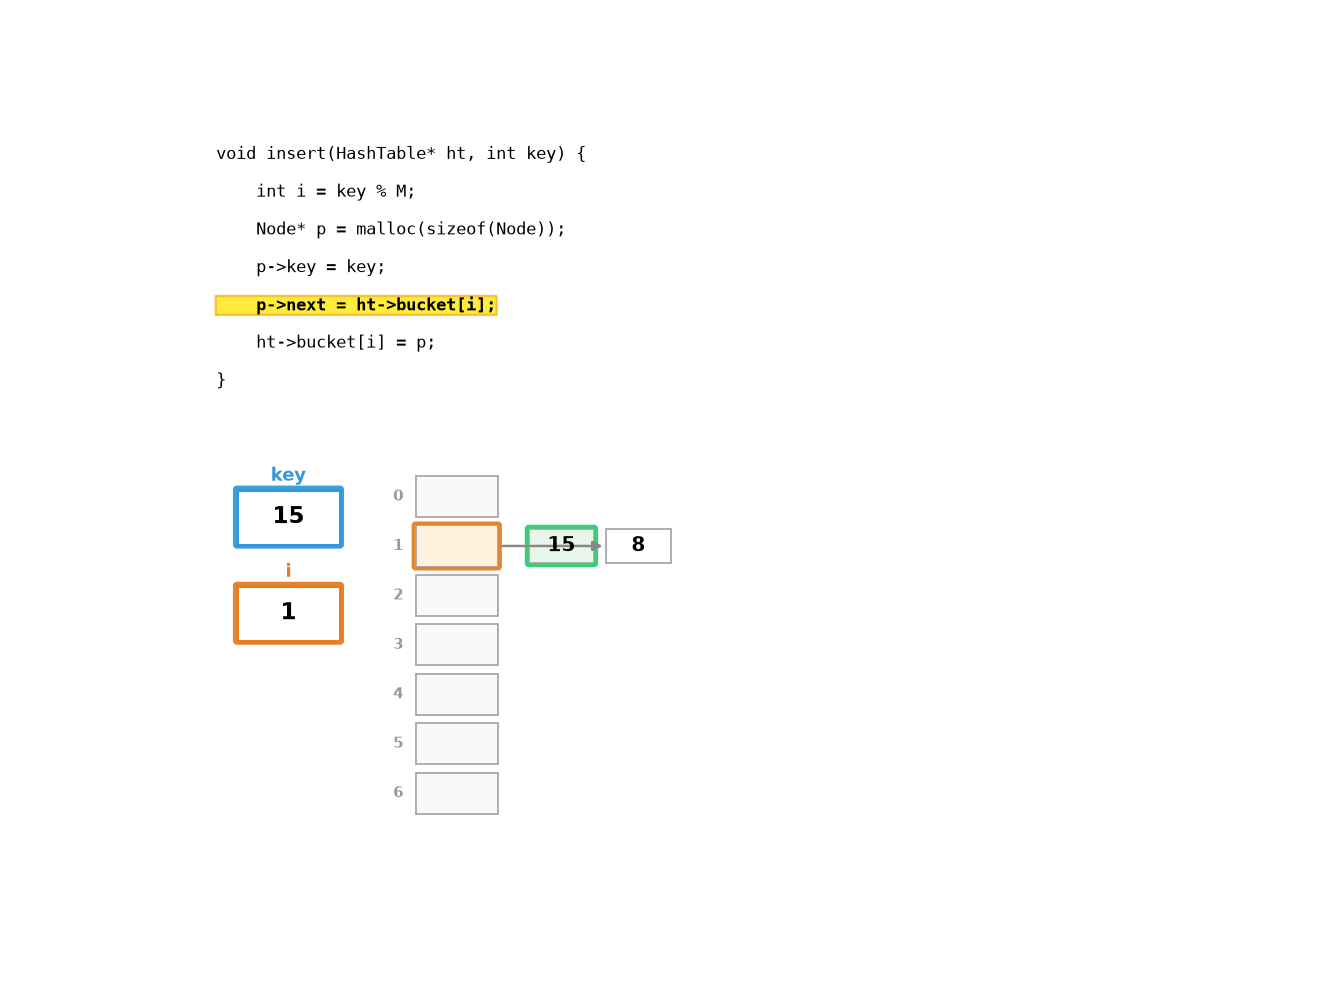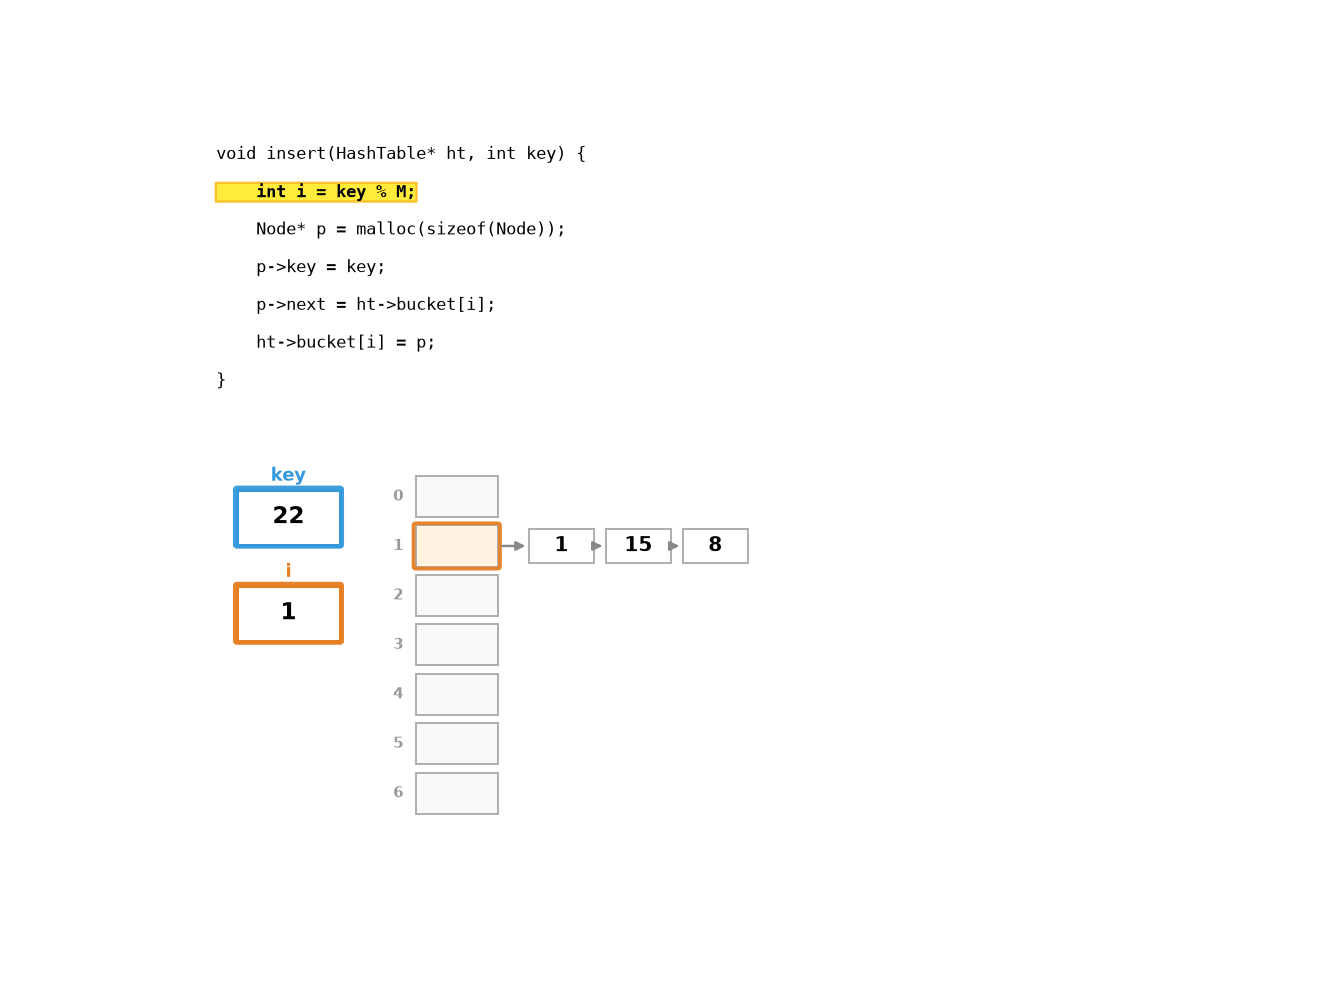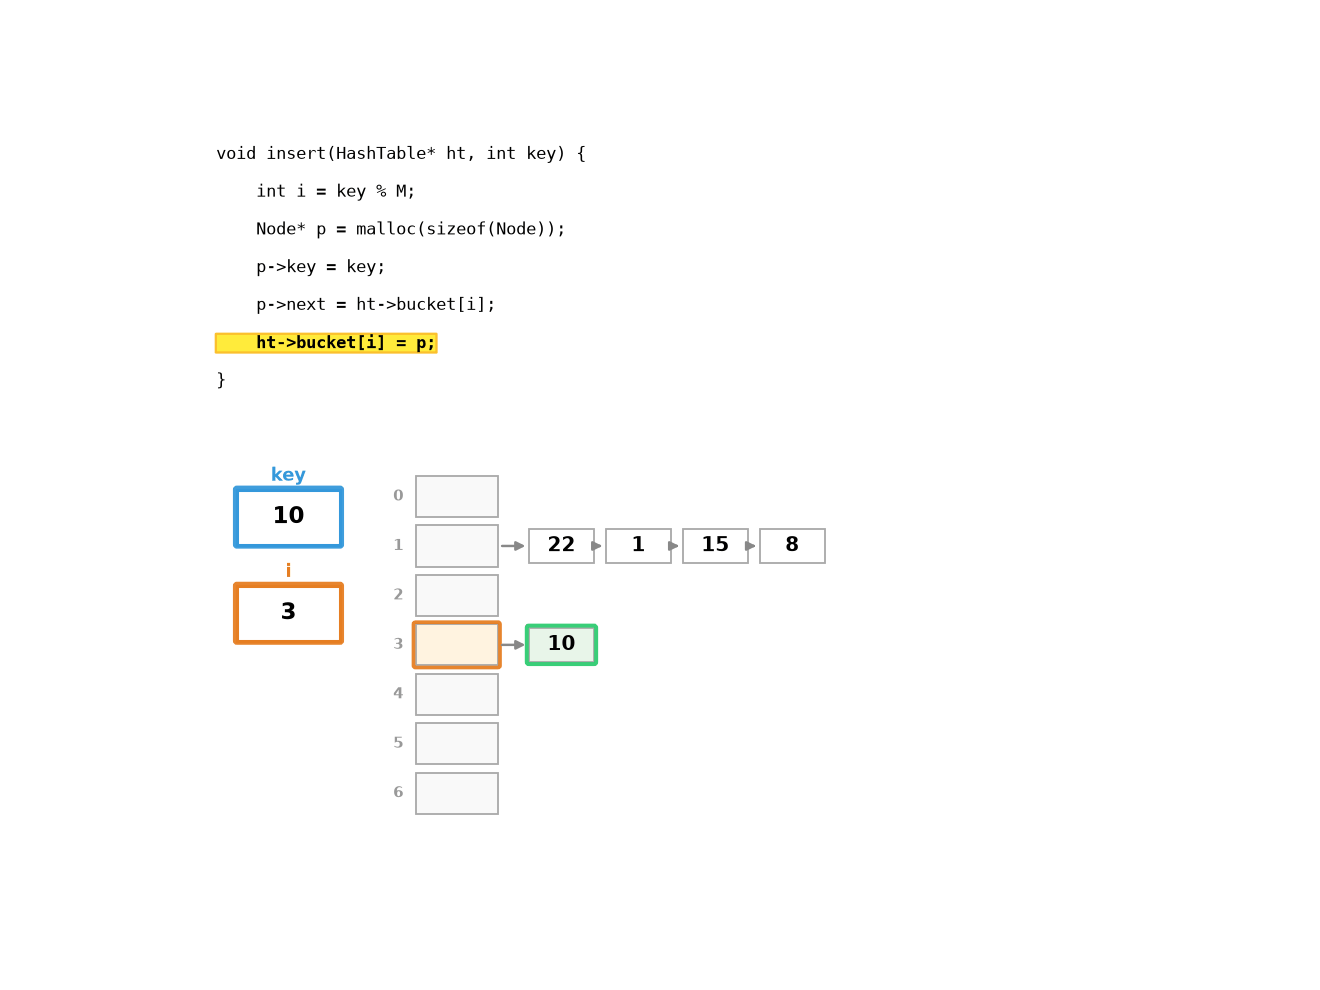
每个桶维护一个独立链表(或红黑树——Java 8+ 在链表长度 >= 8 时转为红黑树):
桶数组: [0]→ head0 [1]→ head1 [2]→ NULL ...
 ↓ ↓
 k1,v1 k3,v3
 ↓ ↓
 k2,v2 k4,v4
链地址法的关键参数是装载因子(load factor):
其中 是元素数, 是桶数。链地址法的查找时间:
- 成功查找:(期望遍历半条链)
- 失败查找:(期望遍历整条链)
开放地址法
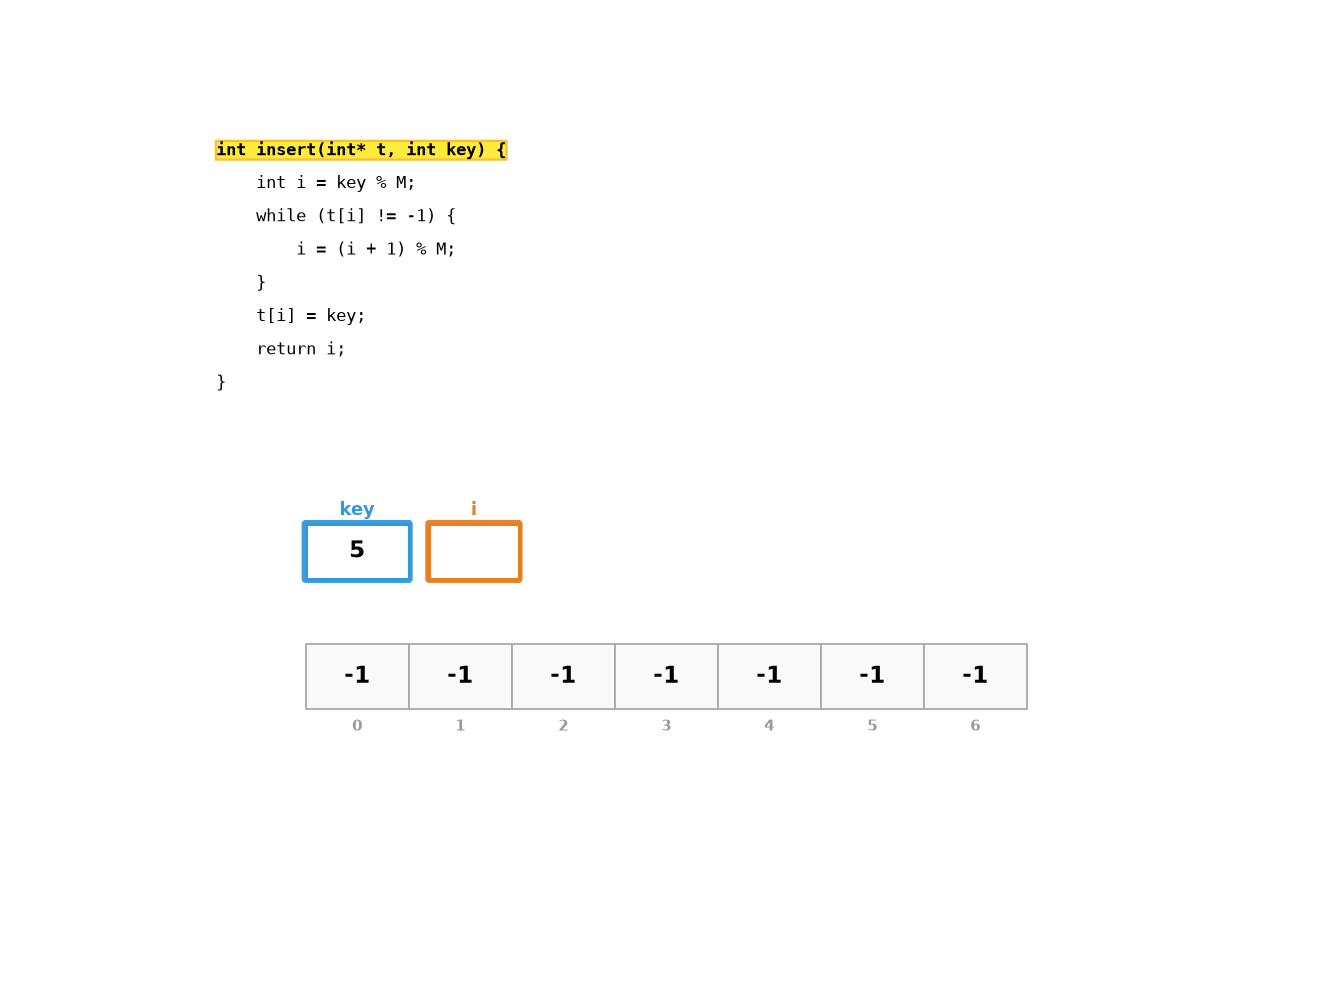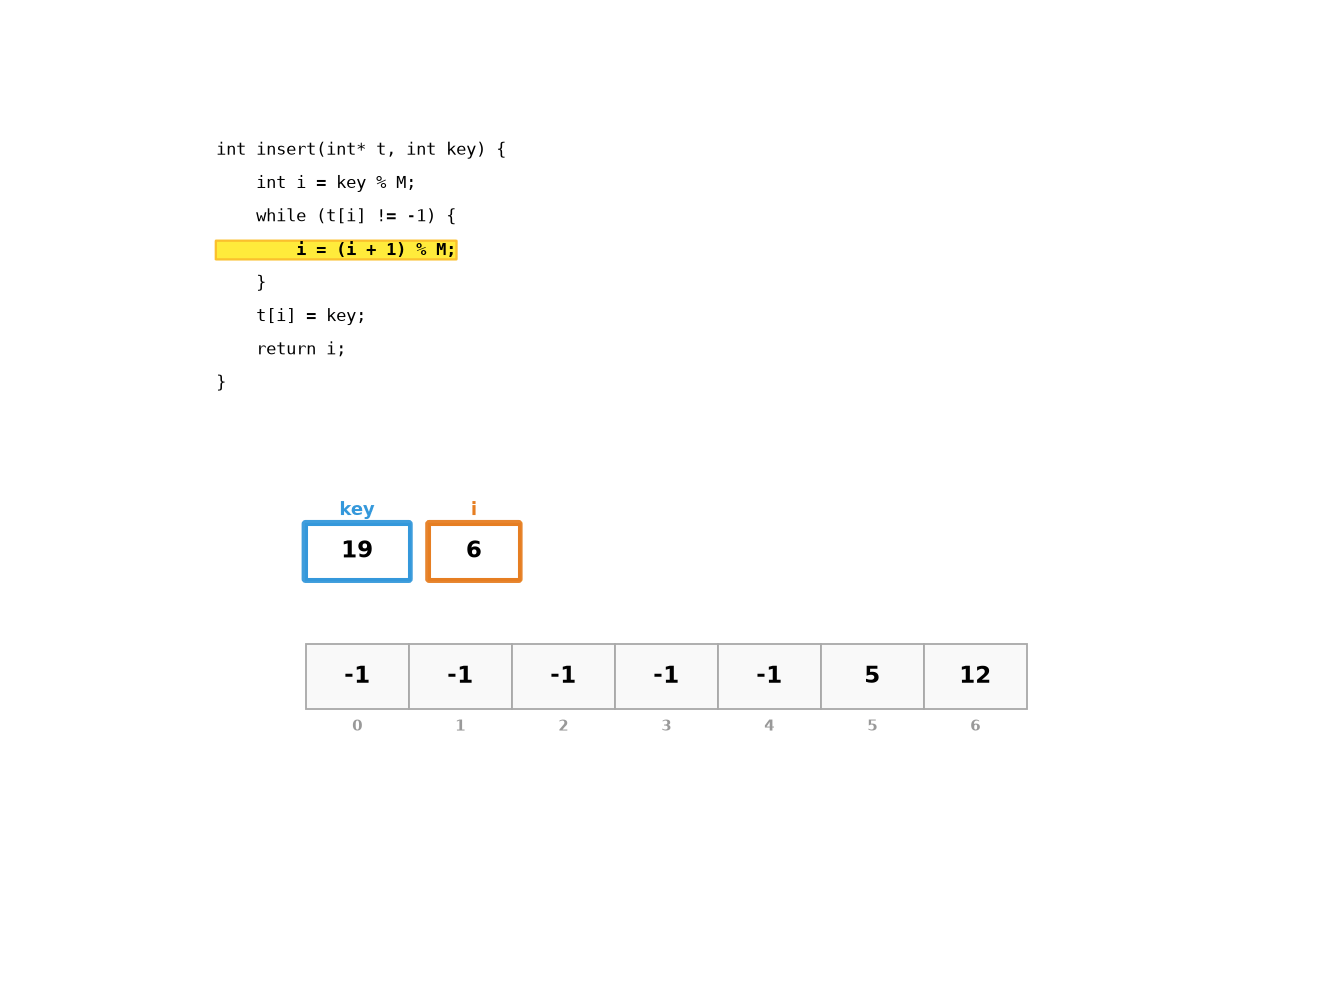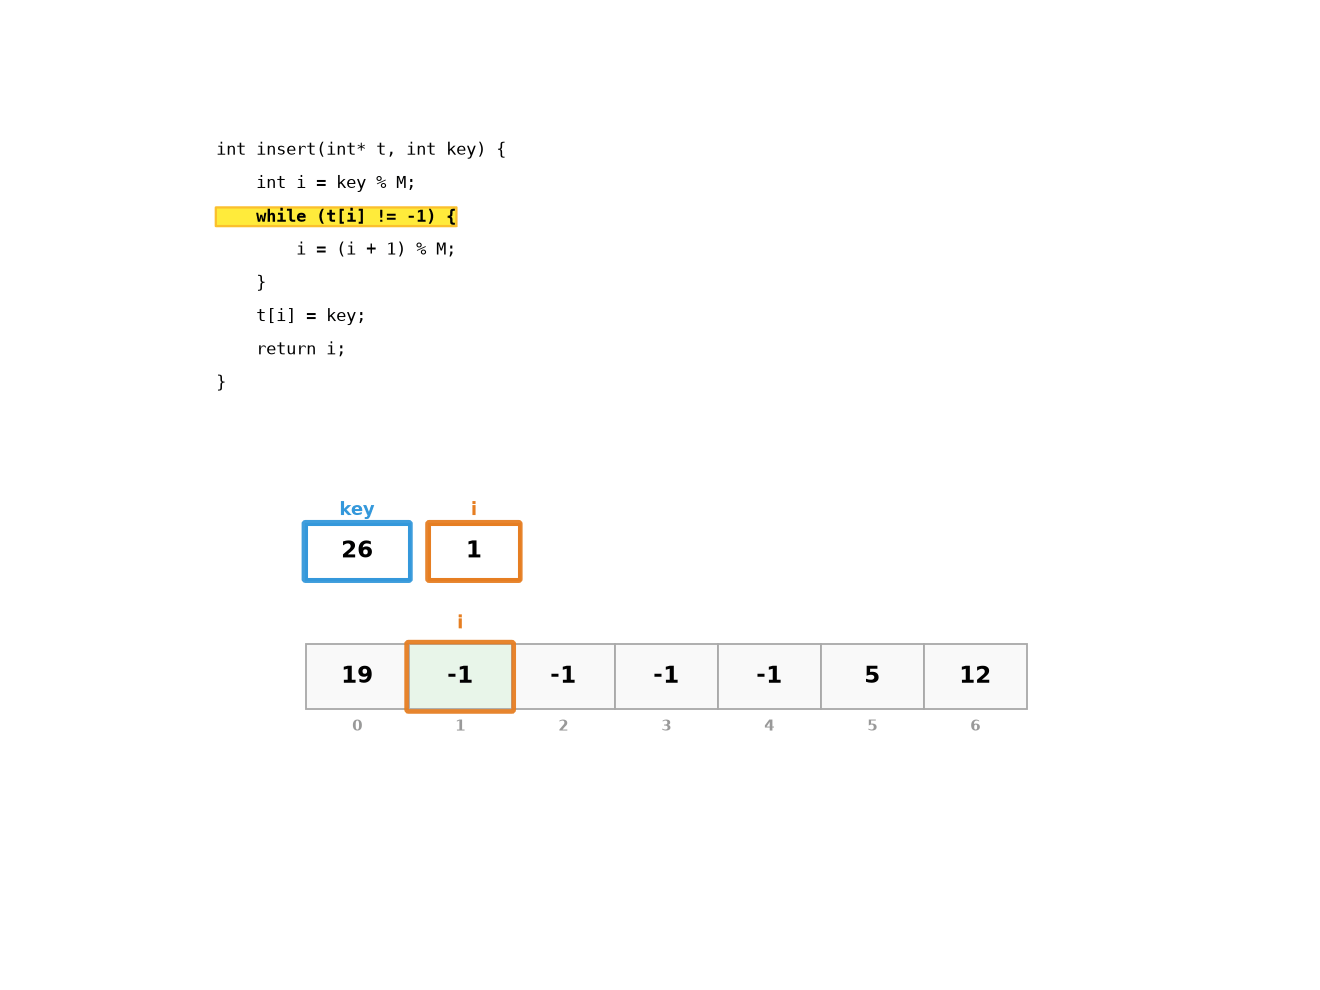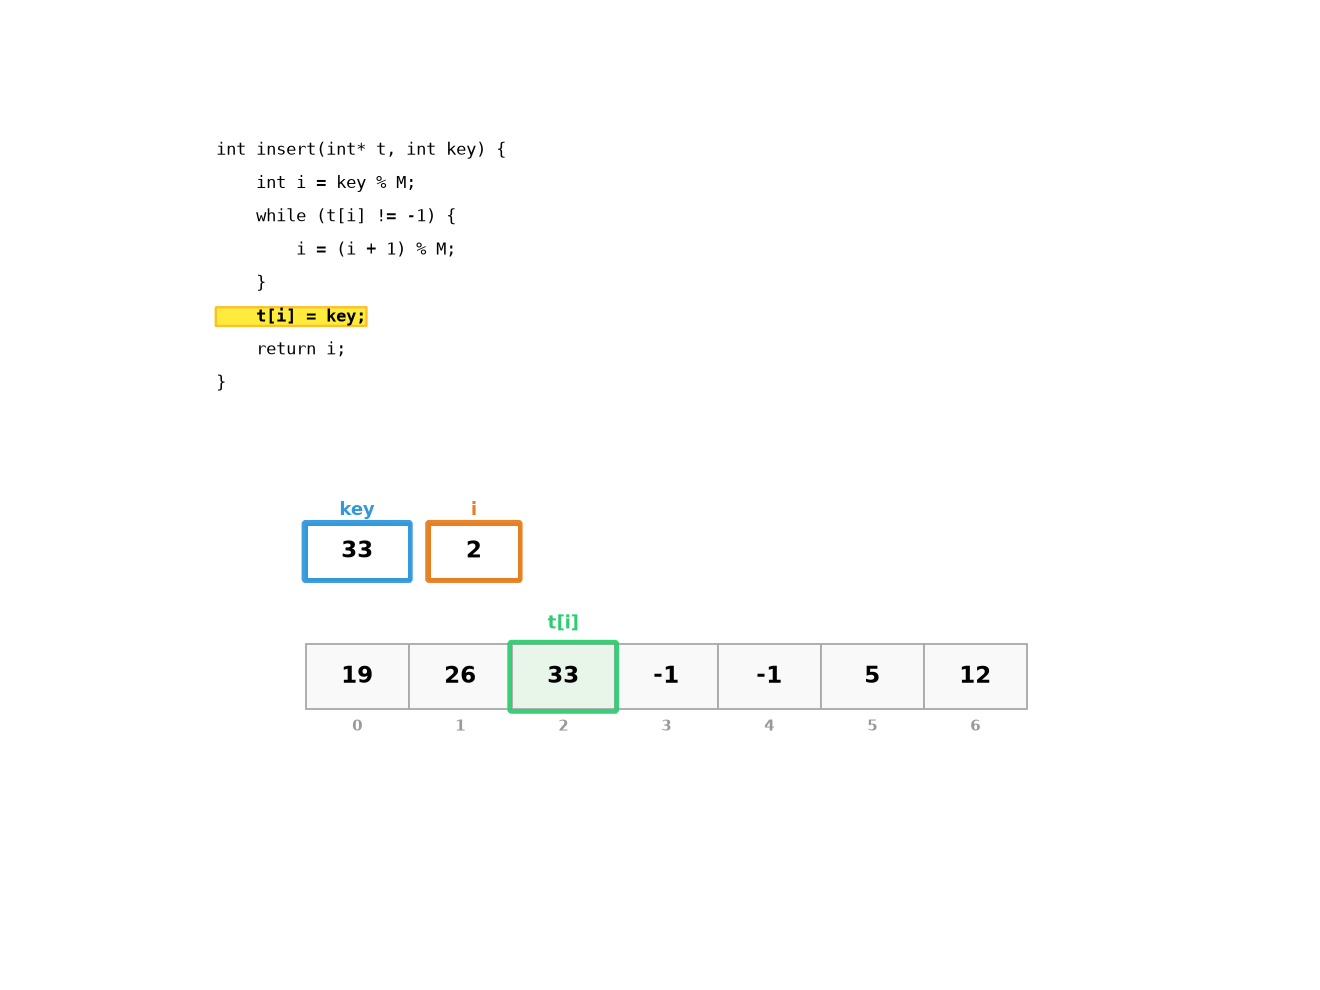
所有元素存储在桶数组中。发生冲突时探测下一个桶:
线性探测(CPU 缓存最友好):
二次探测(减少 clustering):
// 开放地址法数据结构
typedef enum { EMPTY, OCCUPIED, DELETED } SlotState;

typedef struct {
 int key, value;
 SlotState state;
} OASlot;

typedef struct {
 OASlot* table;
 size_t cap;
 size_t size;
} OAHashMap;

void oa_init(OAHashMap* m, size_t capacity) {
 m->cap = capacity;
 m->table = calloc(capacity, sizeof(OASlot));
 m->size = 0;
}

// 开放地址法查找(线性探测)
int oa_find(OAHashMap* m, int key) {
 int idx = hash(key) % m->cap;
 while (m->table[idx].state != EMPTY) {
  if (m->table[idx].state == OCCUPIED && m->table[idx].key == key)
   return idx; // 找到
  idx = (idx + 1) % m->cap; // 线性探测下一位置
 }
 return -1; // 未找到
}

int oa_insert(OAHashMap* m, int key, int value) {
 if (m->size * 100 >= m->cap * 75) return -1; // 装载因子 >= 0.75 拒绝插入
 int idx = hash(key) % m->cap;
 int first_deleted = -1;
 while (m->table[idx].state != EMPTY) {
  if (m->table[idx].state == DELETED && first_deleted == -1)
   first_deleted = idx;
  if (m->table[idx].state == OCCUPIED && m->table[idx].key == key) {
   m->table[idx].value = value;
   return 0; // 更新
  }
  idx = (idx + 1) % m->cap;
 }
 int target = first_deleted != -1 ? first_deleted : idx;
 m->table[target].key = key;
 m->table[target].value = value;
 m->table[target].state = OCCUPIED;
 m->size++;
 return 0;
}

int oa_delete(OAHashMap* m, int key) {
 int idx = hash(key) % m->cap;
 while (m->table[idx].state != EMPTY) {
  if (m->table[idx].state == OCCUPIED && m->table[idx].key == key) {
   m->table[idx].state = DELETED; // 墓碑标记,不能置 EMPTY(会打断探测链)
   m->size--;
   return 1;
  }
  idx = (idx + 1) % m->cap;
 }
 return 0;
}

void oa_destroy(OAHashMap* m) {
 free(m->table);
}开放地址法的装载因子限制:链地址法可以在 时工作(桶链增长)。开放地址法中 必须 < 1(桶数组大小限制了最大元素数)。当 时,线性探测的查找退化严重——失败查找的时间激增至 。通常当 时触发 rehash(扩容)。
缓存行为对比:
- 链地址法:每次沿着指针
entry->next是一个随机访存——链表节点分布在堆的各处 - 线性探测:当前桶的下一个桶在数组中位置 +1——几乎一定在 cache line 中。这使线性探测在 较低时性能极佳
冲突解决手算
链地址法: 个桶,插入键 15, 22, 8, 36, 14, 29,哈希函数 。
| 步 | 键 | 桶状态 | |
|---|---|---|---|
| 1 | 15 | 1 | [0]:∅ [1]:15 [2]:∅ [3]:∅ [4]:∅ [5]:∅ [6]:∅ |
| 2 | 22 | 1 | 桶 1 链:22→15(头插法) |
| 3 | 8 | 1 | 桶 1 链:8→22→15 |
| 4 | 36 | 1 | 桶 1 链:36→8→22→15(桶 1 已有 4 个元素!) |
| 5 | 14 | 0 | [0]:14 [1]:36→8→22→15 ... |
| 6 | 29 | 1 | 桶 1 链:29→36→8→22→15(5 个元素) |
装载因子 。查找 29 需遍历 1 次(链首即中),查找 15 需遍历 5 次(链尾)。平均成功查找 次比较。
线性探测:,插入同样的键 15, 22, 8, 36, 14, 29,。
| 步 | 键 | 探测过程 | 桶数组状态 | |
|---|---|---|---|---|
| 1 | 15 | 1 | 桶 1 空→放入 | [_,15,_,_,_,_,_] |
| 2 | 22 | 1 | 桶 1 占→探测 2 空→放入 | [_,15,22,_,_,_,_] |
| 3 | 8 | 1 | 桶 1 占→2 占→3 空→放入 | [_,15,22,8,_,_,_] |
| 4 | 36 | 1 | 桶 1 占→2 占→3 占→4 空→放入 | [_,15,22,8,36,_,_] |
| 5 | 14 | 0 | 桶 0 空→放入 | [14,15,22,8,36,_,_] |
| 6 | 29 | 1 | 桶 1 占→2 占→…→5 空→放入 | [14,15,22,8,36,29,_] |
注意:6 个键全部挤在桶 0-5,桶 6 始终空闲——这就是线性探测的主聚类(primary clustering)问题:连续被占的桶形成”长串”,新键的探测距离越来越长。
自测:冲突解决
,链地址法,插入 10, 22, 31, 4, 15, 28, 17, 53,。① 画出最终的桶数组。② 查找 28 的比较次数。③ 查找 60(不在表中)的比较次数。
答案:
① 桶号:10→3, 22→1, 31→3, 4→4, 15→1, 28→0, 17→3, 53→4
[0]: 28
[1]: 15→22
[2]: ∅
[3]: 17→31→10
[4]: 53→4
[5]: ∅
[6]: ∅
② 查找 28:桶 0 链首即中 → 1 次比较。
③ 查找 60:,遍历桶 4 链(53→4,2 次比较)未命中,返回”不在” → 2 次比较。
冲突的数学:生日悖论
在均匀哈希假设下,当 个桶中随机分配 个键时,第一次碰撞的期望出现时间约为 。这与直觉——需要填满约 才碰撞——完全不同。这是生日悖论(birthday paradox)的结果:
当 时,。对于 (生日的 365 天), 人时碰撞概率约 50%——与直觉(约 183 人)相差近 8 倍。对于哈希表,这意味着即使在远低于满负载时,碰撞也不可避免。哈希表的正确性保证不在”避免碰撞”,而在”处理碰撞的效率”。
深入底层
哈希表 rehash 的代价
当装载因子超过阈值时,分配大小约 2 倍的新桶数组,然后必须将每个旧元素重新哈希并插入新表。这是一个 操作——代价与元素总数成正比。
扩容是哈希表的主要性能陷阱。考虑以下场景:1 千万元素插入,每次 达 0.75 时扩容。总共约 次 rehash,最后一次 rehash 涉及 1 千万元素——这 20 次 rehash 累积的时间和 ≈ 2 千万次元素搬移。即便插入本身是 O(1) 均摊,rehash 的物理时间通常在低频插入中察觉不到,在高频插入中成为尖锐的性能尖峰。
现代哈希表设计:Swiss Table
C++ absl::flat_hash_map 和 Rust 的 hashbrown::HashMap 使用的 Swiss Table 是一种改进的开放地址法:
- 元数据字节数组(metadata)独立于数据存储,每个字节 = 1 个桶的状态信息
- SIMD 一次比较 16 字节的元数据,同时检查 16 个桶——大幅减少分支和 cache miss
- 桶内使用 SSE/AVX 的
_mm_cmpeq_epi8同时做 16 个字节的比较——这是 SIMD + 哈希表的结合,利用现代 CPU 的 16/32 字节向量寄存器加速探测
Swiss Table 将”检查下一个桶”的开销从每步 1 次比较降为每 16 步 1 次 SSE 指令——对 的查找加速了约 3-5 倍。
布隆过滤器(Bloom Filter)
布隆过滤器是哈希表思想的极简应用——不是”存储键值对”,而是”判断一个键是否可能在集合中”:
- 分配 位的位数组,初始全 0
- 插入键 时,对 计算 个不同的哈希值 ,将对应位设为 1
- 查询时,若所有 对应的位都是 1,回答”可能在”;若有任一为 0,回答”一定不在”
布隆过滤器是有损的:它可能存在假阳性(误报”可能在”),但不可能存在假阴性(不可能将存在键回答为”不在”)。这个性质使布隆过滤器广泛应用于缓存过滤、不良 URL 过滤、数据库布隆索引。假阳性率由 、 和哈希函数数 共同决定:
一致性哈希(Consistent Hashing)
在分布式系统中,当桶(节点)数量动态变化时,传统哈希的 在 改变时会导致绝大多数键重新映射。一致性哈希将键空间 视为一个环,节点和键均被哈希到环上。键 存储在环上顺时针方向第一个节点上。当节点增删时,只有其直接相邻节点上的键需要重新分配——影响范围降到 而非 。
一致性哈希是分布式缓存系统(Memcached、Redis Cluster)、CDN 和分布式存储系统的基石。
实现
链地址法 HashMap
#include <stdlib.h>

typedef struct Entry {
 int key, value;
 struct Entry* next;
} Entry;

typedef struct {
 Entry** buckets;
 size_t bucket_count;
 size_t size;
 float max_load_factor;
} HashMap;

static size_t hash(int key, size_t mod) {
 return (size_t)((unsigned)key * 2654435761ULL) % mod; // Knuth 乘法哈希
}

void hm_init(HashMap* m, size_t initial) {
 m->bucket_count = initial ? initial : 16;
 m->buckets = calloc(m->bucket_count, sizeof(Entry*));
 m->size = 0;
 m->max_load_factor = 0.75f;
}

static void hm_rehash(HashMap* m) {
 size_t old_cap = m->bucket_count;
 Entry** old_buckets = m->buckets;
 m->bucket_count *= 2;
 m->buckets = calloc(m->bucket_count, sizeof(Entry*));
 for (size_t i = 0; i < old_cap; i++) {
 Entry* entry = old_buckets[i];
 while (entry) {
 Entry* next = entry->next;
 size_t idx = hash(entry->key, m->bucket_count);
 entry->next = m->buckets[idx];
 m->buckets[idx] = entry;
 entry = next;
 }
 }
 free(old_buckets);
}

int hm_put(HashMap* m, int key, int value) {
 if ((float)m->size / m->bucket_count >= m->max_load_factor)
 hm_rehash(m);
 size_t idx = hash(key, m->bucket_count);
 for (Entry* e = m->buckets[idx]; e; e = e->next)
 if (e->key == key) { e->value = value; return 0; } // 更新
 Entry* new_entry = malloc(sizeof(Entry));
 new_entry->key = key; new_entry->value = value;
 new_entry->next = m->buckets[idx];
 m->buckets[idx] = new_entry;
 m->size++;
 return 0;
}

int hm_get(const HashMap* m, int key, int* out) {
 size_t idx = hash(key, m->bucket_count);
 for (Entry* e = m->buckets[idx]; e; e = e->next)
  if (e->key == key) { *out = e->value; return 1; }
 return 0;
}

int hm_remove(HashMap* m, int key) {
 size_t idx = hash(key, m->bucket_count);
 Entry** pp = &m->buckets[idx];
 while (*pp) {
  if ((*pp)->key == key) {
   Entry* del = *pp;
   *pp = del->next;
   free(del);
   m->size--;
   return 1;
  }
  pp = &(*pp)->next;
 }
 return 0;
}

size_t hm_size(const HashMap* m) {
 return m->size;
}

int hm_contains(const HashMap* m, int key) {
 size_t idx = hash(key, m->bucket_count);
 for (Entry* e = m->buckets[idx]; e; e = e->next)
  if (e->key == key) return 1;
 return 0;
}

int* hm_keys(const HashMap* m, size_t* out_len) {
 int* keys = malloc(m->size * sizeof(int));
 size_t j = 0;
 for (size_t i = 0; i < m->bucket_count; i++)
  for (Entry* e = m->buckets[i]; e; e = e->next)
   keys[j++] = e->key;
 *out_len = m->size;
 return keys;
}

void hm_destroy(HashMap* m) {
 for (size_t i = 0; i < m->bucket_count; i++) {
 Entry* e = m->buckets[i];
 while (e) { Entry* next = e->next; free(e); e = next; }
 }
 free(m->buckets);
}
各语言标准库对比
| 语言 | 类型 | 实现方式 |
|---|---|---|
| C | 无 | 手写 |
| C++ | std::unordered_map | 链地址法(桶数组 + 链表) |
| Java | HashMap | 链地址法(链表→红黑树 ≥8) |
| Python | dict | 开放地址法 + 伪随机探测 |
| Rust | HashMap | Swiss Table(SIMD 加速开放地址) |
| Go | map | 链地址法 + bucket 批量分配 |
应用场景
- 去重:用哈希表检查元素是否已处理
- 计数:统计词频、字符频率——键是单词,值 = 出现次数
- 缓存:内存缓存用哈希表按 key 查找——O(1) 的时间复杂度是缓存的根本前提
- 数据库索引:哈希索引(如 Memory 引擎的 HASH 索引、RocksDB 的哈希表 memtable)用于等值查找
- 符号表:编译器前端使用哈希表存储标识符(变量名→类型/作用域/地址)
练习
动手实验
| 编号 | 题目 | 说明 |
|---|---|---|
| E1 | 装载因子 vs 查找速度 | 实现链地址法 HashMap,固定桶数为 1000,插入元素数从 100 递增到 10000( 从 0.1 到 10)。记录每次查找到不存在的键的平均链长与查找耗时。绘制 -耗时曲线,验证查找失败与 成正比 |
| E2 | 线性探测 vs 二次探测 主聚类 | 实现线性探测和二次探测两个版本的开放地址法 HashMap。分别插入 1000 个随机键到 2000 桶的表中,统计每次插入的探测次数分布。用直方图对比两者的聚类程度 |
| E3 | 哈希函数雪崩效应可视化 | 固定哈希表大小为 256,对 256 个顺序键(0..255)用不同哈希函数计算索引。画出索引分布的直方图。验证乘法哈希在 256 桶上的均匀性 vs key % 256 对顺序键的完美分布但对抗输入脆弱 |