建议先阅读: A 数组, K 树 BST AVL, O 哈希表
原理
查找是什么
在一本 1000 页的字典中找”algorithm”——你不会从第 1 页翻起。你知道字典是有序的,直接翻到 A 开头的区域,几秒就找到了。查找的本质就是:在一组数据中找到目标元素的位置。查找的效率直接决定了系统的响应速度——Redis 的 GET 操作、MySQL 的索引查询、编译器的符号表查找——底层都是查找算法。
与其他数据结构的关系:
| 查找方式 | 底层结构 | 时间复杂度 | 适用场景 |
|---|---|---|---|
| 顺序查找 | 无序数组/链表 | 数据无序或极小 | |
| 二分查找 | 有序数组 | 静态有序表 | |
| BST 查找 | 二叉搜索树 | 平均 | 动态有序表 |
| 哈希查找 | 哈希表 | 平均 | 只需精确匹配 |
| B 树查找 | B 树/B+ 树 | 磁盘存储 |
查找在哪里
- 数据库索引:MySQL 的 B+ 树索引将 全表扫描降为 索引查找——亿级数据毫秒级响应
- 编译器符号表:遇到变量名时 O(1) 哈希查找类型和作用域
- 搜索引擎:倒排索引 + 二分查找定位包含关键词的文档
- 电话簿/字典:有序数据的二分查找——每次排除一半
- 游戏碰撞检测:空间索引(四叉树/B 树)快速查找邻近对象
平均查找长度(ASL)
ASL(Average Search Length)是衡量查找算法效率的核心指标——找到目标元素的平均比较次数。
成功 ASL:找到表中已存在的元素所需的平均比较次数。
其中 是查找第 个元素所需的比较次数。
失败 ASL:确认目标不在表中所需的平均比较次数。
其中 是第 个失败区间所需的比较次数。
顺序查找
原理
从第一个元素开始逐个比较,直到找到目标或遍历完整个表。对数据没有任何要求——无序、有序均可。
数学分析
成功 ASL:等概率查找每个元素,第 个元素需要 次比较。
失败 ASL:需要遍历完整个表才能确认不在。
当 时,成功 ASL = 500.5,即平均需要比较 500 次。
代码
int linear_search(int* arr, int n, int target) {
 for (int i = 0; i < n; i++)
 if (arr[i] == target) return i;
 return -1;
}
优化:哨兵查找
将 arr[0] 作为哨兵(sentinel),把 target 放在 arr[0],从后往前查找——省去每次循环的边界检查 i < n:
int sentinel_search(int* arr, int n, int target) {
 arr[0] = target; // 哨兵
 int i = n;
 while (arr[i] != target) i--;
 return i; // i=0 表示未找到
}
哨兵版本将每次循环的比较从 2 次(边界+值)降为 1 次(仅值),在 很大时性能提升约 30%。
二分查找
原理
有序表中,每次取中间元素与目标比较——若相等则找到;若目标更小则在左半区继续;若目标更大则在右半区继续。每次排除一半, 次即可确定。
判定树
二分查找的比较过程可以用一棵判定树(Decision Tree)描述:每个内部节点是一次比较,左子树是”更小”的分支,右子树是”更大”的分支,叶子节点是”未找到”。
对于有序表 [1, 3, 5, 7, 9, 11, 13](n=7),判定树:
        7
       / \
      3   11
     / \ / \
    1  5 9  13
   /\ /\ /\ /\
  NIL NIL NIL NIL NIL NIL NIL NIL
- 成功查找:从根到目标节点的路径长度
- 失败查找:从根到 NIL 叶子的路径长度
4 种变体
二分查找有 4 种常见写法,区别在于循环条件和区间定义:
| 变体 | 循环条件 | 区间 | 适用场景 |
|---|---|---|---|
左闭右闭 [l, r] | l <= r | r = m-1, l = m+1 | 最常用 |
左闭右开 [l, r) | l < r | r = m, l = m+1 | STL lower_bound |
左开右闭 (l, r] | l < r | l = m+1, r = m | 少用 |
左开右开 (l, r) | l+1 < r | l = m, r = m | 少用 |
左闭右闭实现(最推荐)
int binary_search(int* arr, int n, int target) {
 int l = 0, r = n - 1;
 while (l <= r) {
 int m = l + (r - l) / 2; // 防溢出
 if (arr[m] == target) return m;
 else if (arr[m] < target) l = m + 1;
 else r = m - 1;
 }
 return -1; // 未找到
}
查找上下界
实际工程中很少只找”等于 target 的位置”——更常见的是找”第一个 ≥ target 的位置”(lower_bound)和”第一个 > target 的位置”(upper_bound):
// lower_bound: 第一个 >= target 的位置
int lower_bound(int* arr, int n, int target) {
 int l = 0, r = n; // 注意:r = n(允许越界)
 while (l < r) {
 int m = l + (r - l) / 2;
 if (arr[m] < target) l = m + 1;
 else r = m;
 }
 return l;
}

// upper_bound: 第一个 > target 的位置
int upper_bound(int* arr, int n, int target) {
 int l = 0, r = n;
 while (l < r) {
 int m = l + (r - l) / 2;
 if (arr[m] <= target) l = m + 1;
 else r = m;
 }
 return l;
}
数学分析
成功 ASL:判定树有 个内部节点,等概率查找时:
失败 ASL:判定树有 个叶子节点(失败区间):
当 时,成功 ASL ≈ 9,失败 ASL = 10——比顺序查找的 500 快了 50 倍。
二分查找手算轨迹
有序表 [1, 3, 5, 7, 9, 11, 13, 15, 17, 19](n=10),查找 target=13:
| 步 | l | r | m | arr[m] | 比较 | 动作 |
|---|---|---|---|---|---|---|
| 1 | 0 | 9 | 4 | 9 | 9 < 13 | l = 5 |
| 2 | 5 | 9 | 7 | 15 | 15 > 13 | r = 6 |
| 3 | 5 | 6 | 5 | 11 | 11 < 13 | l = 6 |
| 4 | 6 | 6 | 6 | 13 | 13 = 13 | 返回 6 |
4 步找到()。
查找 target=8(不存在):
| 步 | l | r | m | arr[m] | 比较 | 动作 |
|---|---|---|---|---|---|---|
| 1 | 0 | 9 | 4 | 9 | 9 > 8 | r = 3 |
| 2 | 0 | 3 | 1 | 3 | 3 < 8 | l = 2 |
| 3 | 2 | 3 | 2 | 5 | 5 < 8 | l = 3 |
| 4 | 3 | 3 | 3 | 7 | 7 < 8 | l = 4 |
| 5 | 4 | 3 | — | — | l > r | 返回 -1 |
实际循环 4 次(步 1-4),步 5 是退出判断——总比较 4 次确认不存在。
核心推演:二分查找
有序表 [2, 5, 8, 12, 16, 23, 38, 56, 72, 91](n=10),查找 target=23。写出每步 l, r, m 的变化。
答案:
| 步 | l | r | m | arr[m] | 动作 |
|---|---|---|---|---|---|
| 1 | 0 | 9 | 4 | 16 | 16 < 23 → l=5 |
| 2 | 5 | 9 | 7 | 56 | 56 > 23 → r=6 |
| 3 | 5 | 6 | 5 | 23 | 23 = 23 → 返回 5 |
共 3 步(,实际 3 步因为 23 恰好在中间附近)。
核心推演:ASL 计算
有序表 [1, 2, 3, 4, 5, 6, 7](n=7),画出二分查找判定树。① 求成功 ASL。② 求失败 ASL。
答案:
判定树:
       4
      / \
     2   6
    / \ / \
   1  3 5  7
① 成功 ASL = (1×1 + 2×2 + 4×3) / 7 = (1+4+12)/7 = 17/7 ≈ 2.43
② 失败 ASL = (8×3) / 8 = 3(8 个叶子都在第 3 层)
注:完全二叉树判定树的失败 ASL = [正确]
插值查找
原理
二分查找每次固定取中间位置——但如果我们知道数据的分布,可以更聪明地选择下一个位置。插值查找根据目标值在范围中的比例来估算位置:
类比查字典:找”apple”不会翻到字典正中间——你会估算 A 开头在字典前 1/26 的位置。
代码
int interpolation_search(int* arr, int n, int target) {
 int l = 0, r = n - 1;
 while (l <= r && target >= arr[l] && target <= arr[r]) {
 if (l == r) return arr[l] == target ? l : -1;
 int m = l + (int)((double)(target - arr[l]) / (arr[r] - arr[l]) * (r - l));
 if (arr[m] == target) return m;
 if (arr[m] < target) l = m + 1;
 else r = m - 1;
 }
 return -1;
}
数学分析
均匀分布下,插值查找的 ASL:
比二分查找的 更快——但前提是数据均匀分布。如果数据分布极度不均匀(如指数分布),插值查找可能退化为 。
手算轨迹
有序表 [1, 3, 5, 7, 9, 11, 13, 15, 17, 19](均匀分布),查找 target=13:
| 步 | l | r | arr[l] | arr[r] | m 计算 | arr[m] | 动作 |
|---|---|---|---|---|---|---|---|
| 1 | 0 | 9 | 1 | 19 | 0+(13-1)/(19-1)×9 = 6 | 13 | 返回 6 |
一步命中!插值查找在均匀分布下可以直接”跳”到目标附近。
查找 target=8(不存在):
| 步 | l | r | arr[l] | arr[r] | m 计算 | arr[m] | 动作 |
|---|---|---|---|---|---|---|---|
| 1 | 0 | 9 | 1 | 19 | 0+(8-1)/(19-1)×9 ≈ 3 | 7 | 7 < 8 → l=4 |
| 2 | 4 | 9 | 9 | 19 | 4+(8-9)/(19-9)×5 ≈ 4 | 9 | 9 > 8 → r=3 |
| 3 | 4 | 3 | — | — | l > r | — | 返回 -1 |
斐波那契查找
原理
斐波那契查找利用斐波那契数列来分割区间——当表长 时,将表分为左半部分 个元素和右半部分 个元素。优势在于:只涉及加减法,不涉及除法(在某些硬件上除法很慢)。
斐波那契数列
序列为:0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, …
代码
void fib(int* f, int max) {
 f[0] = 0; f[1] = 1;
 for (int i = 2; i <= max; i++)
 f[i] = f[i-1] + f[i-2];
}

int fib_search(int* arr, int n, int target) {
 int f[32]; // F(31) 足够覆盖 2^31
 fib(f, 31);

 int k = 0;
 while (f[k] - 1 < n) k++; // 找到最小的 k 使得 F(k) >= n+1

 int* padded = malloc(f[k] * sizeof(int)); // 补齐到 F(k)-1
 memcpy(padded, arr, n * sizeof(int));
 for (int i = n; i < f[k] - 1; i++)
 padded[i] = arr[n - 1]; // 用最后一个元素填充

 int l = 0, r = f[k] - 1;
 while (l <= r) {
 int mid = l + f[k-1] - 1;
 if (padded[mid] == target) {
 free(padded);
 return mid < n ? mid : -1; // 检查是否在有效范围内
 }
 if (padded[mid] > target) {
 r = mid - 1;
 k = k - 1; // 左半区:F(k-1)-1 个元素
 } else {
 l = mid + 1;
 k = k - 2; // 右半区:F(k-2)-1 个元素
 }
 }
 free(padded);
 return -1;
}
数学分析
斐波那契查找的 ASL 与二分查找接近,但比较次数的常数因子略大。它的优势在于:
- 只用加减法:没有除法和乘法,在嵌入式/老旧硬件上有优势
- 分布更均匀:分割点不在正中间,而是按黄金比例(≈0.618)分割,对某些分布更友好
手算轨迹
有序表 [1, 3, 5, 7, 9, 11, 13, 15, 17, 19](n=10),查找 target=13:
斐波那契数列:F(0)=0, F(1)=1, F(2)=1, F(3)=2, F(4)=3, F(5)=5, F(6)=8, F(7)=13
k=7,F(7)-1=12 ≥ 10,需要补 2 个元素。补齐后表长 12。
| 步 | l | r | mid | arr[mid] | 比较 | 动作 | k |
|---|---|---|---|---|---|---|---|
| 1 | 0 | 11 | 0+8-1=7 | 15 | 15 > 13 | r=6 | 6 |
| 2 | 0 | 6 | 0+5-1=4 | 9 | 9 < 13 | l=5 | 4 |
| 3 | 5 | 6 | 5+3-1=7 | — | l>r | 返回 -1? | — |
等等,mid=7 但 arr[7]=15(补齐后),r=6 所以 mid 不应超出。让我修正:
步1:mid = 0 + F(6)-1 = 0+8-1 = 7,arr[7]=15 > 13 → r=6, k=6
步2:mid = 0 + F(5)-1 = 0+5-1 = 4,arr[4]=9 < 13 → l=5, k=4
步3:mid = 5 + F(3)-1 = 5+2-1 = 6,arr[6]=13 = 13 → 返回 6
3 步找到。
分块查找(索引顺序查找)
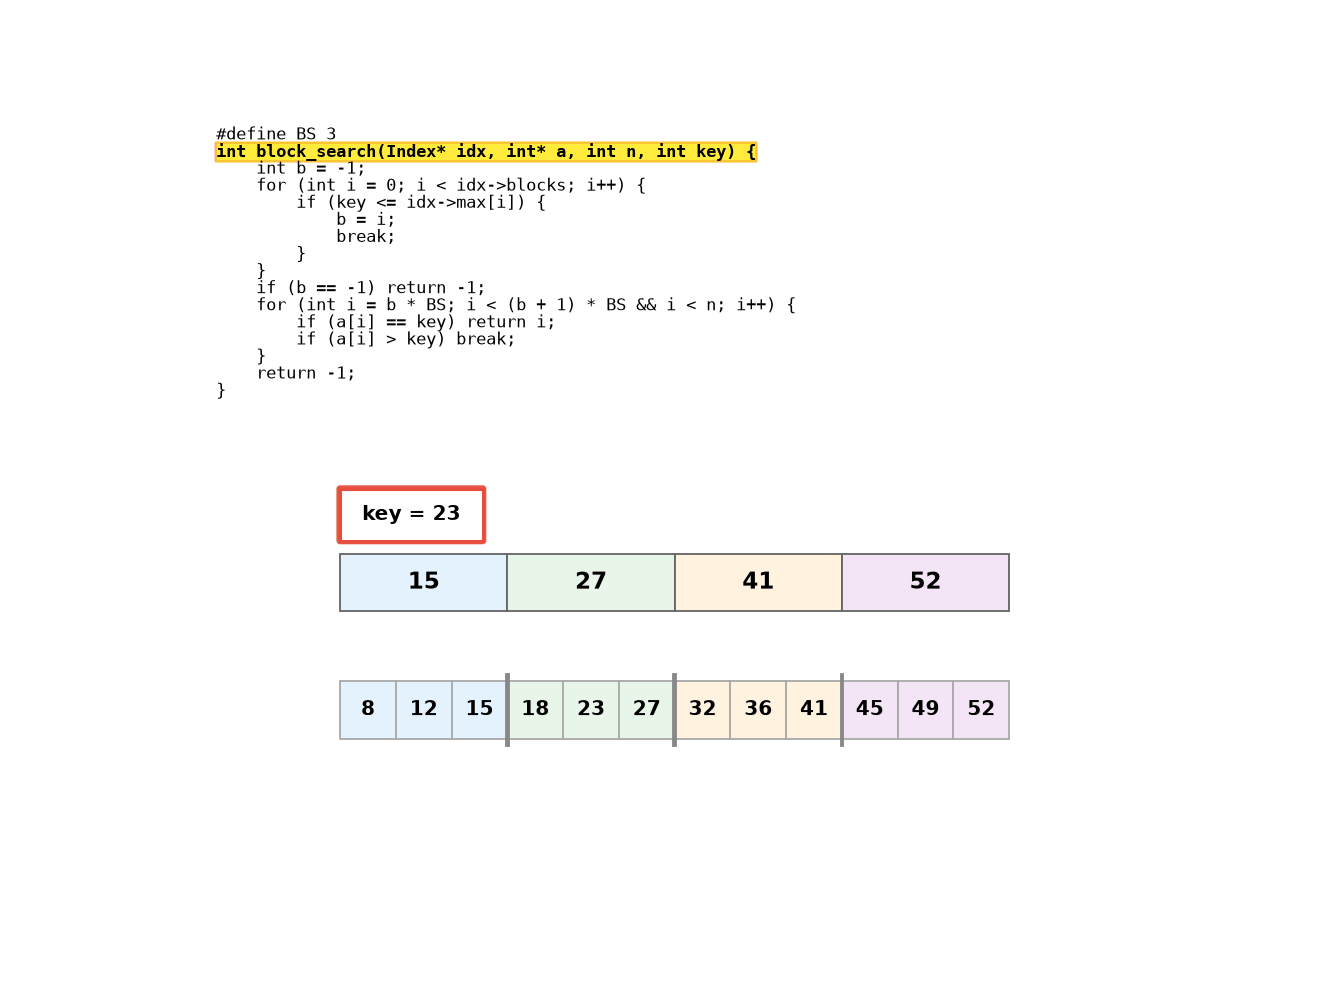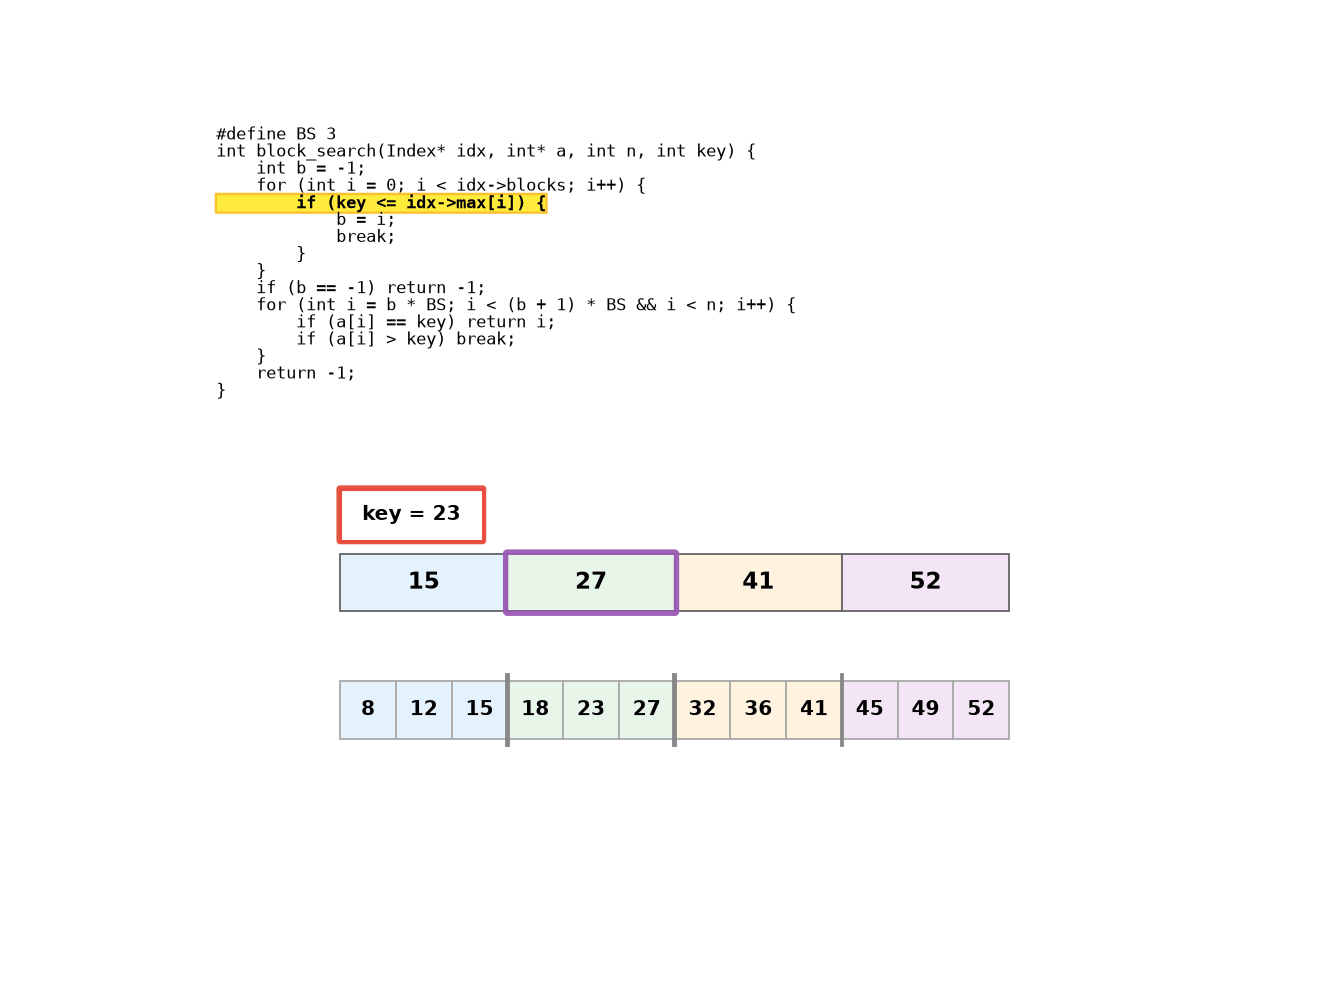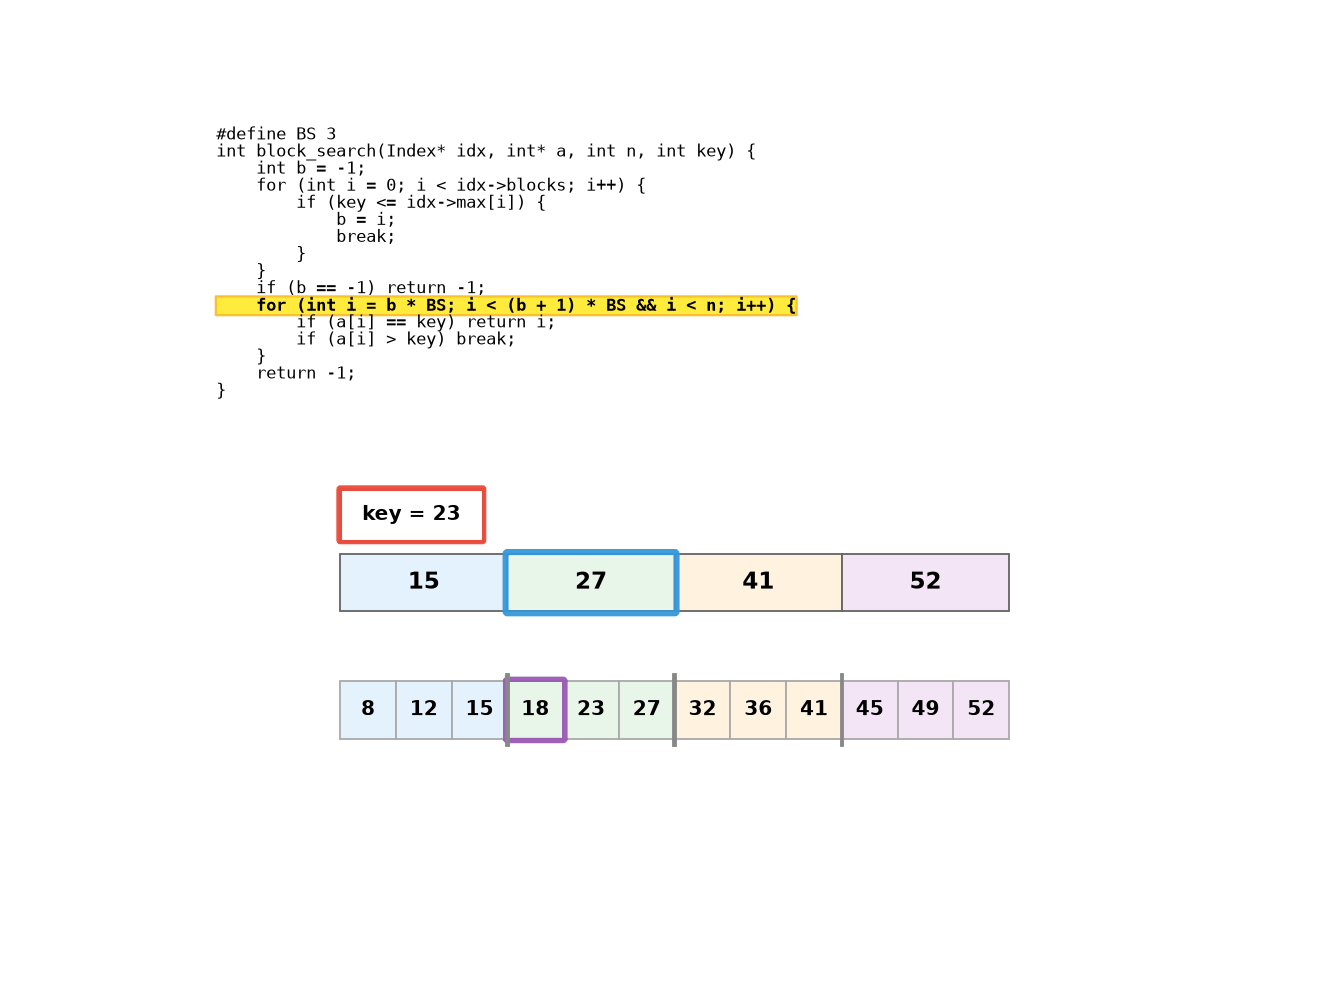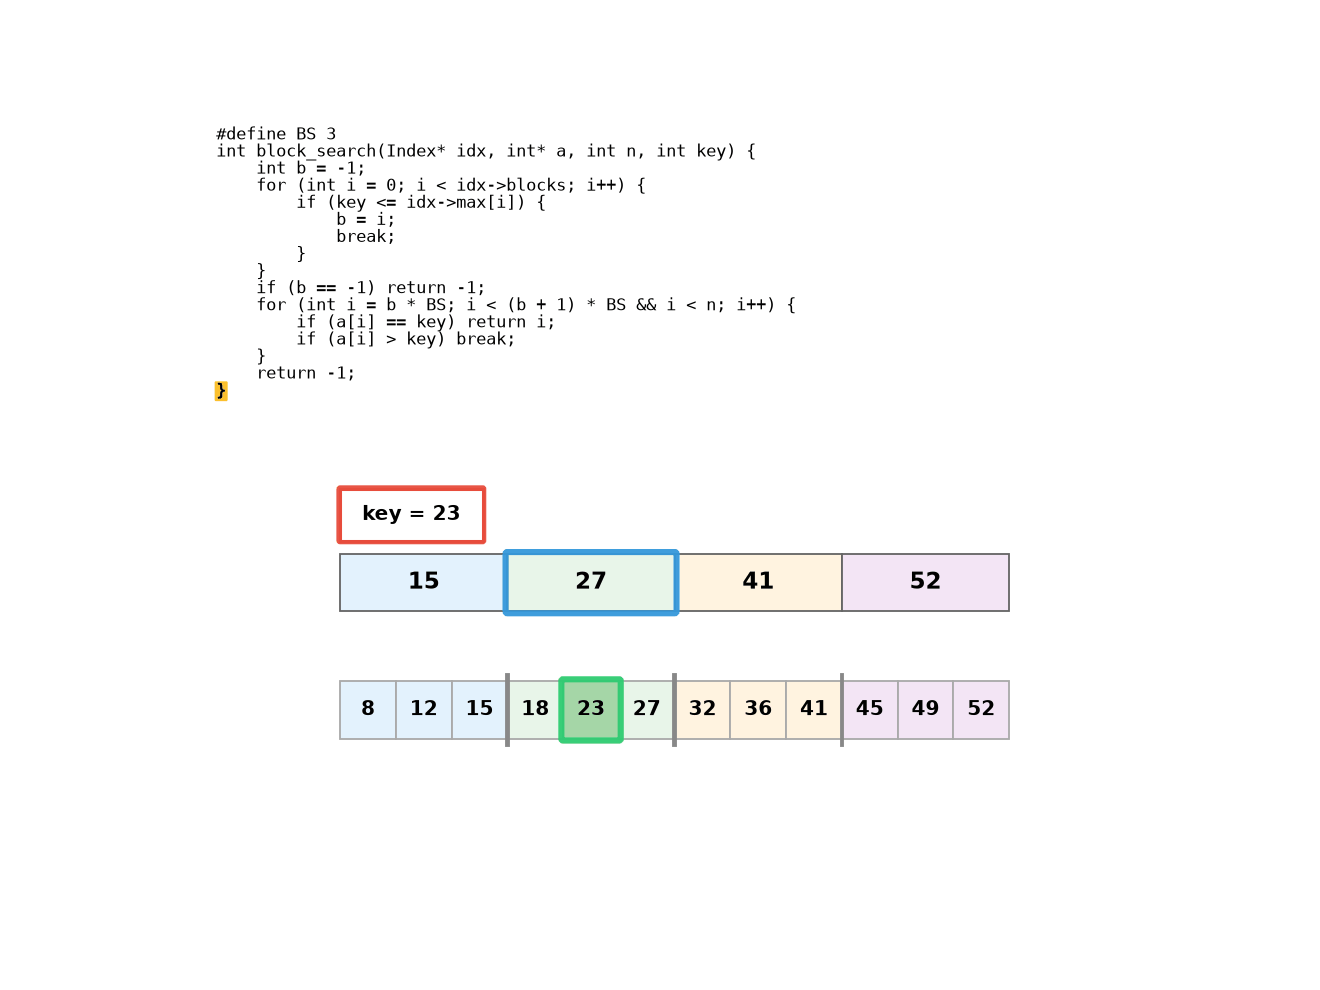
顺序查找太慢、二分查找要求全局有序——分块查找是二者的折中:把表分成若干块,块间有序、块内可以无序(前一块的最大值小于后一块的最小值)。
原理
维护一张索引表,每项记录该块的最大值。查找分两步:先在索引表中确定 key 可能所在的块,再在该块内顺序查找。
#define BS 3

typedef struct {
    int blocks;
    int max[10];
} Index;

int block_search(Index* idx, int* a, int n, int key) {
    int b = -1;
    for (int i = 0; i < idx->blocks; i++) {
        if (key <= idx->max[i]) {
            b = i;
            break;
        }
    }
    if (b == -1) return -1;
    for (int i = b * BS; i < (b + 1) * BS && i < n; i++) {
        if (a[i] == key) return i;
        if (a[i] > key) break;
    }
    return -1;
}
数学分析
设 个元素分为 块、每块 个(),索引表与块内都用顺序查找:
- 索引查找平均比较 次,块内平均 次
- 总平均查找长度
- 当 时取最小:
分块查找适合动态变化的场景:块内插入删除只影响本块,不必像二分查找那样维护全局有序。若索引表本身改用二分查找,ASL 可进一步降为 。
查找算法对比
| 算法 | 前提条件 | 成功 ASL | 失败 ASL | 时间复杂度 | 特点 |
|---|---|---|---|---|---|
| 顺序查找 | 无 | 最简单,无要求 | |||
| 分块查找 | 块间有序 | — | 兼顾动态与效率 | ||
| 二分查找 | 有序 | 最常用 | |||
| 插值查找 | 有序+均匀 | — | 均匀分布最优 | ||
| 斐波那契查找 | 有序 | — | 无除法 | ||
| BST 查找 | 二叉搜索树 | 平均 | — | 平均 | 动态 |
| 哈希查找 | 哈希表 | 平均 | — | 平均 | 最快,无序 |
何时用什么
- 数据无序 + 小规模:顺序查找
- 数据有序 + 静态:二分查找(首选)
- 数据有序 + 均匀分布 + 大规模:插值查找
- 嵌入式/无除法硬件:斐波那契查找
- 数据动态增删:BST / 红黑树 / 哈希表
- 磁盘存储:B 树 / B+ 树
实现
二分查找完整版(含 lower_bound/upper_bound)
#include <stdio.h>

// 标准二分:返回 target 的下标,不存在返回 -1
int bsearch(int* arr, int n, int target) {
 int l = 0, r = n - 1;
 while (l <= r) {
 int m = l + (r - l) / 2;
 if (arr[m] == target) return m;
 else if (arr[m] < target) l = m + 1;
 else r = m - 1;
 }
 return -1;
}

// lower_bound:第一个 >= target 的位置
int lower_bound(int* arr, int n, int target) {
 int l = 0, r = n;
 while (l < r) {
 int m = l + (r - l) / 2;
 if (arr[m] < target) l = m + 1;
 else r = m;
 }
 return l;
}

// upper_bound:第一个 > target 的位置
int upper_bound(int* arr, int n, int target) {
 int l = 0, r = n;
 while (l < r) {
 int m = l + (r - l) / 2;
 if (arr[m] <= target) l = m + 1;
 else r = m;
 }
 return l;
}

// 统计 target 出现次数
int count_occurrences(int* arr, int n, int target) {
 int first = lower_bound(arr, n, target);
 int last = upper_bound(arr, n, target);
 return last - first;
}
练习
| 题号 | 题目 | 说明 |
|---|---|---|
| 704 | 二分查找 | 标准二分 |
| 34 | 在排序数组中查找元素的第一个和最后一个位置 | lower/upper bound |
| 35 | 搜索插入位置 | lower bound |
| 278 | 第一个错误的版本 | 二分查找变体 |
| 4 | 寻找两个正序数组的中位数 | 二分查找高级 |
力扣 (LeetCode) 有对应题型,竞赛方向推荐力扣/Codeforces。
动手实验
| 编号 | 题目 | 说明 |
|---|---|---|
| E1 | 二分查找判定树可视化 | 对 n=15 的有序表,画出二分查找判定树。验证:成功 ASL = (1+2×2+4×3+8×4)/15 = 53/15 ≈ 3.53,失败 ASL = 4 |
| E2 | 插值查找 vs 二分查找 | 对均匀分布和指数分布两种数据,分别用插值查找和二分查找做 10 万次随机查找,对比耗时。验证:均匀分布时插值更快,非均匀时二分更稳 |
| E3 | 顺序查找哨兵优化 | 对 n=10000 的数组,分别用普通顺序查找和哨兵查找做 10 万次查找,对比耗时。验证哨兵优化约 30% 提速 |