字符串 (String)
建议先阅读:数组 — 字符串本质是字符数组,数组的缓存行为、寻址公式、边界问题在字符串中全部成立。
原理
什么是字符串:从直觉到形式化
先回答最基本的问题:字符串是什么?
日常语义里,字符串就是”一串文字”。但在数据结构层面,需要精确的定义:
字符串(String)是有限字符集 上的有限序列,记作 。
其中 是字符的集合(如 ASCII 的 128 个字符、Unicode 的百万级码点), 表示 上所有有限序列构成的集合(克莱尼星号闭包),空串 (长度为 0)也属于 。
这个定义拆开看有三个要点:
- 元素类型是字符——字符串首先是数组。上一章的寻址公式在这里原样成立: 只是 sizeof(char) 恒为 1,且字符数据天然连续,因此上一章讲的”顺序遍历吃满 cache line”在字符串上是默认成立的;
- 长度是核心属性——几乎所有字符串操作的复杂度都以长度 为变量;
- “长度约定”使它成为独立的数据结构——光有 char 数组还不够,数组本身不知道自己多长。字符串通过某种约定携带长度信息(C 用
\0哨兵,Pascal 用长度前缀)。字符串 = char 数组 + 长度约定,这个约定正是下一节两条技术路线全部分歧的根源。
形式化术语
设 ,以下术语贯穿全章(也是 KMP、后缀结构的语言基础):
| 术语 | 定义 | 示例( = "abcab") |
|---|---|---|
| 前缀 Prefix | , | "a"、"abca" |
| 后缀 Suffix | , | "b"、"cab" |
| 子串 Substring | ,连续一段 | "bca" |
| 子序列 Subsequence | 可跳字符但保序 | "acb" 是子序列但不是子串 |
| 真前缀/真后缀 | 不允许等于整串的前缀/后缀 | "ab" 是真前缀,"abcab" 不是 |
| Border | 既是真前缀又是真后缀的串 | "ab"——KMP 的 数组就是在求每个前缀的最长 Border |
特别区分子串与子序列:子串必须连续(对应内存上一段连续区间),子序列允许跳过中间字符。本章后面的编辑距离/LCS 处理的是子序列层面的变换,KMP 和后缀数组处理的是子串层面的定位——混淆这两个词是字符串问题中最常见的审题错误。
两种基本表示
字符串在计算机史上有两条主线:C 的 null-terminated(以 \0 结尾)和 Pascal 的 length-prefixed(长度前缀)。这两种设计的深层分歧不在于”多一个字节存长度”,而在于对硬件、安全性、效率的不同权衡。
| C 风格(Null-Terminated) | Pascal 风格(Length-Prefixed) | |
|---|---|---|
| 长度记录 | \0 (NUL, ASCII 0x00) 标记结束 | 开头若干字节存长度 |
| 获取长度 | — 必须扫描到 \0 | — 读长度字段 |
| 最大长度 | 受地址空间限制,无理论上限 | 受长度字段位数限制(1B→255, 4B→4GB) |
可否包含 \0 | 否 — 第一个 \0 被当作结束 | 是 — 长度独立于内容 |
| 代表 | C(char*)、Unix 文件路径 | C++ std::string (SSO 部分)、Pascal、Go、Rust |
graph LR
 subgraph "C 风格 — null-terminated"
 direction LR
 C0["'h' 0x68"] --> C1["'e' 0x65"] --> C2["'l' 0x6C"] --> C3["'l' 0x6C"] --> C4["'o' 0x6F"] --> CN["'\0' 0x00<br/>(sentinel)"]
 end
 subgraph "Pascal 风格 — length-prefixed"
 direction LR
 PL["len=5<br/>0x05"] --> P0["'h' 0x68"] --> P1["'e' 0x65"] --> P2["'l' 0x6C"] --> P3["'l' 0x6C"] --> P4["'o' 0x6F"]
 end
C 选择 null-terminated 的原因可以追溯到 PDP-11 汇编指令:当时的字符串处理指令(如 MOVC)原生支持扫描到 NUL 为止。此外,每个字符串只浪费 1 字节(\0),对于内存只有 32KB 的机器是重要考虑。这个历史选择的影响延续至今——Linux 内核中的所有路径名、设备名、文件系统元数据全部使用 null-terminated 字符串。
Pascal 选择 length-prefixed 的理由是类型安全——字符串长度是类型的一部分,编译器可以静态检查越界。但受限于当时的 1 字节长度字段(最多 255 字符),这种设计在需要更长字符串的场景下捉襟见肘。
现代折中:胖指针(Fat Pointer)
Go 的 string 和 Rust 的 &str 采用第三种方案——胖指针:
// Go/Rust 的字符串在底层等效于:
struct string_ref {
 const char* ptr; // 指向字符数据的指针
 size_t len; // 字节长度(不含 \0)
};
每次传递字符串引用时,栈上多传一个 size_t(8 字节)。代价是函数调用的参数/返回值多占用一个寄存器或栈槽。收益是取长度 O(1),且不需要 sentinel 字符。这个方案在现代 64 位地址空间下是明确的最优解——额外的 8 字节相较于指针本就占的 8 字节,边际成本很低。
字符串的存储方式
存储归纳为三类。按”内存从哪来、长度放哪、怎么链接”三个维度重新分类:
// ① 定长顺序存储 —— 静态分配,超长截断
#define MAXLEN 255
typedef struct {
    char ch[MAXLEN + 1];     // 下标 0 存放串长(或弃用,ch[1..len] 存字符)
    int length;
} SString;

// ② 堆分配存储 —— 运行时 malloc,长度可变
typedef struct {
    char* ch;                // 按实际串长分配
    int length;
} HString;

// ③ 块链存储 —— 链表节点,每个节点装一个"字符块"
#define CHUNKSIZE 4          // 每节点存 4 个字符
typedef struct Chunk {
    char ch[CHUNKSIZE];
    struct Chunk* next;
} Chunk; // 另设头结点记录串长与首尾指针| 定长顺序 | 堆分配 | 块链 | |
|---|---|---|---|
| 内存来源 | 编译期静态区/栈 | 堆(malloc/free) | 堆(节点逐个申请) |
| 最大长度 | MAXLEN 固定上限 | 仅受内存限制 | 仅受内存限制 |
| 取长度 | (length 字段) | (头结点记录) | |
| 访问第 i 个字符 | 直取 | 直取 | 顺链走 |
| 插入/删除 | 搬移后续元素,可能截断 | realloc 或搬移 | 改指针,块内整理 |
| 空间利用率 | 高,但有预留浪费 | 高(按需分配) | 受存储密度制约 |
块链的关键知识点是存储密度:
64 位系统指针占 8B:CHUNKSIZE=4 时密度仅 ;把块加大到 64,密度升至 。块越小插删越灵活但密度越低;块越大越接近顺序存储——这是链式结构”粒度换密度”的一般规律。
基本操作与真实成本
在进入算法之前,先把字符串 ADT 的基础操作过一遍。每个操作的成本直接由上一节的表示方式决定:
| 操作 | C 接口 | 语义 | 成本 | 备注 |
|---|---|---|---|---|
| 取长度 | strlen(s) | 扫描到 \0 | length-prefixed 表示下是 | |
| 取下标 | s[i] | 寻址公式直取 | 完整继承数组的随机访问能力 | |
| 比较 | strcmp(a,b) | 逐字符比到首个差异或 \0 | 返回差值而非布尔值,见下 | |
| 拼接 | strcat(dst,src) | 先扫 dst 尾再拷贝 src | 每次 O(n) 是拼接陷阱的根源 | |
| 拷贝 | strcpy(dst,src) | 逐字符复制直到 \0 | 无边界检查版即缓冲区溢出之源 | |
| 子串定位 | strstr(h,n) | 见下一节匹配算法 | 起 | BF→KMP/BM 的优化对象 |
两个值得展开的点:
为什么 strcmp 返回 int 差值而不是 bool? 因为排序和三路分支都需要”小于/等于/大于”三种信息——qsort 的比较函数约定、C++ 的 operator<=>、Java 的 compareTo、Rust 的 Ord 全部沿用这个设计。一个返回值承载三种语义,调用方按符号分派即可。
拼接的二次方陷阱在所有表示上都存在,只是形式不同:
// 反例:strcat 每次都要从头扫描 dst 找尾部 —— 总计 O(n^2)
char buf[10240] = "";
for (int i = 0; i < 1000; i++)
    strcat(buf, "chunk");        // 第 i 轮扫描约 5*i 个字符

// 正解:自己维护写指针,追加 O(1) —— 这就是 StringBuilder 的手工版
size_t len = 0;
for (int i = 0; i < 1000; i++) {
    memcpy(buf + len, "chunk", 5);
    len += 5;                    // 写指针直接跳到尾部,不再扫描
}
Python/Java 的不可变字符串让这个问题更严重(每次拼接连旧串内容一起复制,详见下一节),所以标准库提供 StringBuilder、io.StringIO、''.join(list) 作为”写指针”的高层等价物。本质都一样:把 n 次 O(n) 的追加摊还成 n 次 O(1)。
不可变性
Java 和 Python 的字符串是不可变的(immutable),C 和 C++ 的字符串是可变的。这不是语法细节——它是数据结构设计的核心决策:
不可变(Java String, Python str) | 可变(C char[], C++ std::string) | |
|---|---|---|
| 修改开销 | 每次修改产生新副本, 拷贝 | 原地修改, 或 均在原缓冲区 |
| 哈希缓存 | 安全——不变,可哈希一次并永久缓存 hashcode | 危险——修改后哈希值改变,缓存即失效 |
| 线程安全 | 自然安全——不可变对象天然线程安全 | 需要手动同步 |
| 子串操作 | Java 7 前:substring 共享底层 char[],O(1) 但潜在内存泄漏 | C++:substr 总是拷贝,O(n) |
不可变字符串的一个经典陷阱:在 Java 中拼接大量字符串时,str = str + "x" 每次循环都分配新 String 并复制旧内容,导致 的时间复杂度。StringBuilder 用可变缓冲区解决此问题——这揭示了”不可变”在函数式语义下的美好承诺与工程实践之间的矛盾。
字符串匹配
给定文本串 (长度 )和模式串 (长度 ),找到 在 中的所有出现位置。这是计算机科学中研究最深的问题之一——从文本编辑器到网络入侵检测,从 DNA 序列比对到搜索引擎,字符串匹配无处不在。
BF 算法(Brute-Force)
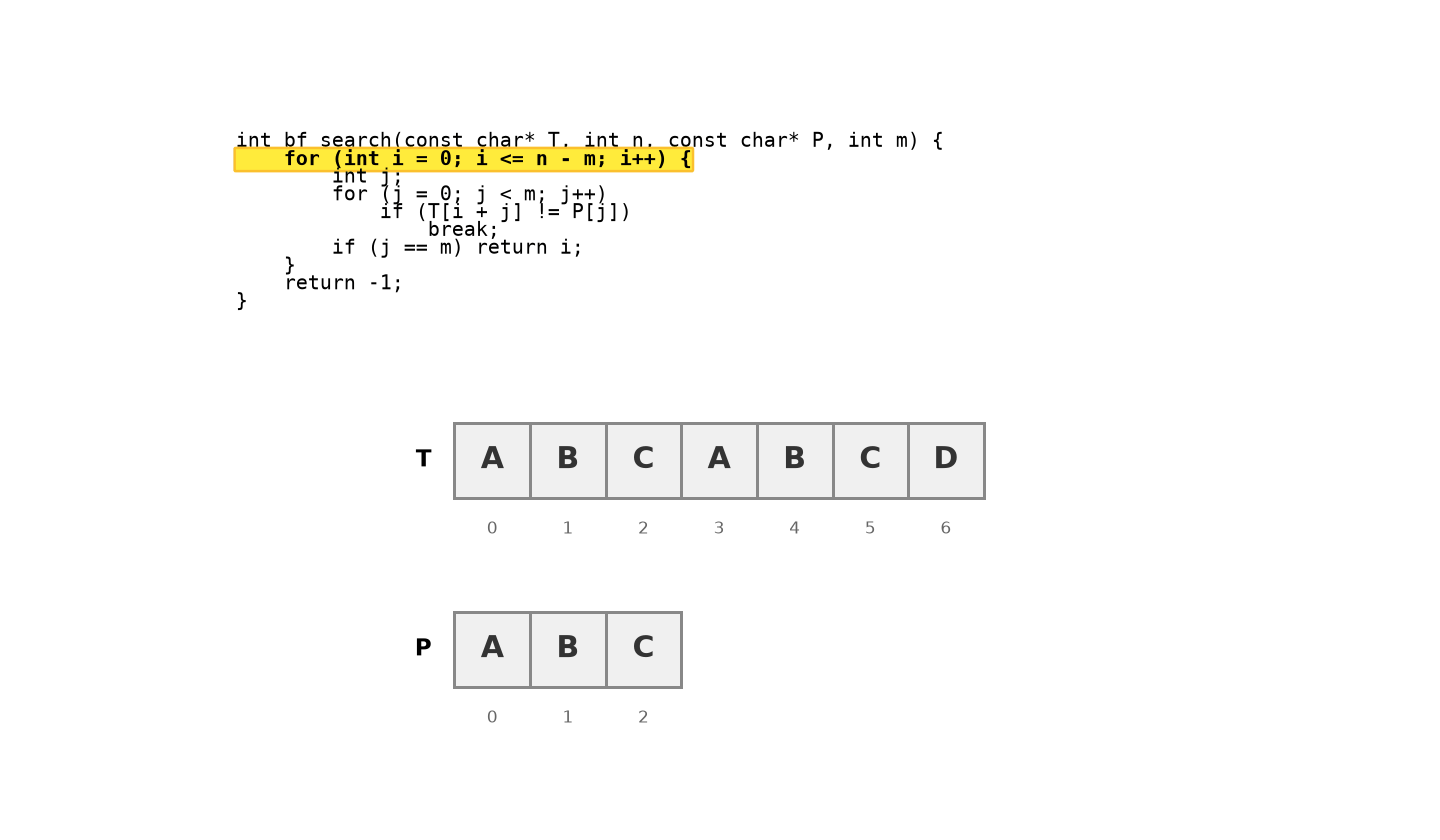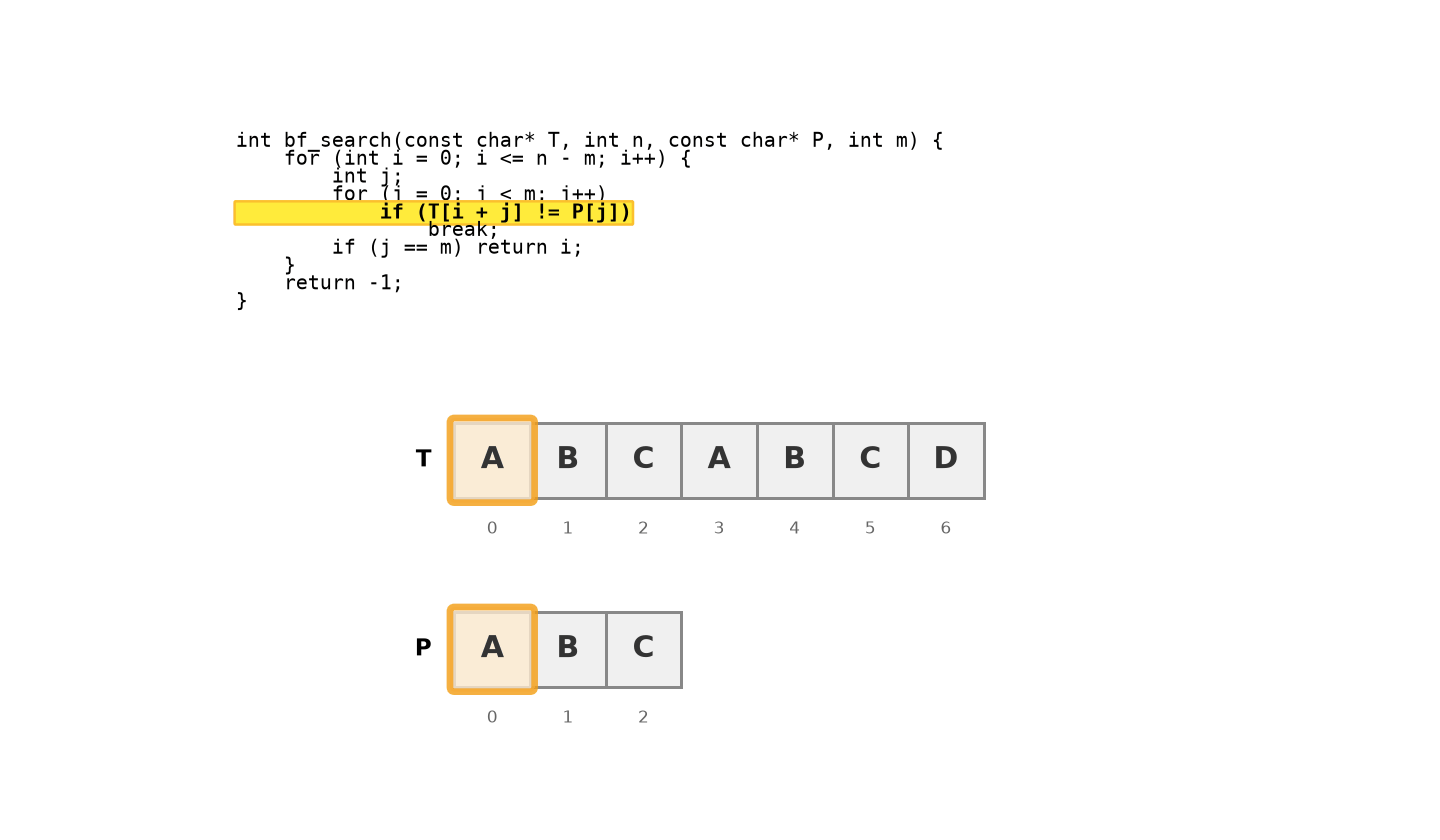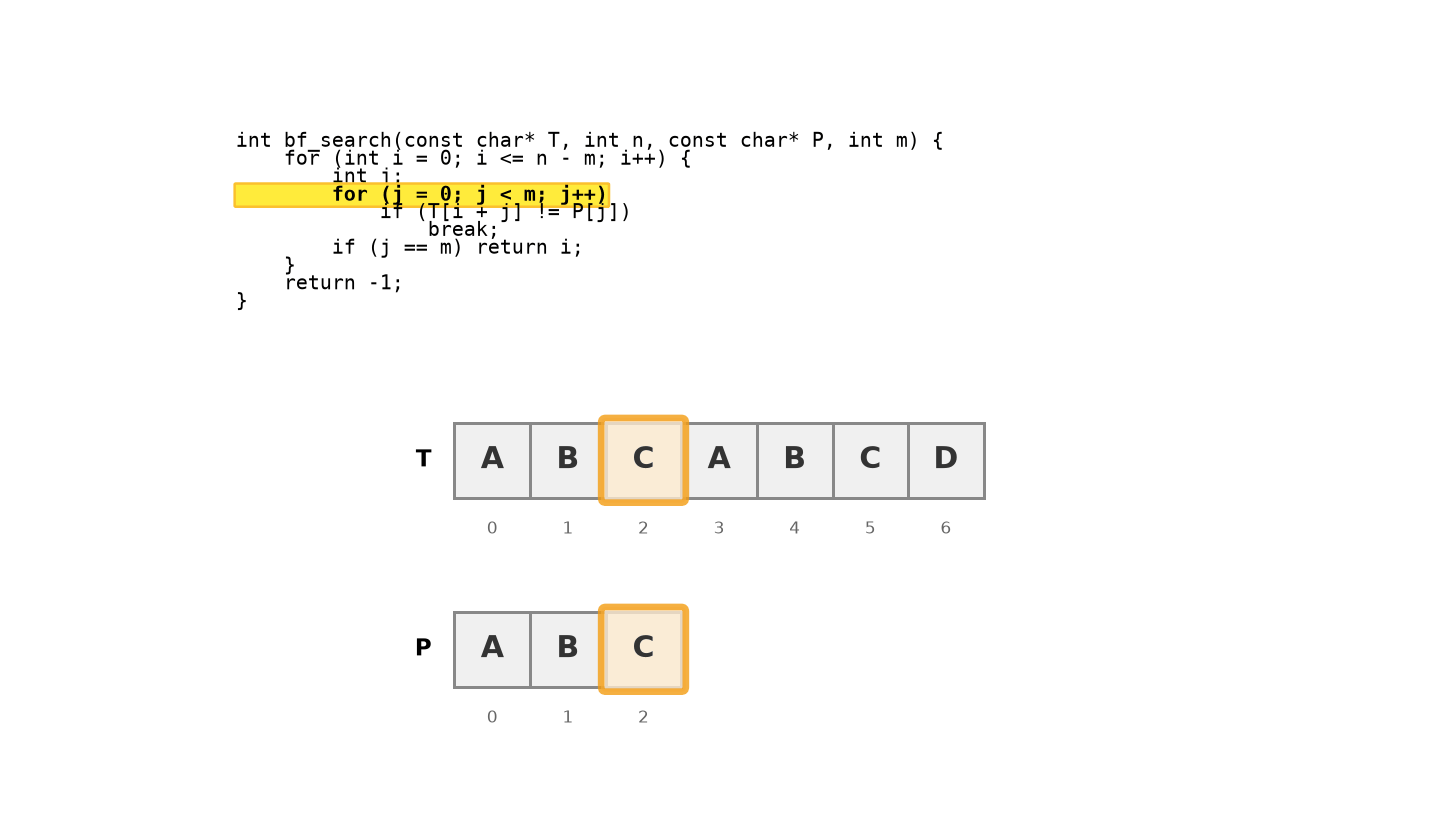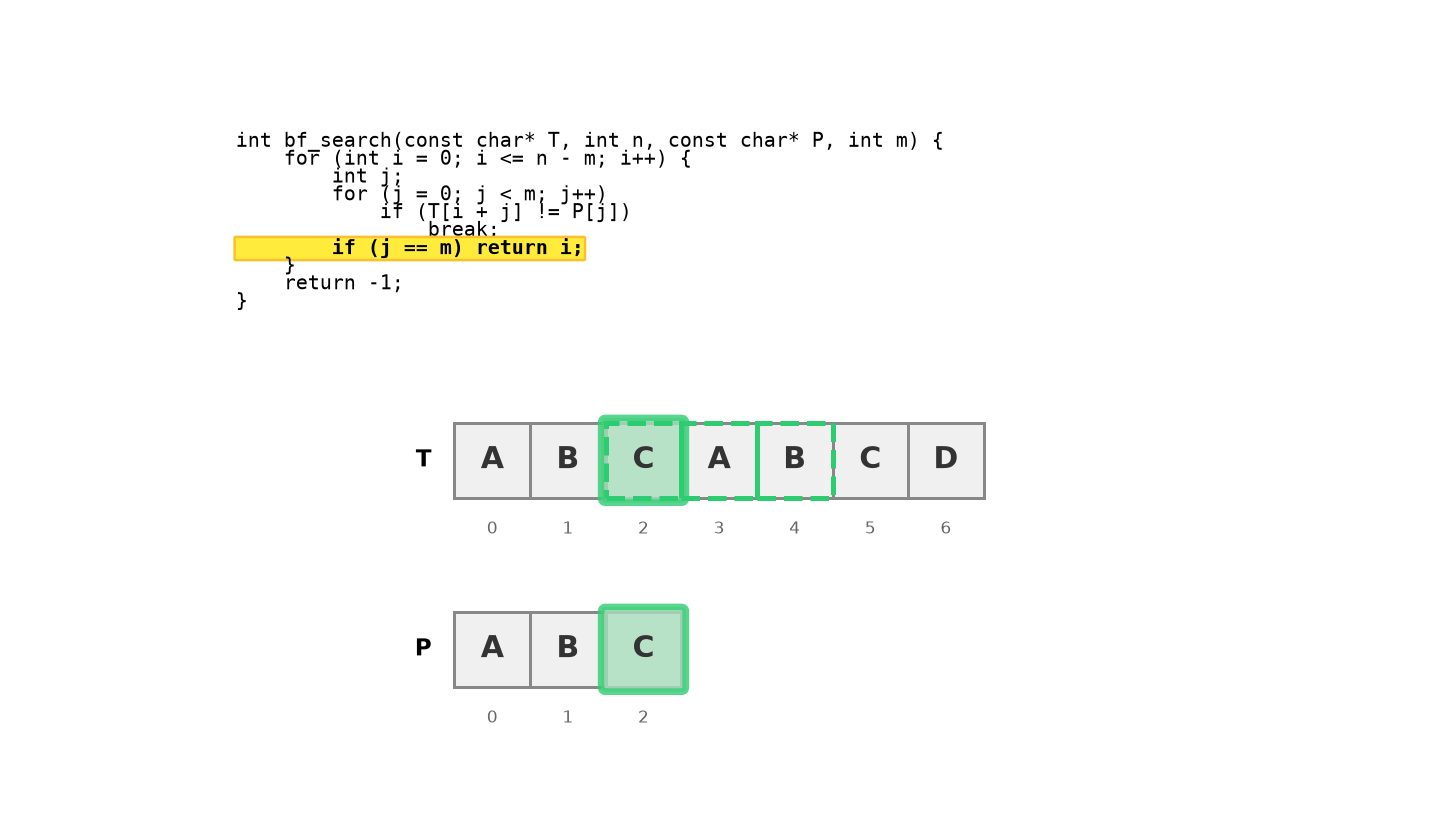
最直觉的思路:从 的每个位置 出发,逐个字符与 比较:
| 步 | i | 对齐位置 | T 片段 | P 片段 | 比较结果 |
|---|---|---|---|---|---|
| 1 | 0 | T[0..4] vs P | ababc | abcab | T[2]=‘a’ ≠ P[2]=‘c’,失败 |
| 2 | 1 | T[1] vs P[0] | b... | a... | T[1]=‘b’ ≠ P[0]=‘a’,失败 |
| 3 | 2 | T[2..6] vs P | abcab | abcab | 全部匹配,成功! |
// BF: O(n*m) 最坏情况
int bf_search(const char* T, int n, const char* P, int m) {
 for (int i = 0; i <= n - m; i++) {
 int j;
 for (j = 0; j < m; j++)
 if (T[i + j] != P[j])
 break;
 if (j == m) return i; // 匹配成功
 }
 return -1;
}
最坏情况 :当 = "aaaaaaaaaa", = "aaaab" 时,每次匹配到 的最后一个字符才失败, 回溯后重复扫描已比对过的字符。BF 的瓶颈在于——失配时丢弃了已匹配部分的所有信息,将 回退至 重新开始。
手算示范:以 = "ababcabcab"、 = "abcab" 为例(下标从 0 开始),BF 的完整比较轨迹:
| 起点 i | 比较过程 | 结果 |
|---|---|---|
| 0 | T[0]=‘a’=P[0],T[1]=‘b’=P[1],T[2]=‘a’≠P[2]=‘c’ | 失败,共比较 3 次 |
| 1 | T[1]=‘b’≠P[0]=‘a’ | 失败,共比较 1 次 |
| 2 | T[2..6]=“abcab” 与 P 逐字符相等 | 匹配成功,返回 2,共比较 5 次 |
只回退到 , 归零从头再比——第 0 步已经比对出的信息(T[0..1]=“ab”)被完全丢弃。KMP 的全部价值就在于回收这份信息:失配在 P[2] 时其实无需移动 i,直接让模式串”滑”到正确位置继续。
BF 轨迹书写
| 起点 i | 比较过程 | 结果 |
|---|---|---|
| 0 | T[0]=‘a’≠P[0]=‘b’ | 失败,1 次 |
| 1 | T[1]=‘a’≠P[0]=‘b’ | 失败,1 次 |
| 2 | T[2]=‘b’=P[0],T[3]=‘a’=P[1],T[4]=‘b’≠P[2]=‘a’ | 失败,3 次 |
| 3 | T[3]=‘a’≠P[0]=‘b’ | 失败,1 次 |
| 4 | T[4..7]=“baab” 全部相等 | 成功,返回 4,共 4 次 |
总计 次比较。注意:每次失败后是否记得 j 归零、i 只前进一位;第 i=2 步那种”匹配了前缀又断掉”的情形是失分重灾区——比较次数要按实际比对过的字符数写。
KMP 算法(Knuth-Morris-Pratt)
KMP 的核心洞察:失配时,已匹配的子串告诉我们模式串可以从哪里继续,文本指针不需要回退。
Border与B(S)函数
假如有字符串S
B(S)表示S最长的Border。
例如,S=“abaca”
真前缀有”a” “ab” “aba” “abac” 就是从左往右数的”真子集”不算空子集
真后缀有”a” “ac” “aca” “acab” 反过来从右往左数
这里相等的只有”a” ,也就是说Border=“a”
“a”长度为一个字符,也就是说Border长度为1
前缀函数是KMP算法的核心,其基本思路简述是先预处理得到样本,在正式匹配的时候如果不满足条件不用回退到零重头开始,而是在样本里继续。
前缀函数 的数学定义:
对于模式串 (长度 ),前缀函数 定义为:
推导:P=P[0] P[1] … P[m-1]
pi[i]=B(P[0…i])
形式化也就是pi[i] = max{ k | 0 <= k <= i,P[0..k-1] == P[i-k+1..i] }是上方定义公式的变体,其中k=0表示空串,空串总是相等,所以pi[0]=0
例如:
P = “abab”
i=0: P[0..0] = “a”,pi[0]=0
i=1: P[0..1] = “ab”,pi[1]=0
i=2: P[0..2] = “aba”,最长 border 是 “a”,pi[2]=1
i=3: P[0..3] = “abab”,最长 border 是 “ab”,pi[3]=2
所以 pi = [0, 0, 1, 2]
也可以叫做前缀函数,对模式串P的每一个前缀P[0…i]求他的最长相等真前缀和真后缀的长度,叫做pi[i],
在代码示例里,我们会使用pi来代替数学文本书写的pi符号。
即 这个子串中,最长相等的真前缀和真后缀的长度()。
示例:
| 相等的前缀/后缀 | |||
|---|---|---|---|
| 0 | "a" | 无(真前缀/真后缀必须比原串短) | 0 |
| 1 | "ab" | "a" ≠ "b" | 0 |
| 2 | "abc" | "a" ≠ "c", "ab" ≠ "bc" | 0 |
| 3 | "abca" | "a" = "a" | 1 |
| 4 | "abcab" | "ab" = "ab" | 2 |
数组的递归计算:
已知 (即 的最长 border 长度),求 :
其中的递归回溯——j = pi[j-1]——之所以仍保持线性复杂度,是因为每次 j 回退都会严格缩短,而在整个循环中 j 只能被回退”已被增加过的”次数。总的说,j 最多被增加 m 次,最多被回退 m 次,总复杂度 。这个分析与 vector 扩容的均摊分析在数学上等同——“总操作数除以操作次数”不超过常数的思想。
其可以用于失配时候,更准确的说是迭代跳转,跳转链如下:
->->
->
->
示例:
j = pi[i-1]
while j > 0 且 P[i] != P[j]
j = pi[j-1]
如果 P[i] == P[j]:
j = j + 1
pi[i] = j
当 j = 0 时,仍然可以比较 P[i] 和 P[0]。如果相等,则 pi[i] = 1,否则 pi[i] = 0
C语言演示:
按照道理来说,可以直接进行暴力循环:
for (int i = 0; i < n; i++) {
    pi[i] = 0;
    for (int k = i; k >= 1; k--) {
        // 检查 P[0..k-1] 是否等于 P[i-k+1..i]
        if (P[0..k-1] == P[i-k+1..i]) {
            pi[i] = k;
            break;
        }
    }
}

也即是上面的第i次所选取的子字符串进行前后对照,从第一位开始不断累加,最终返回最大值。
但是这个做法太慢了
border链
假设我们已经计算好了pi[0]到pi[n-1],然后来求pi[n]
我们假设p[0..n-1]的最长子链长度为j,也就是pi[n-1]=j
也就是说明存在P[0…j-1]=P[i-1…i-j] 意思是在模式串P中从前往后的前j个字符组成的子链与从后往前数的前j个字符组成的子链是完全一样的
想要求P[0…n]的Border值,假如其Border值长度为k,且k>0,那么pi[n-1]=k-1 k>0说明P[0..n]的第j+1位依然成立前后子链完全一样,所以当pi[n-1]=k-1的时候,pi[n]必定衔接+1也就是k
假设k值是最大理想情况,那么满足k-1<=pi[n] 而pi[n]=j是已知条件,也就是k-1<=j,因此k<=j+1
所以最长Border只能从j+1开始尝试,也就是比较P[i]和P[j]是否相等
我们知道要求的新Border长度大小最大只可能为j+1,那肯定是从j+1开始不断缩小进行遍历比较,因为前面已经比较过了,所以只需要比较新的字符了,而下一步索引是i和j,所以只需要比较P[i]和P[j]就可以了
如果相等,那么j+1就是pi[n],如果不是,那么说明不能直接扩展border,需要找次级border长度
而所以次级长度分别是,j,pi[j-1],pi[j-2],…0
这个就叫border链
利用border链可以设计递推公式,当不满足P[i]== P[j]的时候,设定j=pi[j-1]直到满足条件或者j=0 才终止,以此求出目标j值
写成优化后的前缀函数代码就是如下:
void build_pi(const char *P, int *pi, int n) {
    if (n <= 0) return;

    pi[0] = 0;

    for (int i = 1; i < n; i++) {
        int j = pi[i - 1];          // 当前最长 border 长度

        while (j > 0 && P[i] != P[j]) {
            j = pi[j - 1];          // 回退到次长 border
        }

        if (P[i] == P[j]) {
            j++;                    // 能接上,border 长度加一
        }

        pi[i] = j;                  // 记录结果
    }
}
1-indexed 的 next 数组
模式串下标从 1 开始,数组名叫 next:
其中 是子串 的最长相等真前后缀长度。它与本章 数组只差一条平移公式:
含义: 失配时, 直接跳到 继续比较; 特殊地表示”模式串整体右移一位、 从头开始”。教材原貌的匹配循环:
// 1-indexed 版本:T、P 的下标都从 1 开始
int kmp_index(SString* T, SString* P, int next[]) {
    int i = 1, j = 1;
    while (i <= T->length && j <= P->length) {
        if (j == 0 || T->ch[i] == P->ch[j]) { i++; j++; }
        else j = next[j];               // 失配:j 跳到 next[j],i 不动
    }
    return j > P->length ? i - P->length : 0;   // 返回匹配起点(1-indexed)
}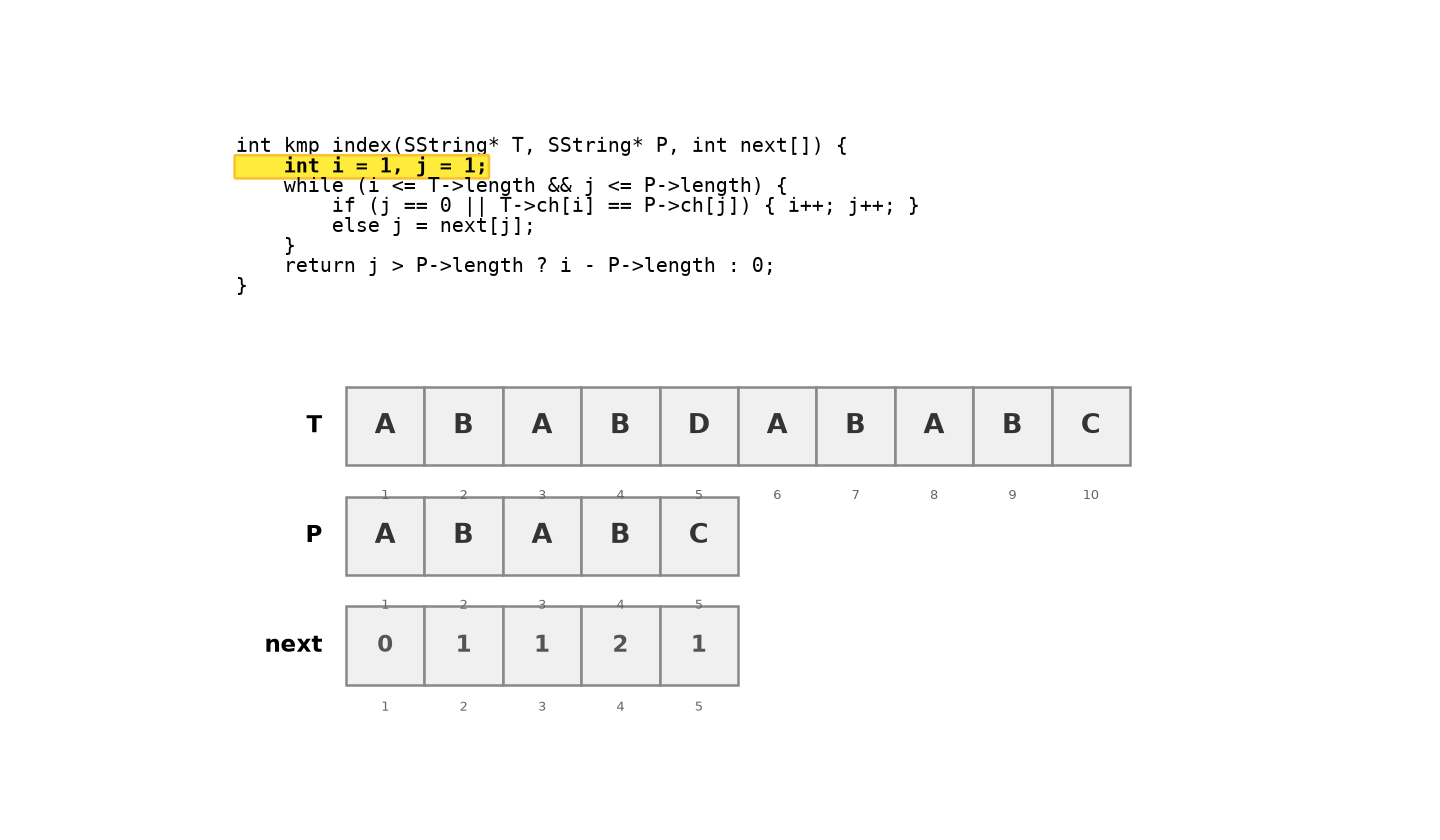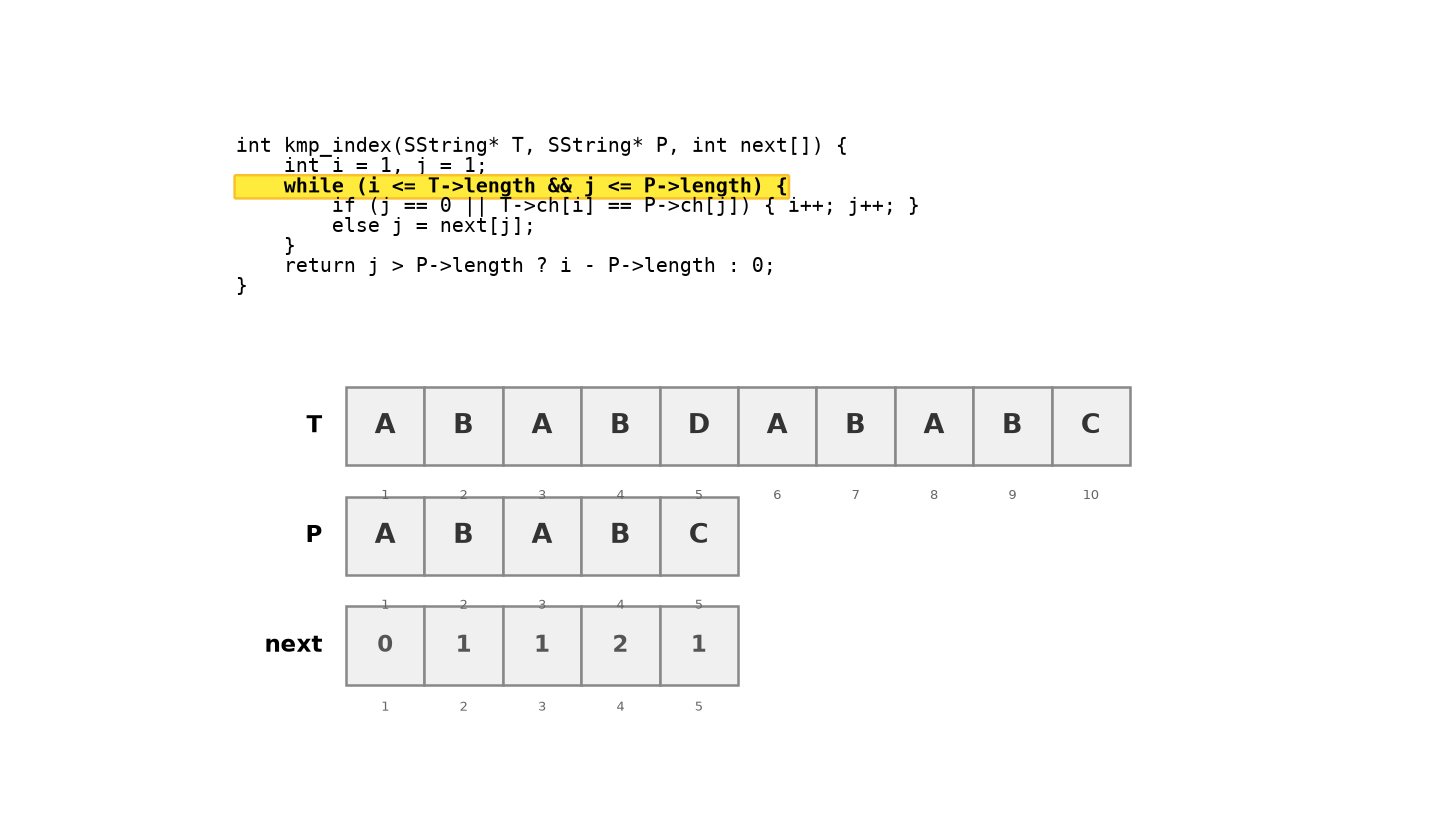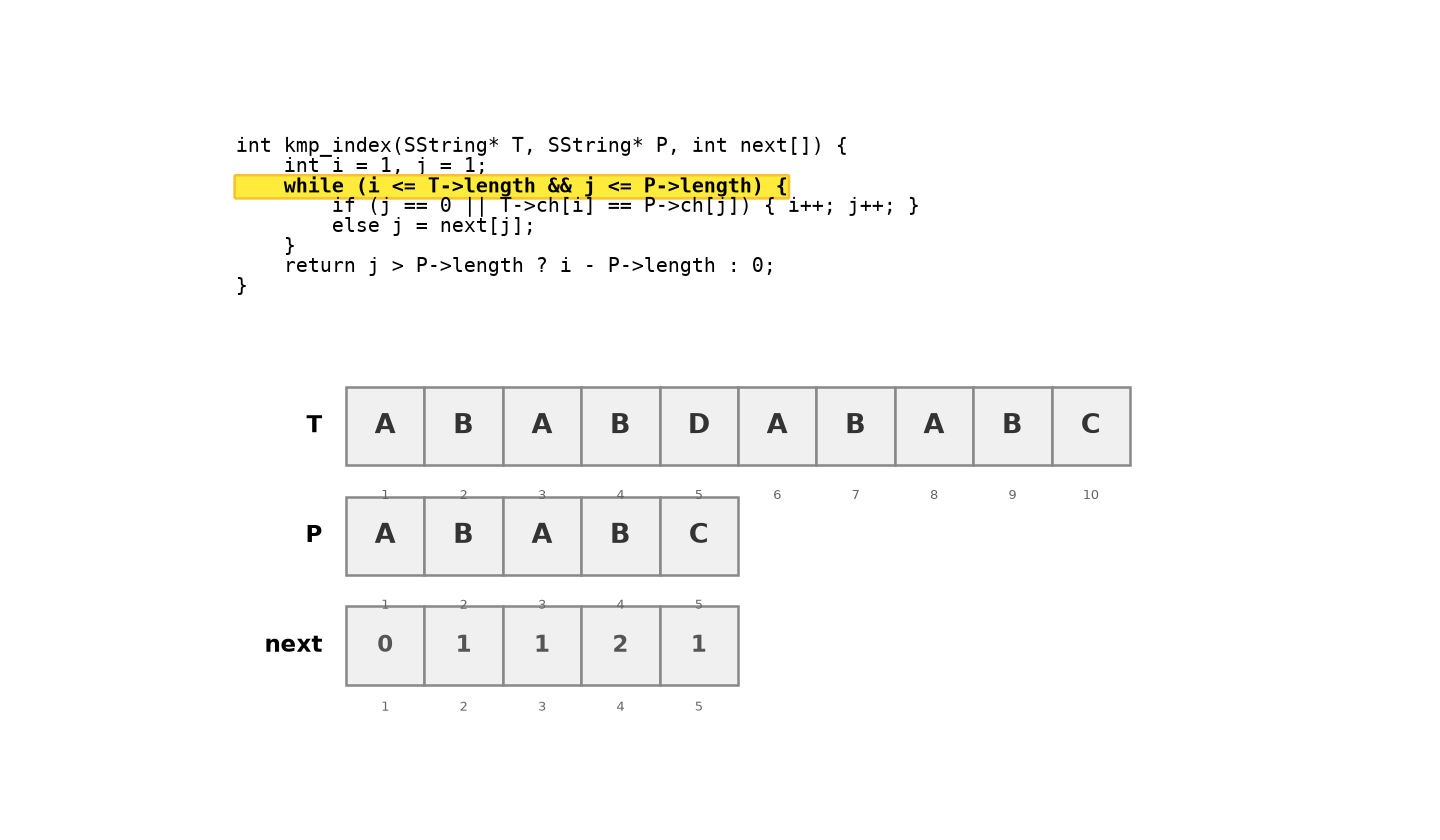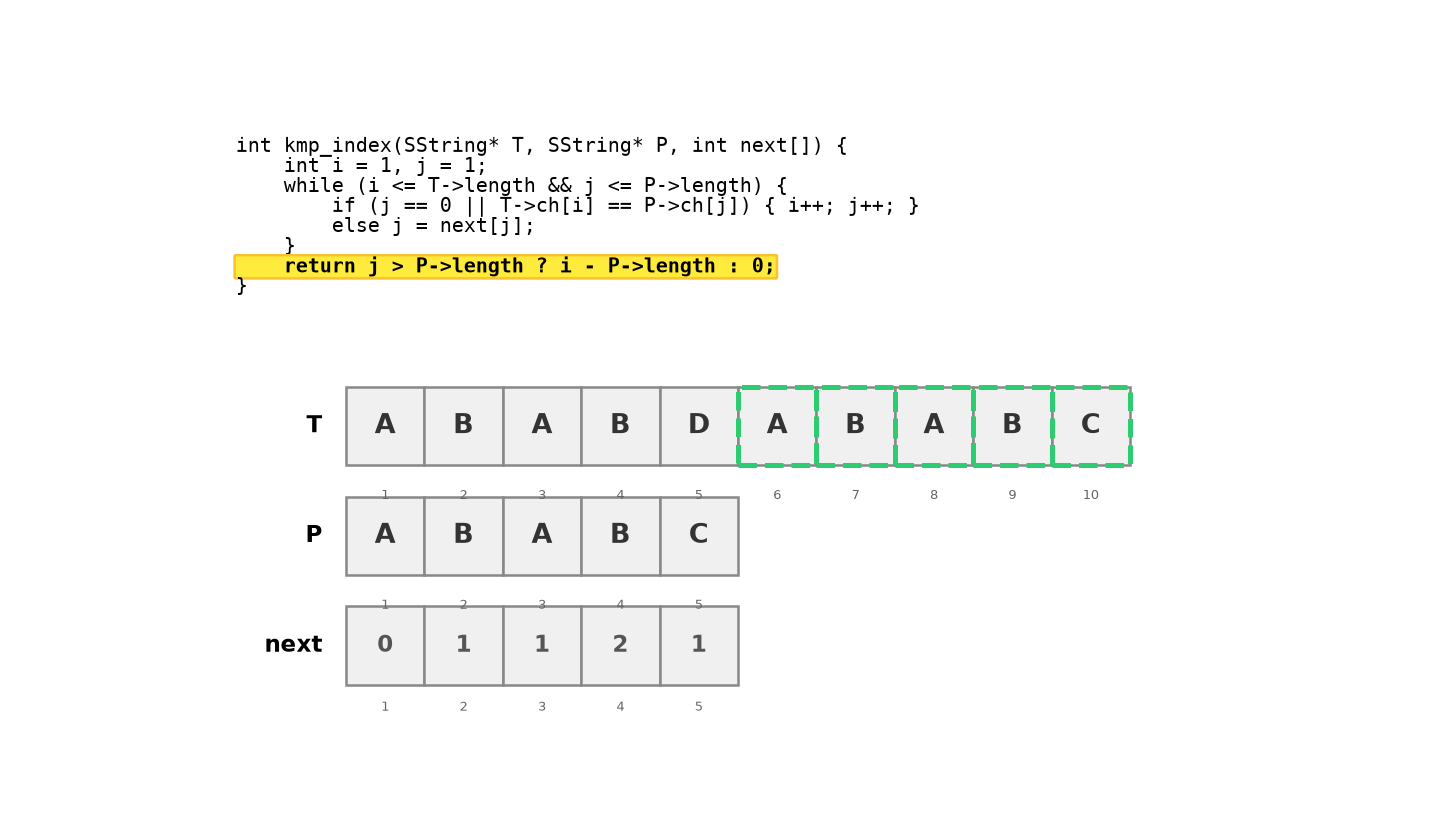
next 手算示范:求 = "abcab" 的 next 数组——
| j | 看 P[1..j-1] | 最长相等真前后缀 | Border 长度 | next[j] |
|---|---|---|---|---|
| 1 | (约定) | — | — | 0 |
| 2 | "a" | 无 | 0 | 1 |
| 3 | "ab" | 无 | 0 | 1 |
| 4 | "abc" | 无 | 0 | 1 |
| 5 | "abca" | "a" = "a" | 1 | 2 |
即 next = [0, 1, 1, 1, 2]。用平移公式验证: = [0,0,0,1,2] → next[5] = π[3]+1 = 1+1 = 2,与表格一致。
再练一个周期性强的: = "aaaab" → next = [0, 1, 2, 3, 4],每个位置的 Border 都取到最大。操作要领:盯住 P[1..j-1] 这一段,看首尾最多能重叠多长,加 1 即答案。
next 数组求解
① = "abab" ② = "aaab" ③ = "aaaa"
答案:
| j | ① "abab" | ② "aaab" | ③ "aaaa" |
|---|---|---|---|
| 1 | 0 | 0 | 0 |
| 2 | 1 | 1 | 1 |
| 3 | 1 | 2 | 2 |
| 4 | 2 | 3 | 3 |
第 ③ 题是经典陷阱:next[4] 看的是 P[1..3] = “aaa”,其最长相等真前后缀是 “aa”(长 2),所以 next[4] = 3——而不是 4。Border 必须是”真”前后缀,因此恒有 ;若你算出某格等于 j 本身,说明把整个串当成了自己的 Border,必错。
KMP 匹配过程的 DFA 视角:
可以将模式串 视为构造了一台确定有限自动机(DFA):
graph LR
 S((0)) -->|a| S1((1))
 S -->|非 a| S
 S1((1)) -->|b| S2((2))
 S1 -->|a| S1
 S1 -->|非 a,b| S
 S2((2)) -->|c| S3((3))
 S2 -->|a| S1
 S2 -->|非 a,c| S
 S3((3)) -->|a| S4((4))
 S3 -->|非 a| S
 S4((4)) -->|b| S5(((5)))
 S4 -->|c| S3
 S4 -->|非 a,b,c| S0["回溯到 π[3-1]=π[2]=0"]
状态 表示”已匹配了 的前 个字符”。读入一个字符 后,若 ,转移到 (匹配前进);否则通过 数组跳转到”次长可能的匹配位置”——这个跳转正好就是 然后重新比较。
为什么 KMP 是 :
文本指针 在整个过程中只增不减(从不回退)。模式指针 每次增加至多 1(当 ),每次回退至少减少 1()。由于 , 不会被回退到负数,也不会无限回退。在整个算法运行过程中, 的总增加量不超过 ,因此总回退量也不超过 。加上构建 的 类似分析,总复杂度 。
完整匹配过程
用上面求出的 next = [0, 1, 1, 1, 2],在 = "ababcabcab" 中找 = "abcab"(下标从 1 开始):
| 步骤 | 比较 | 结果 | 动作 |
|---|---|---|---|
| 1 | T[1]=‘a’ = P[1] | 匹配 | i=2, j=2 |
| 2 | T[2]=‘b’ = P[2] | 匹配 | i=3, j=3 |
| 3 | T[3]=‘a’ ≠ P[3]=‘c’ | 失配 | j = next[3] = 1(i 不动) |
| 4 | T[3]=‘a’ = P[1] | 匹配 | i=4, j=2 |
| 5 | T[4]=‘b’ = P[2] | 匹配 | i=5, j=3 |
| 6 | T[5]=‘c’ = P[3] | 匹配 | i=6, j=4 |
| 7 | T[6]=‘a’ = P[4] | 匹配 | i=7, j=5 |
| 8 | T[7]=‘b’ = P[5] | 匹配 | i=8, j=6 > m,匹配成功 |
| 9 | 返回起点 i − m = 8 − 5 = 3(即 0 起算的位置 2) | 结束 |
对照 BF 节的轨迹:同样的文本与模式,BF 第 0 步失配后 i 从 1 从头来;KMP 借助 next 把 j 回跳到 1、i 纹丝未动——省掉的正是那些注定失败的重复比较。
KMP 轨迹书写
① = "aababa"、 = "aba";② = "abbababbab"、 = "abab"
答案:
① next = [0, 1, 2]。
| 步骤 | 比较 | 结果 | 动作 |
|---|---|---|---|
| 1 | T[1]=‘a’ = P[1] | 匹配 | i=2, j=2 |
| 2 | T[2]=‘a’ ≠ P[2]=‘b’ | 失配 | j = next[2] = 1(i 不动) |
| 3 | T[2]=‘a’ = P[1] | 匹配 | i=3, j=2 |
| 4 | T[3]=‘b’ = P[2] | 匹配 | i=4, j=3 |
| 5 | T[4]=‘a’ = P[3] | 匹配 | i=5, j=4 > m,成功 |
| 6 | 起点 i − m = 5 − 3 = 2(0 起算位置 1) | 结束 |
② next = [0, 1, 1, 2]。
| 步骤 | 比较 | 结果 | 动作 |
|---|---|---|---|
| 1 | T[1]=‘a’ = P[1] | 匹配 | i=2, j=2 |
| 2 | T[2]=‘b’ = P[2] | 匹配 | i=3, j=3 |
| 3 | T[3]=‘b’ ≠ P[3]=‘a’ | 失配 | j = next[3] = 1 |
| 4 | T[3]=‘b’ ≠ P[1]=‘a’ | 失配 | j = next[1] = 0 → i=4, j=1 |
| 5 | T[4]=‘a’ = P[1] | 匹配 | i=5, j=2 |
| 6 | T[5]=‘b’ = P[2] | 匹配 | i=6, j=3 |
| 7 | T[6]=‘a’ = P[3] | 匹配 | i=7, j=4 |
| 8 | T[7]=‘b’ = P[4] | 匹配 | i=8, j=5 > m,成功 |
| 9 | 起点 i − m = 8 − 4 = 4(0 起算位置 3) | 结束 |
② 的第 3-4 步是重点:j 连续两次回跳(3→1→0)时,i 始终停在 3 没有动过——这正是 KMP 与 BF 的分水岭。另外注意 j=0 时不再比较、直接 i++ 前进。
nextval:改进的 next 数组
next 有一个可优化的小缺陷:若 ,跳过去之后拿同一个字符再比一次,必然再次失配。nextval 在构造阶段就把这类”无效跳跃”折叠掉:
以 = "aaaab" 为例(next = [0,1,2,3,4]):P[2..4] 都是 ‘a’,与各自 next 指向的字符相同,一路折叠成 0——失配时直接整体右移重开,不再做无谓比较;P[5]=‘b’ 与 P[next[5]=4]=‘a’ 不同,nextval[5] = next[5] = 4。最终:
| j | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| next | 0 | 1 | 2 | 3 | 4 |
| nextval | 0 | 0 | 0 | 0 | 4 |
手算规则一句话:先照常写出 next;再从左往右扫一遍,凡是”自己 == 自己要跳去的位置上的字符”,就把该位置的 nextval 值抄过来,否则保留原 next 值。
nextval 求解
① = "abaabc" ② = "ababab"——先求 next,再求 nextval。
答案:
| j | ① next | ① nextval | ② next | ② nextval |
|---|---|---|---|---|
| 1 | 0 | 0 | 0 | 0 |
| 2 | 1 | 1 | 1 | 1 |
| 3 | 1 | 0 | 1 | 0 |
| 4 | 2 | 2 | 2 | 1 |
| 5 | 2 | 1 | 3 | 0 |
| 6 | 3 | 3 | 4 | 1 |
② 是周期串的极致案例:P[3..6] 每个字符都等于它要跳去位置上的字符,于是逐格折叠成 [0,1,0,1,0,1]——失配时直接退回起点重开,一次多余的字符比较都不做。折叠要注意方向:必须从左往右算,因为 可能引用前面刚折叠过的结果(如 ① 的 j=5 引用了 nextval[2]=1)。
总结:KMP的基本思路
1,前缀函数先预处理模式串P,得到pi数组。
2,匹配文本T时,用j表示当前已经匹配了模式串的前j个字符
3,当T[i]不等于P[j]时,说明P[0…j-1]已经和文本某段匹配,但下一个字符不匹配,因此不需要把j回退0,而是找P[0…j-1]里的最长真前缀长度k=pi[j-1]
4, 因为P[0…k-1]即是P[0…j-1]的前缀又是它的后缀,所以文本中已经匹配的那段后缀可以看作匹配了P[0…k-1],于是令j=k
5,继续比较T[i]和P[j],文本指针i不回溯
核心是:
失配时:j = pi[j-1]
匹配时:j++
j == m 时:找到一个匹配,然后 j = pi[m-1] 继续找
扩展:其他匹配算法
| 算法 | 预处理 | 匹配 | 空间 | 核心思想 |
|---|---|---|---|---|
| BF | — | 逐个比对,失配回退起点 | ||
| KMP | 前缀函数:失配时跳过不可能起点的位置 | |||
| Boyer-Moore | 平均亚线性 | 从右向左比对,两个启发式规则跳过大量字符 | ||
| Rabin-Karp | 均摊 | 哈希滚动:比较哈希值而非逐字符比对 | ||
| Sunday | 平均亚线性 | BM 的简化版,偏移表决定跳步 |
Boyer-Moore 是实践中最快的单模式匹配算法——它从模式串的尾部向前比对,利用”坏字符规则”(失配时根据失配字符在模式串中最右出现的位置决定跳跃)和”好后缀规则”(已匹配的后缀在模式串中有另一个出现位置,直接跳到该位置)。在大多数实际文本上,BM 只需要检查 个字符中的一小部分,平均时间低于 。
Rabin-Karp 用滚动哈希(rolling hash)将字符串比较转化为哈希值比较:先计算 的哈希,然后滑动窗口计算 中每个长度 的子串哈希(每次滑动 O(1) 更新),只有哈希匹配时才逐字符验证。适用于同时搜索多个模式串的场景——每个模式串存一个哈希值,一次扫描即可。
以下是三种算法的核心匹配逻辑——聚焦算法本身,不含预处理表构建(完整实现见 ## 实现)。
Boyer-Moore 坏字符规则——从右向左比对,失配时根据坏字符在模式串中的最右位置决定跳跃距离:
// BM 坏字符规则核心匹配(不含表构建,仅展示匹配逻辑)
// bad[256] 已预构建:bad[c] = c 在 P 中最右出现的位置,不存在则为 -1
int bm_search_core(const char* T, int n, const char* P, int m, const int* bad) {
    int i = 0;                          // 文本扫描位置
    while (i <= n - m) {
        int j = m - 1;                  // 从模式串尾部向前比对
        while (j >= 0 && T[i + j] == P[j]) j--;
        if (j < 0) return i;            // 全部匹配
        // 坏字符规则:将模式串滑动到 T[i+j] 与 P 中最右同字符对齐
        i += (j - bad[(unsigned char)T[i + j]]);
    }
    return -1;                          // 未找到
}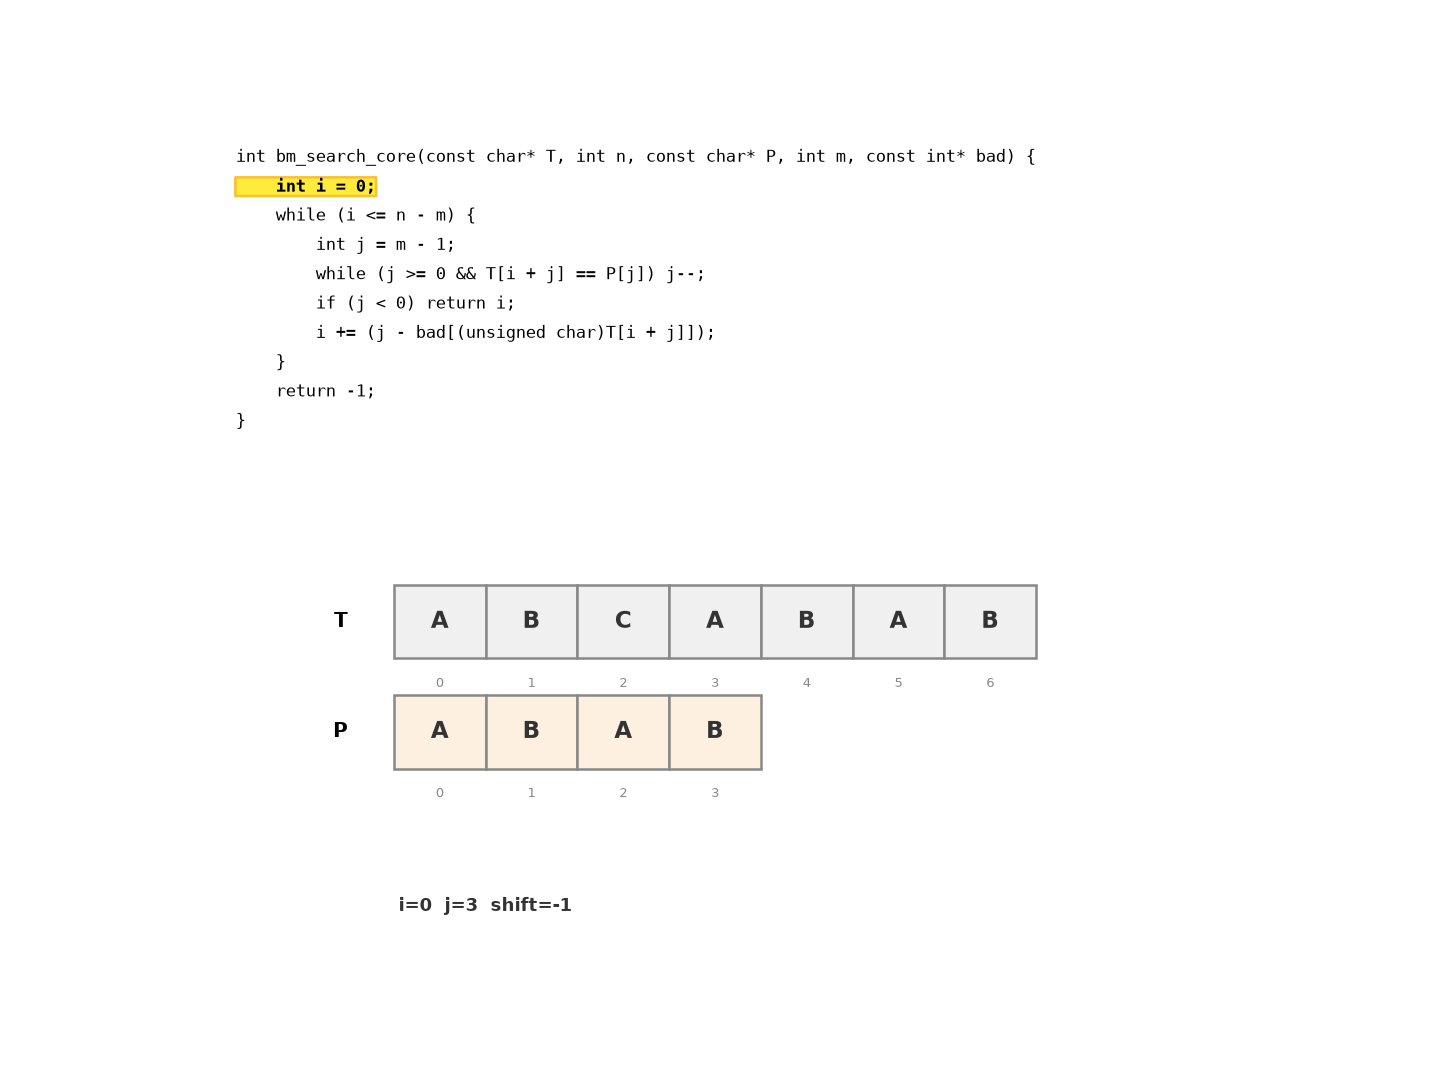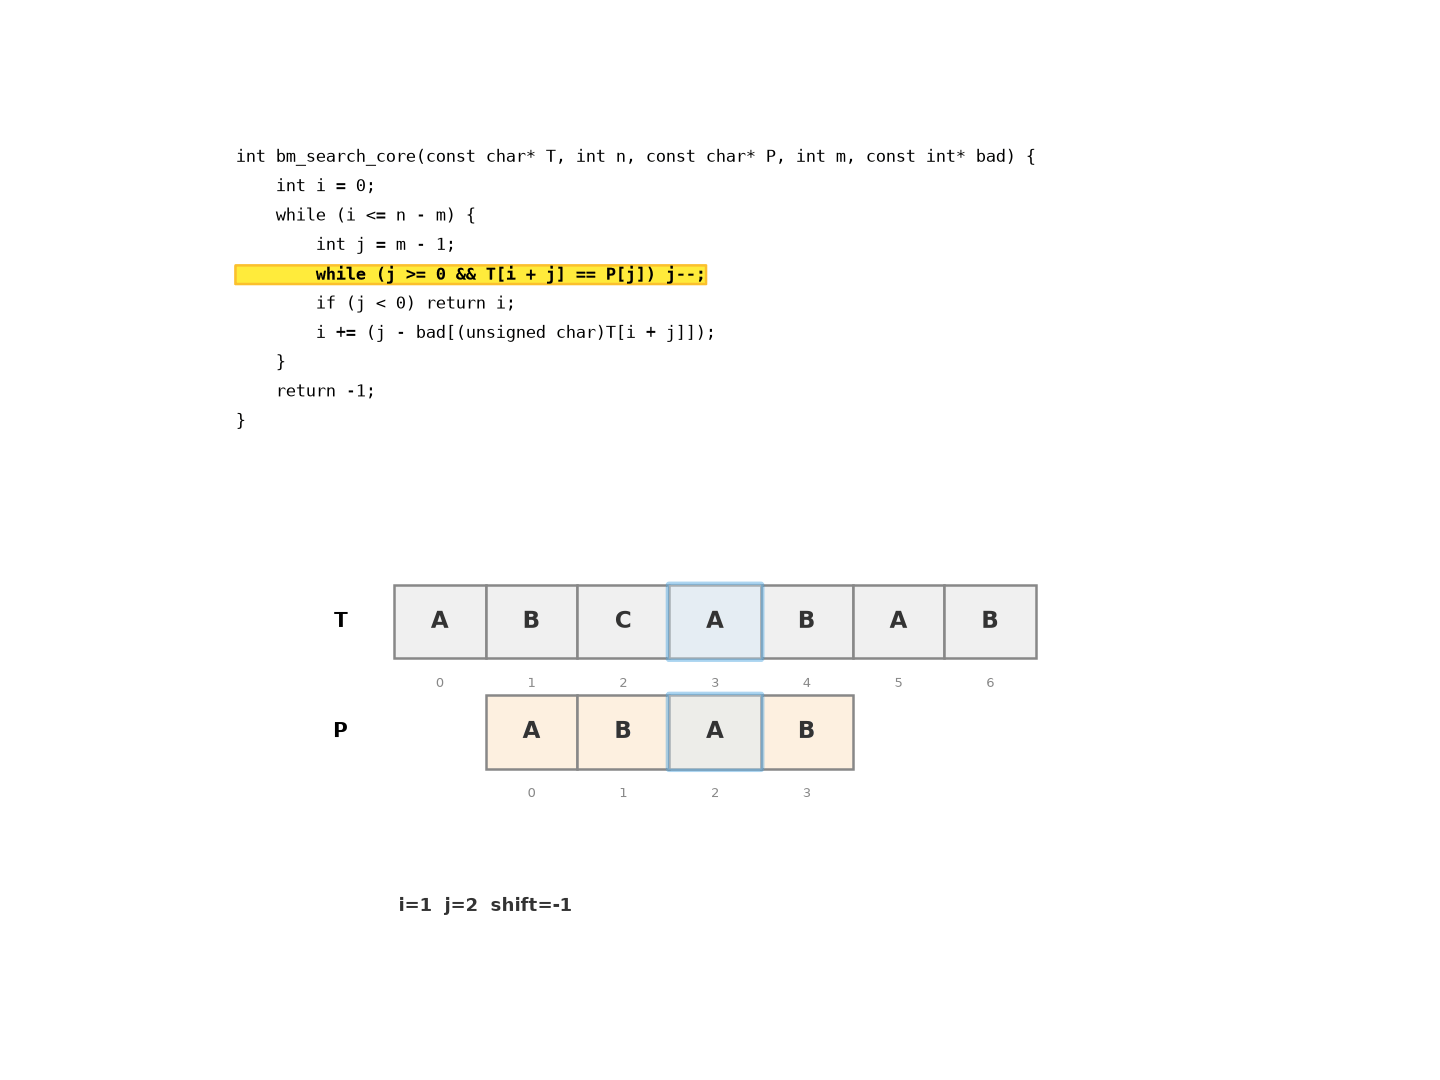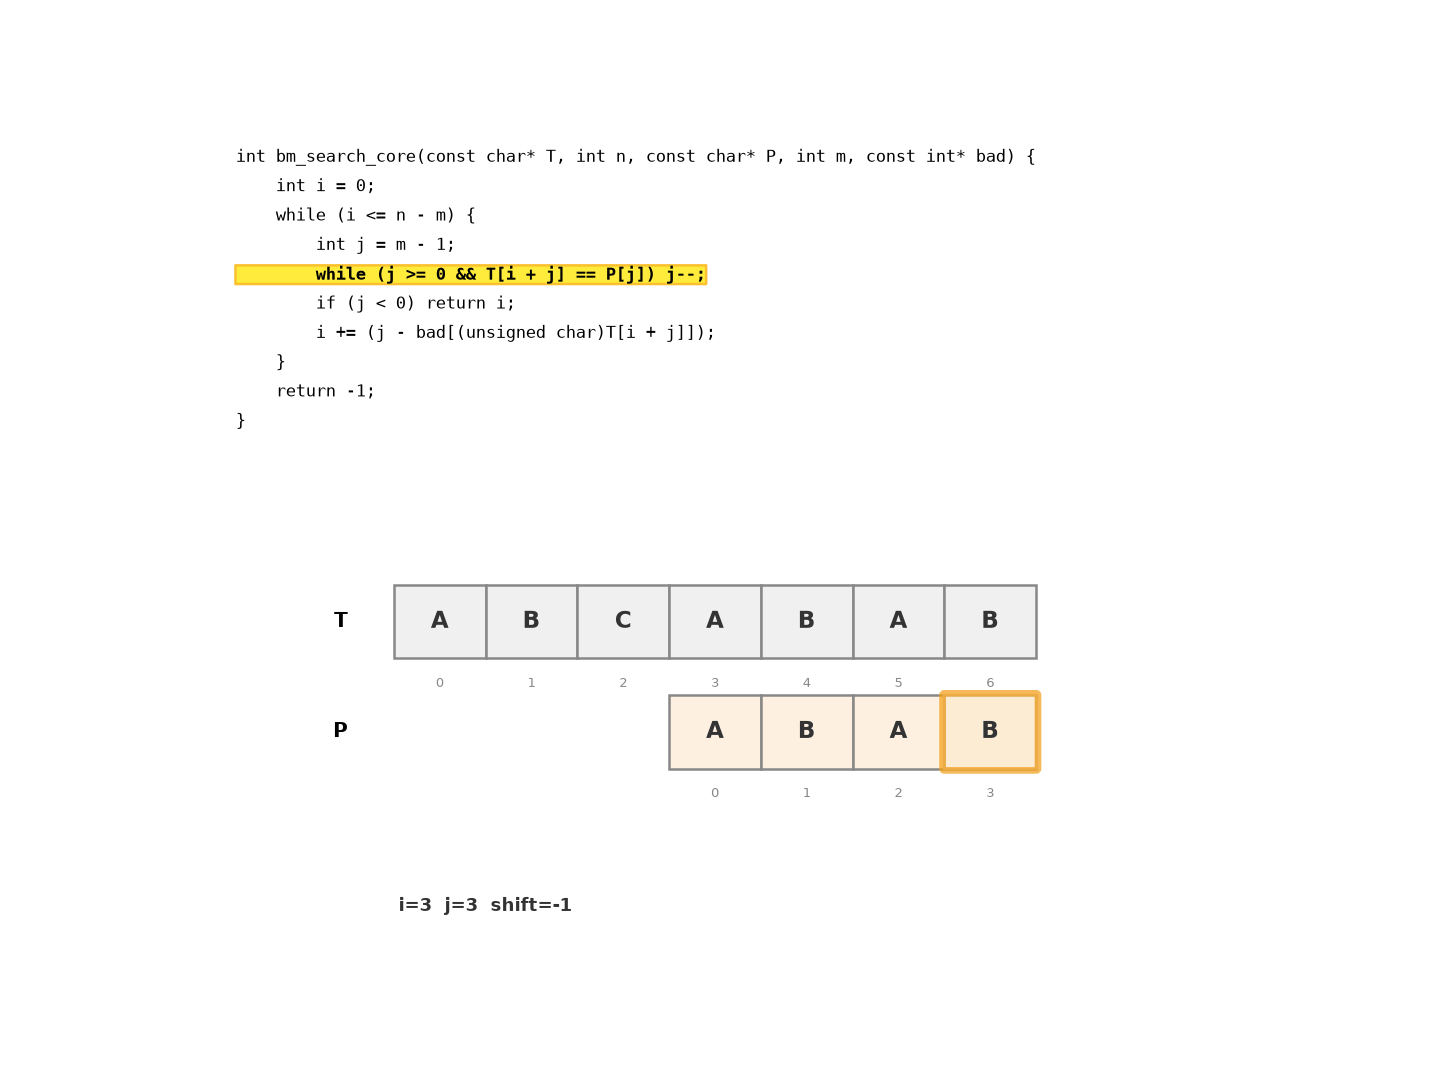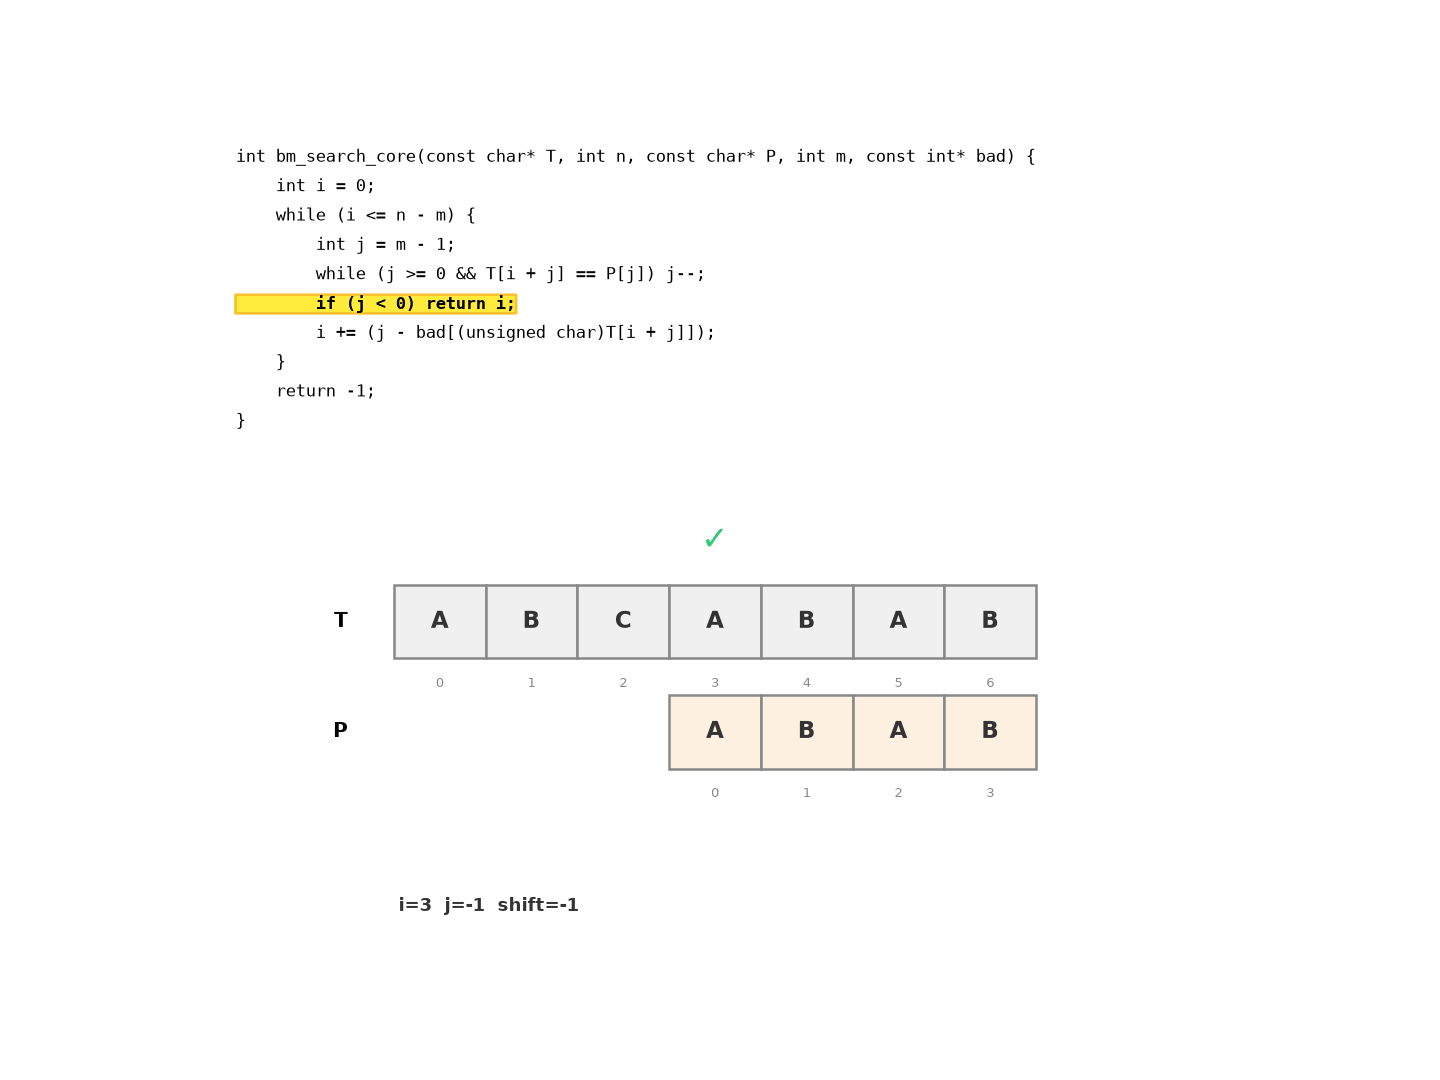
坏字符规则的直觉:失配时,模式串可以安全跳过所有”坏字符在模式串中不存在”的位置——这就是 BM 平均亚线性的来源。实际 BM 还叠加好后缀规则,两者取较大跳跃量。
Rabin-Karp——滚动哈希将逐字符比较压缩为 O(1) 哈希比对:
// Rabin-Karp 核心匹配(滚动哈希,基数 256,模 10^9+7)
#define BASE 256
#define MOD  1000000007

int rabin_karp_search(const char* T, int n, const char* P, int m) {
    if (m > n) return -1;
    long h = 1, hp = 0, ht = 0;
    for (int i = 0; i < m; i++) {
        h = (h * BASE) % MOD;                  // h = BASE^(m-1) % MOD
        hp = (hp * BASE + P[i]) % MOD;         // 模式串哈希
        ht = (ht * BASE + T[i]) % MOD;         // 文本首窗口哈希
    }
    for (int i = 0; i <= n - m; i++) {
        if (hp == ht) {                         // 哈希命中,逐字符验证
            int j = 0;
            while (j < m && T[i + j] == P[j]) j++;
            if (j == m) return i;               // 确认匹配
        }
        if (i < n - m) {                        // 滚动:去头加尾
            ht = ((ht - T[i] * h) * BASE + T[i + m]) % MOD;
            if (ht < 0) ht += MOD;
        }
    }
    return -1;
}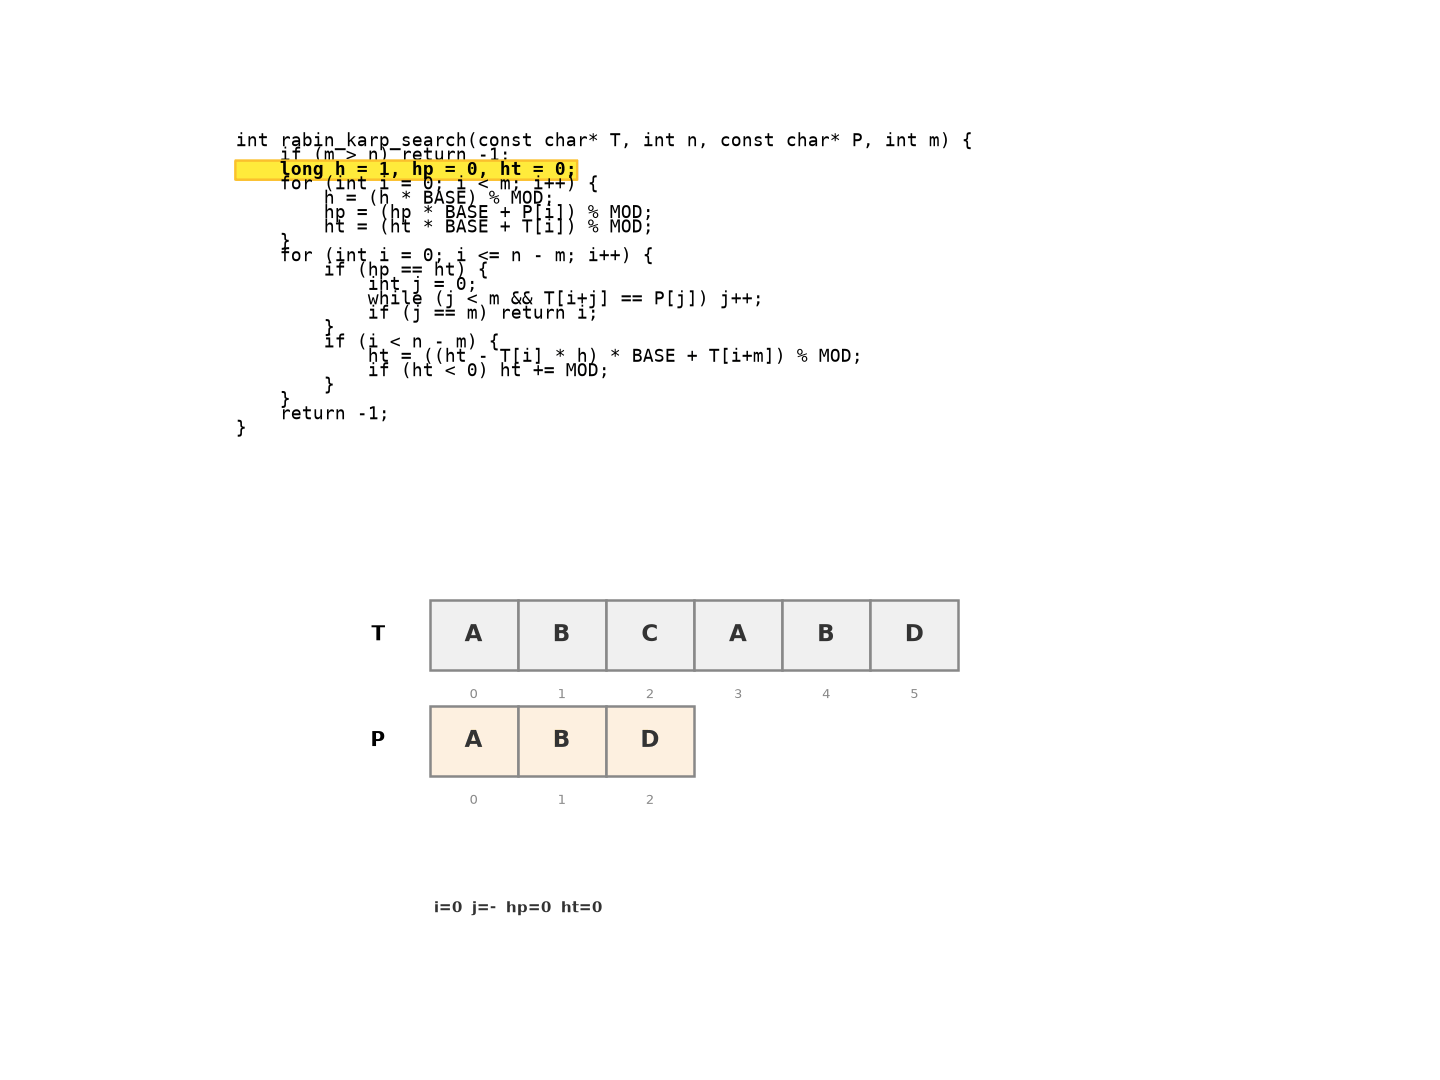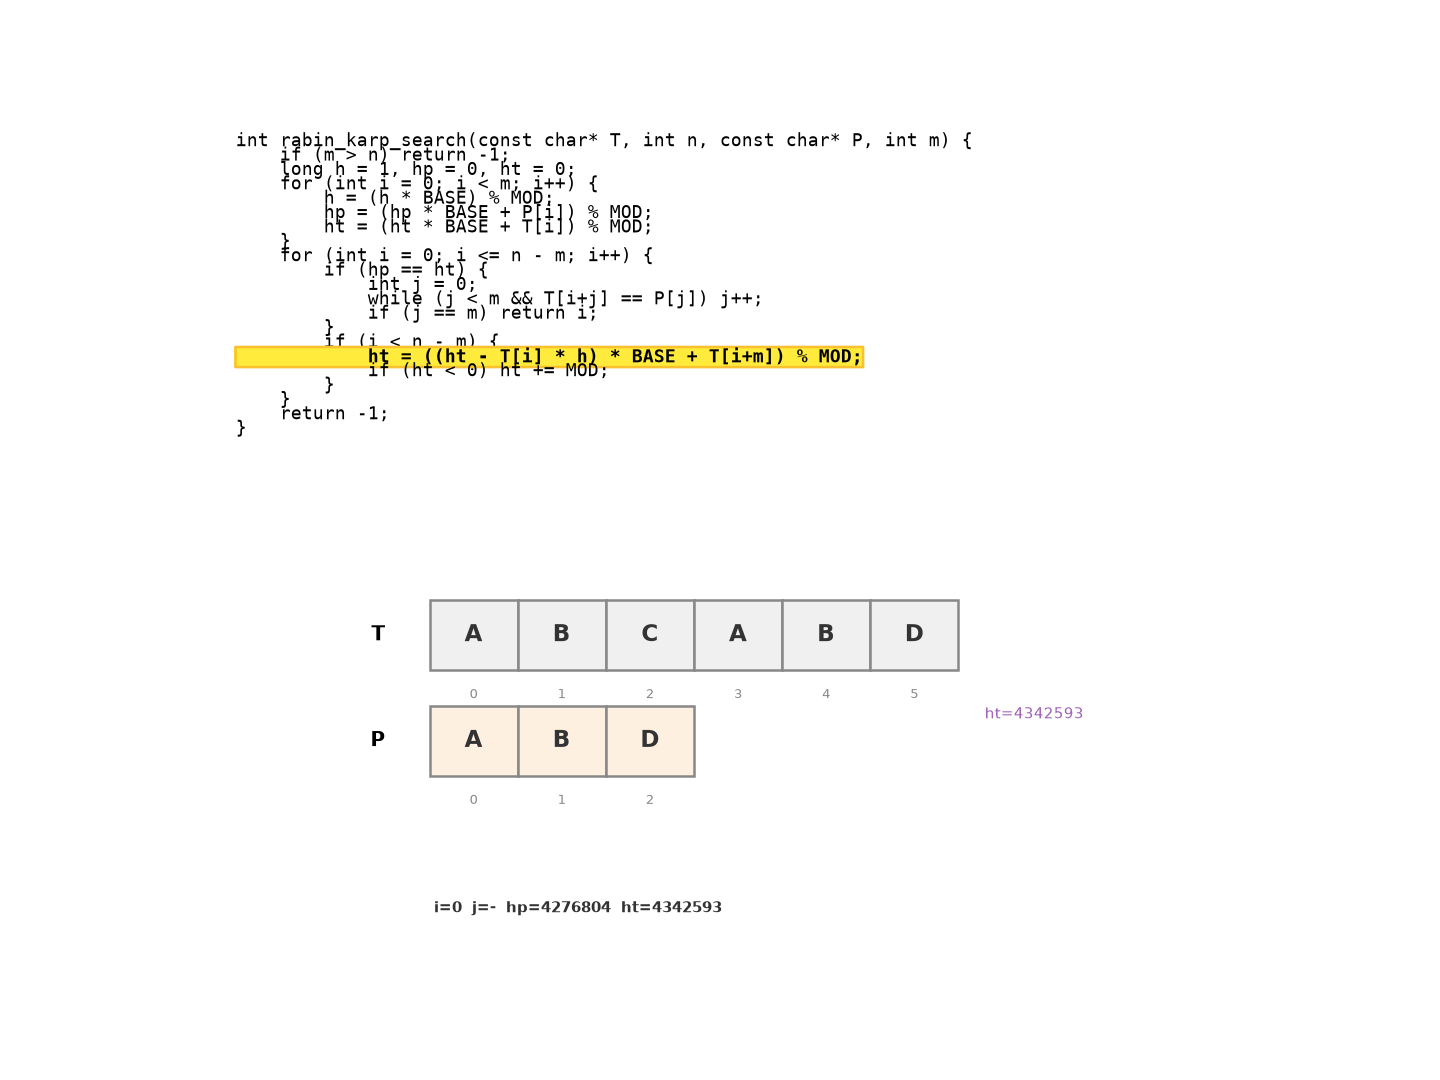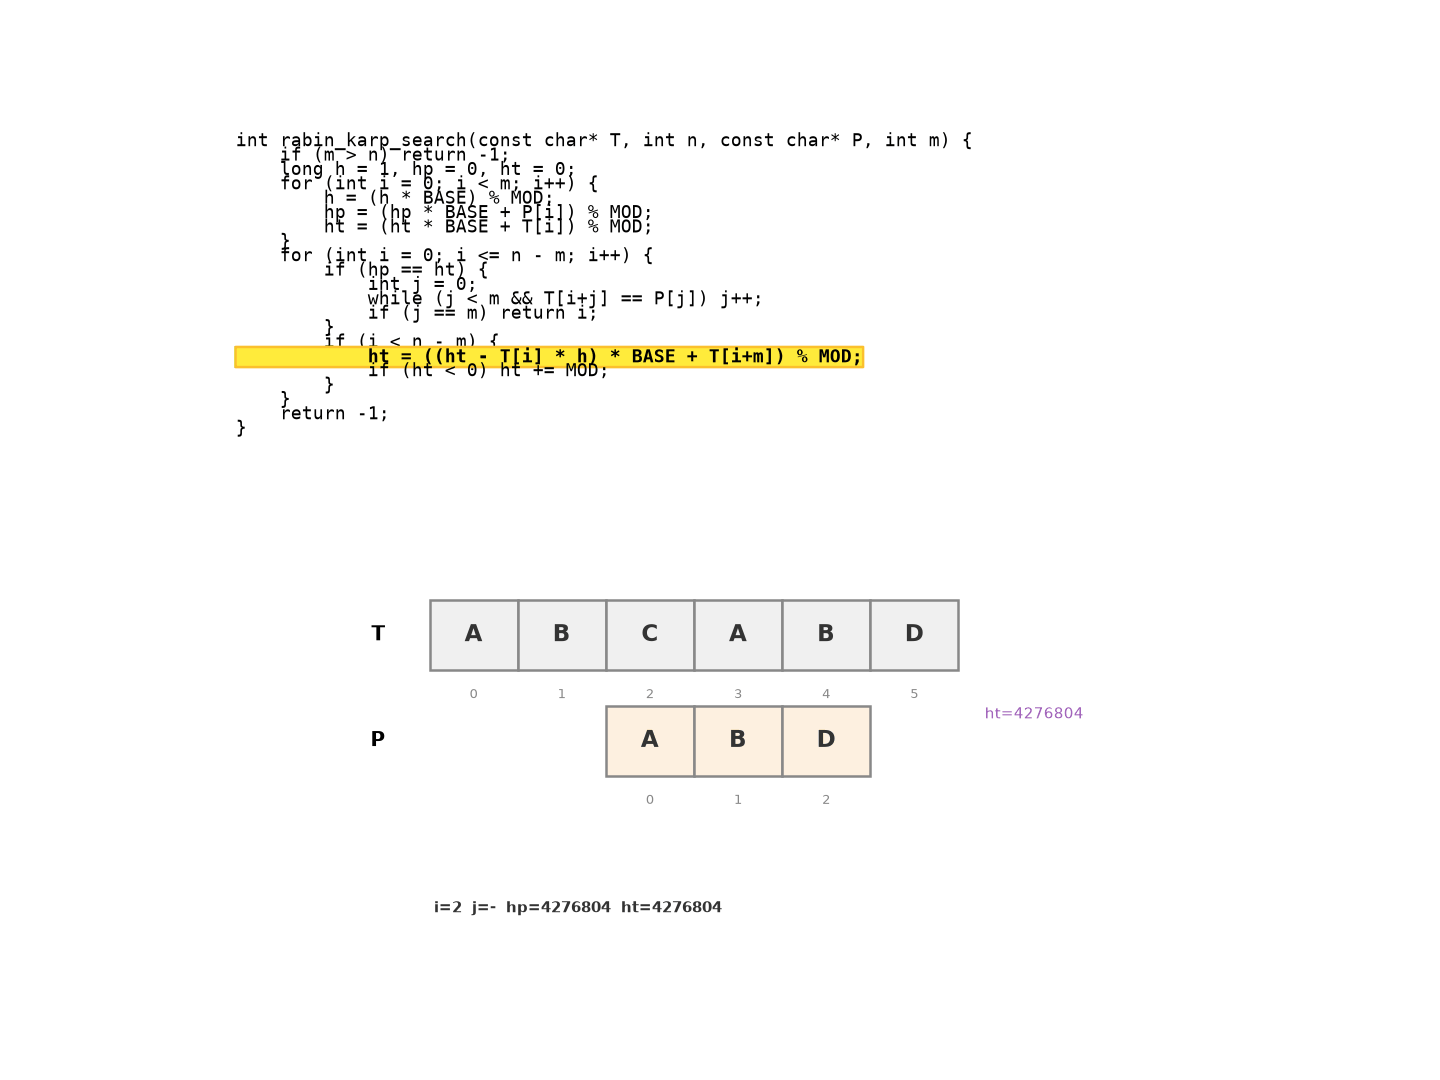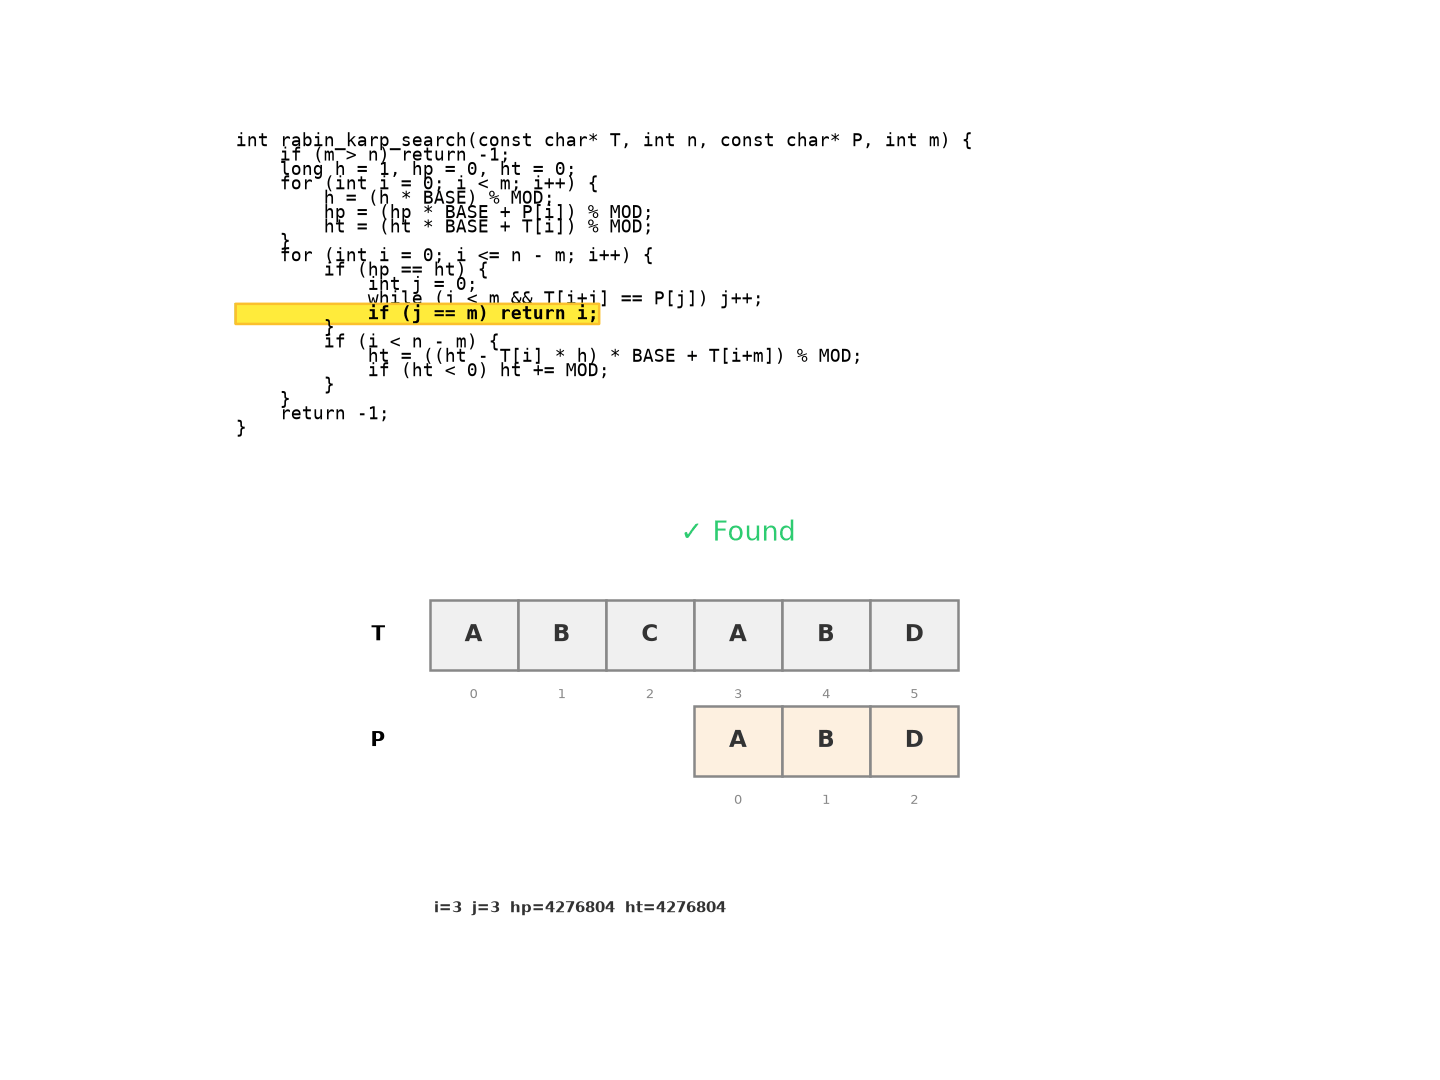
滚动哈希的核心:,每次 O(1) 更新窗口哈希值。哈希冲突时需逐字符验证,但实际冲突率极低。
Sunday 算法——BM 的简化版,只看失配位置后的下一个字符决定跳步:
// Sunday 核心匹配(不含 shift 表构建)
// shift[c] = P 中不存在时返回 m+1,否则返回末字符到 c 最右出现的距离
int sunday_search_core(const char* T, int n, const char* P, int m, const int* shift) {
    int i = 0;
    while (i <= n - m) {
        int j = 0;
        while (j < m && T[i + j] == P[j]) j++;
        if (j == m) return i;
        // Sunday 关键:看 T[i+m](对齐位置后的下一个字符)
        i += shift[(unsigned char)T[i + m]];
    }
    return -1;
}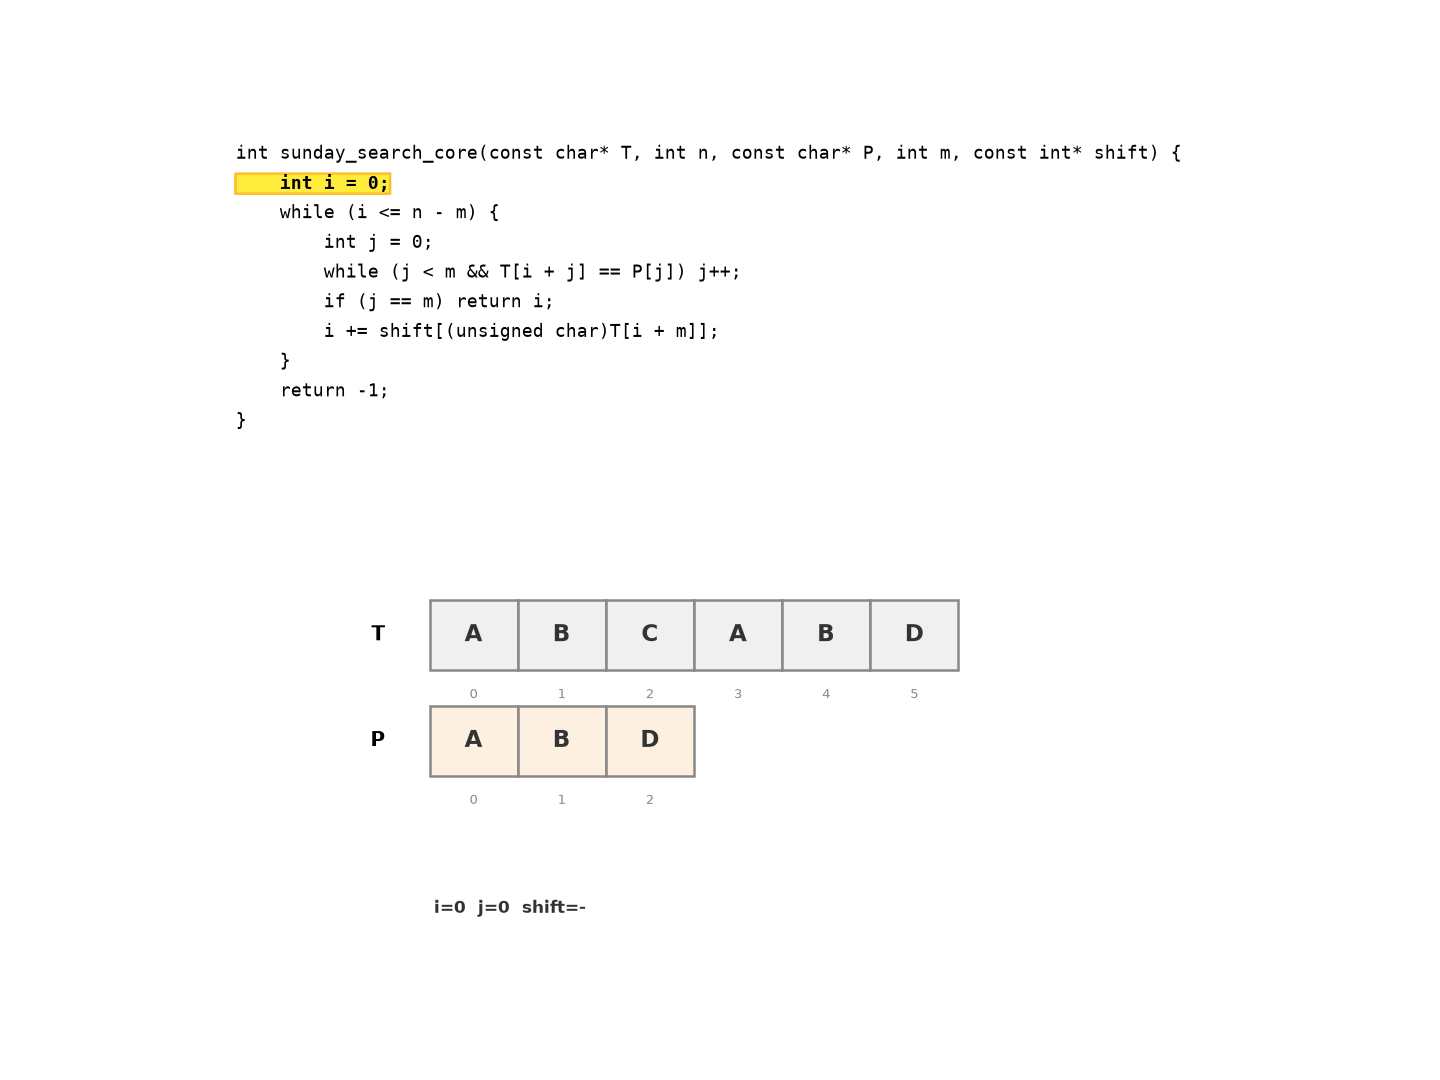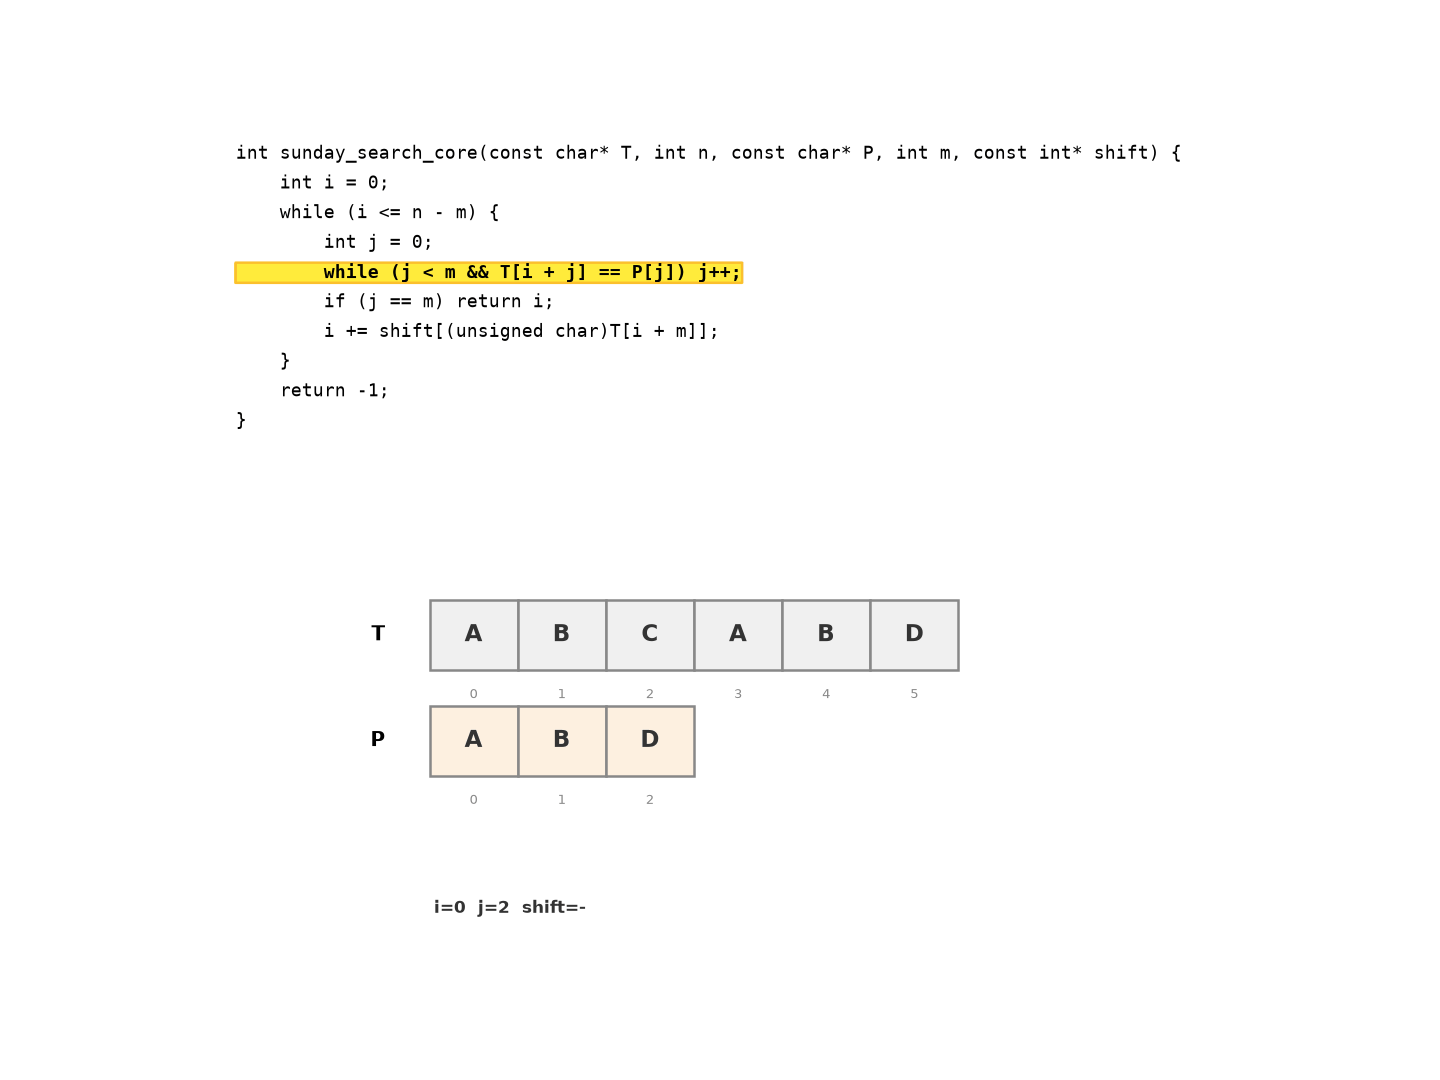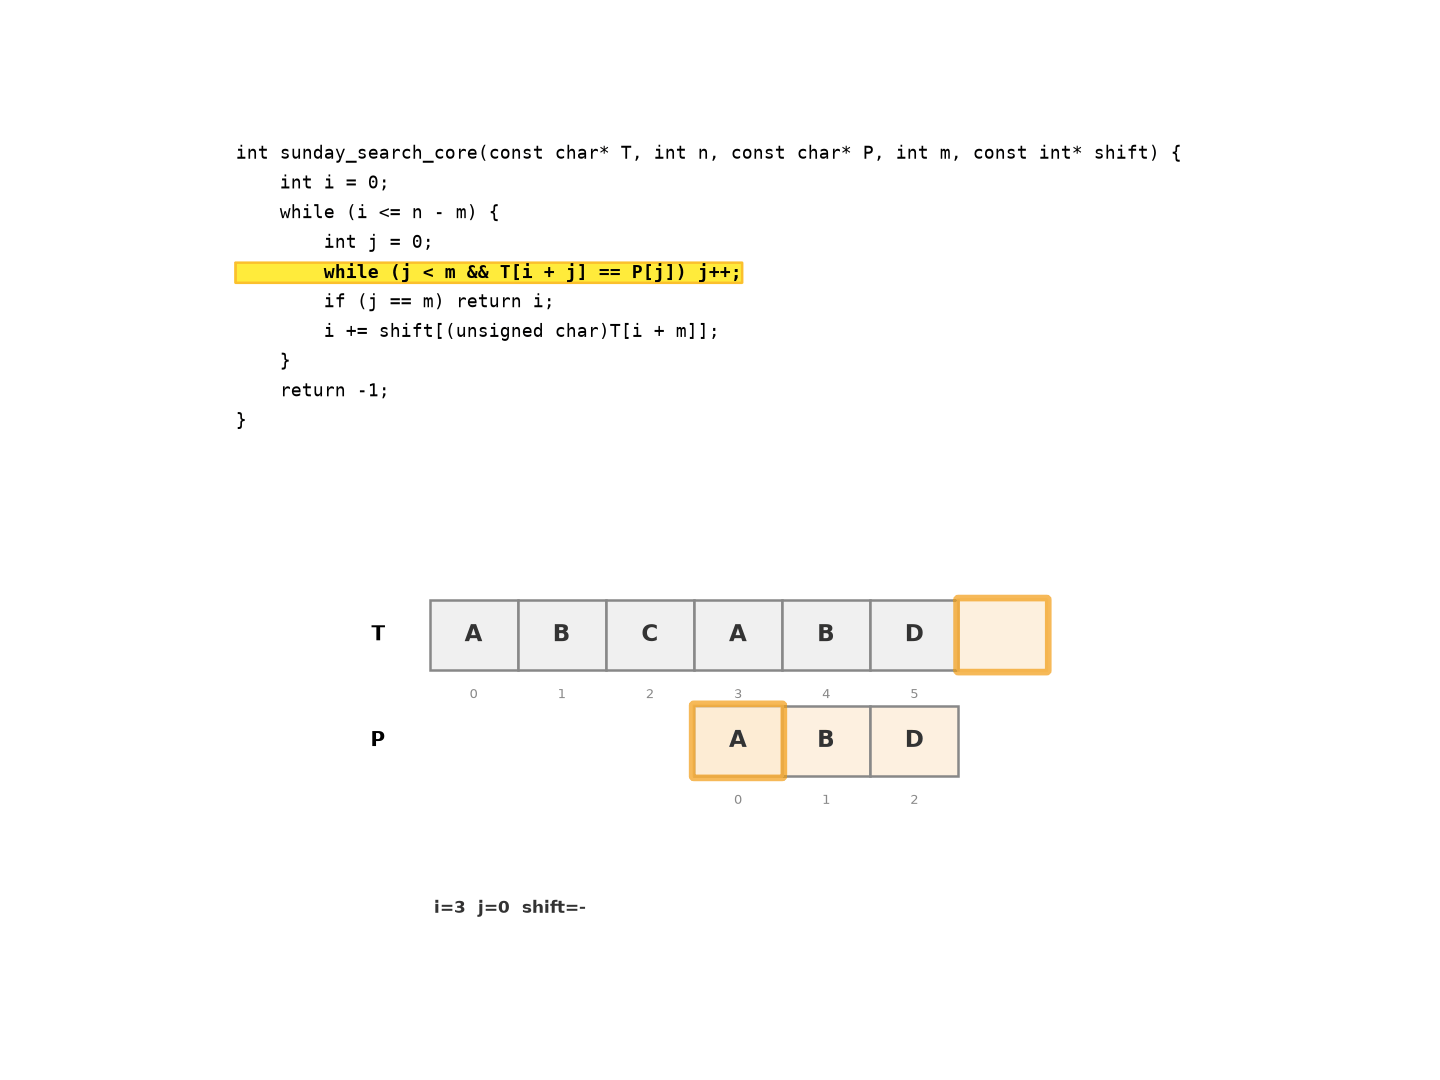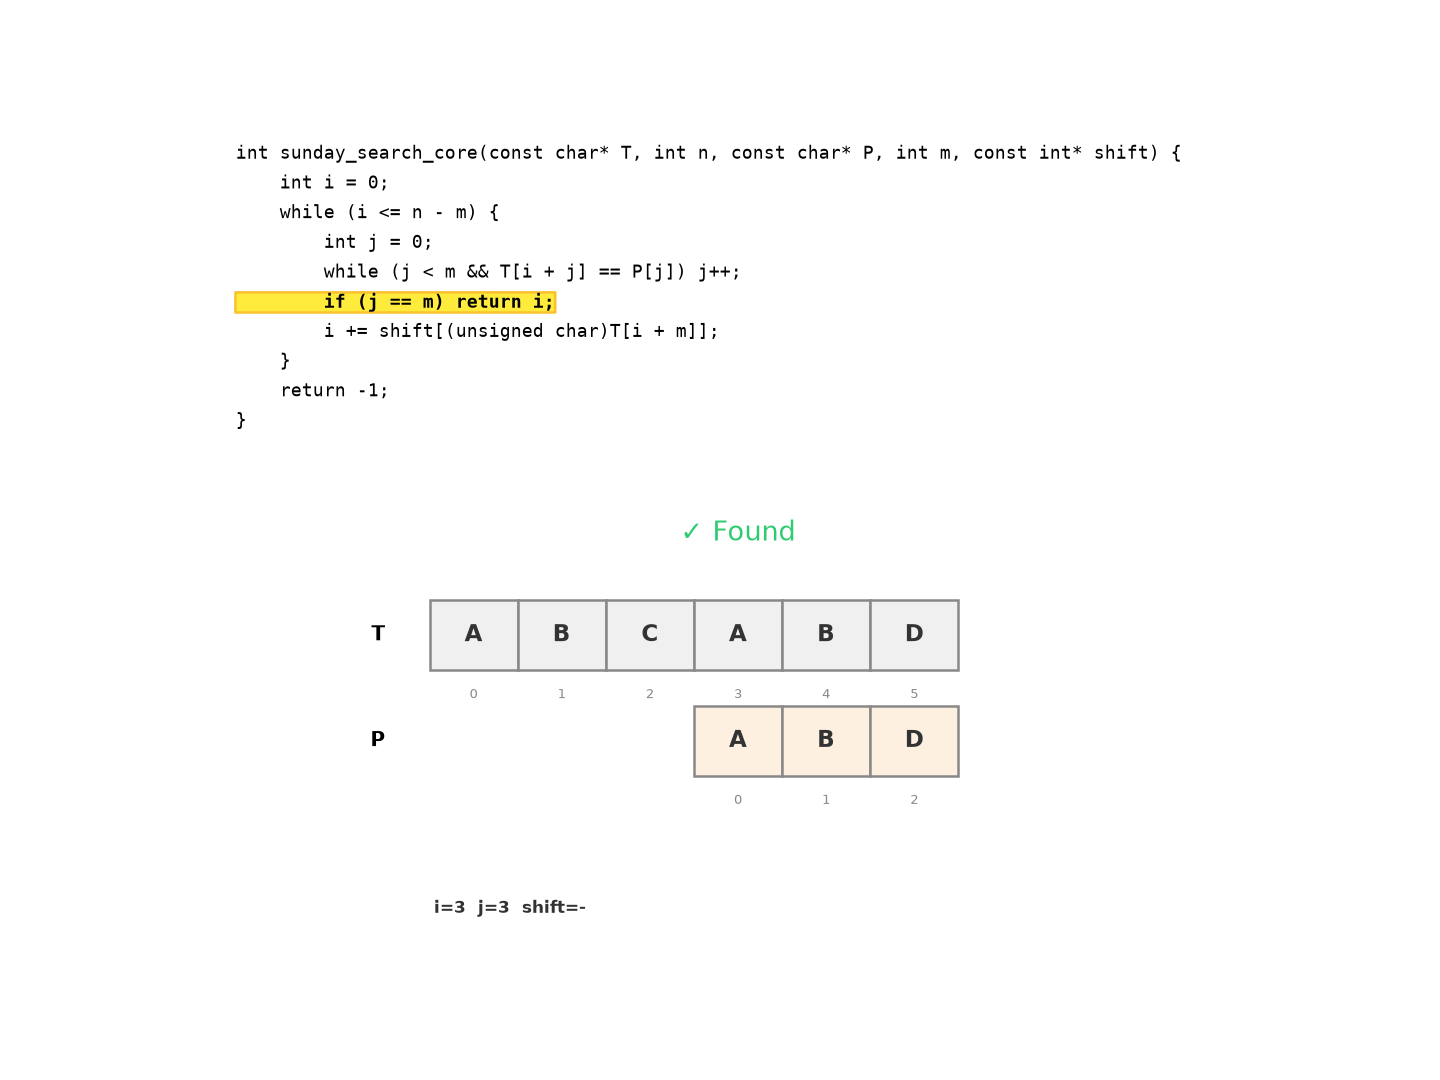
Sunday 比 BM 更简单:不需要好后缀规则,只依赖一个偏移表。在字符集较大(如 UTF-8 文本)时,跳步往往接近模式串长度,平均性能接近 BM。
字符串上的动态规划:编辑距离与 LCS
建议优先看一下动态规划章节动态规划
把”两个字符串如何互相变化”建模为二维网格上的递推。这是动态规划最经典的应用场景之一。
编辑距离(Levenshtein Distance)
定义 为把 的前 个字符变成 的前 个字符所需的最少操作数,允许的操作为插入、删除、替换(各计 1):
以 = "horse"、 = "ros" 为例的完整网格(行是 的前缀,列是 的前缀):
"" | r | o | s | |
|---|---|---|---|---|
"" | 0 | 1 | 2 | 3 |
h | 1 | 1 | 2 | 3 |
o | 2 | 2 | 1 | 2 |
r | 3 | 2 | 2 | 2 |
s | 4 | 3 | 3 | 2 |
e | 5 | 4 | 4 | 3 |
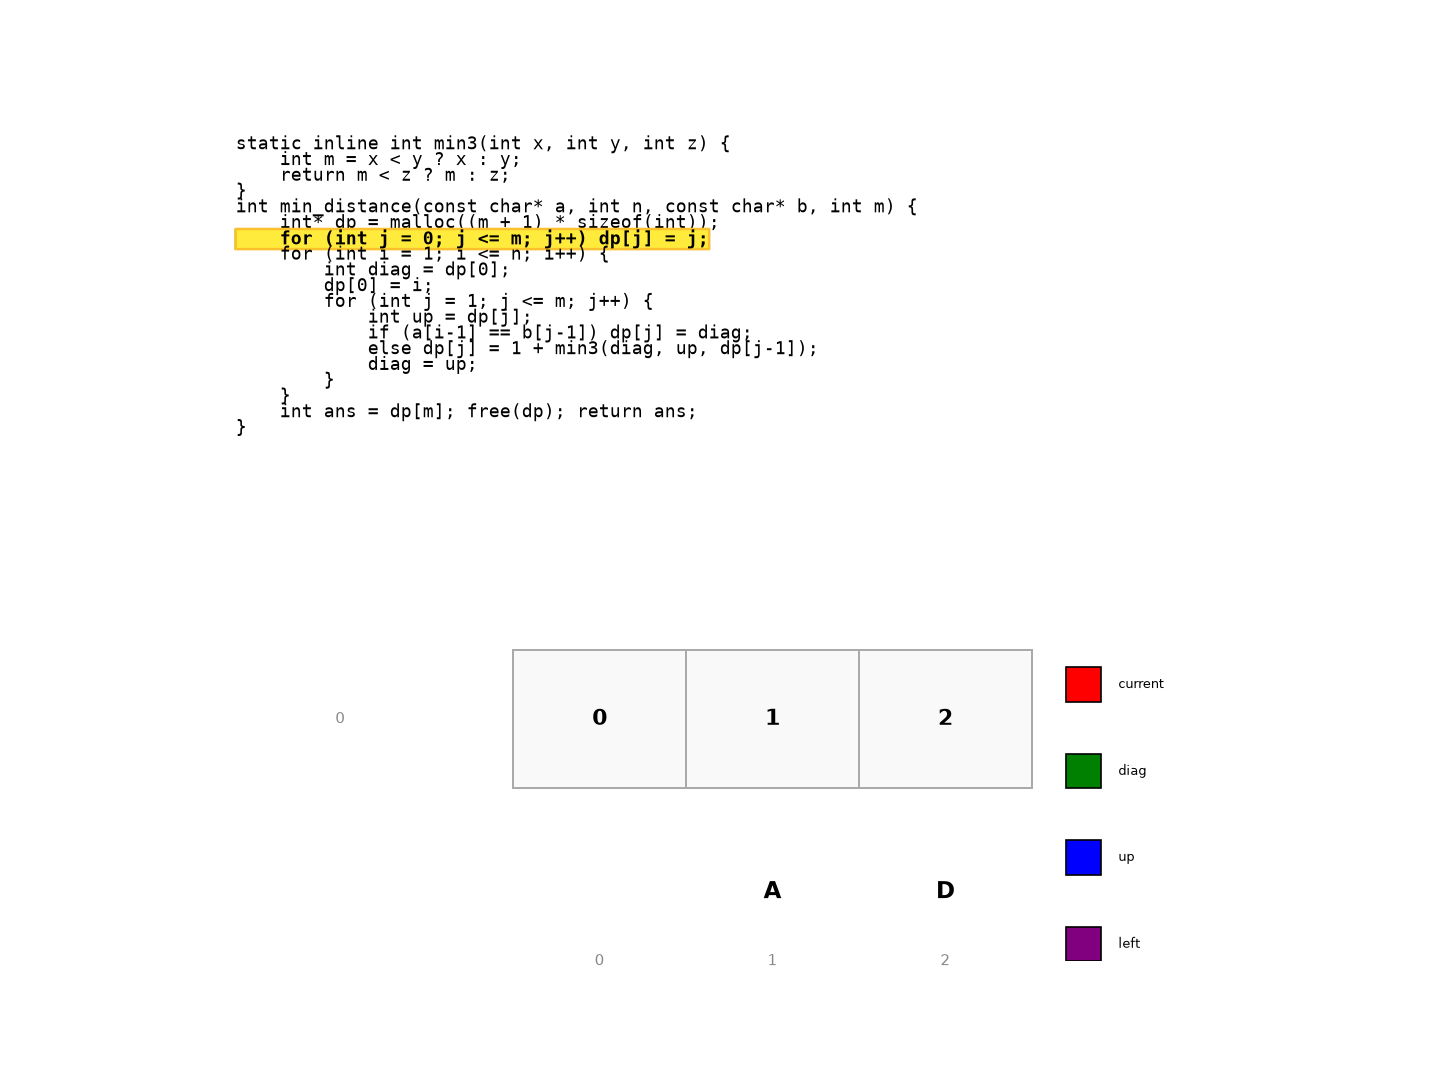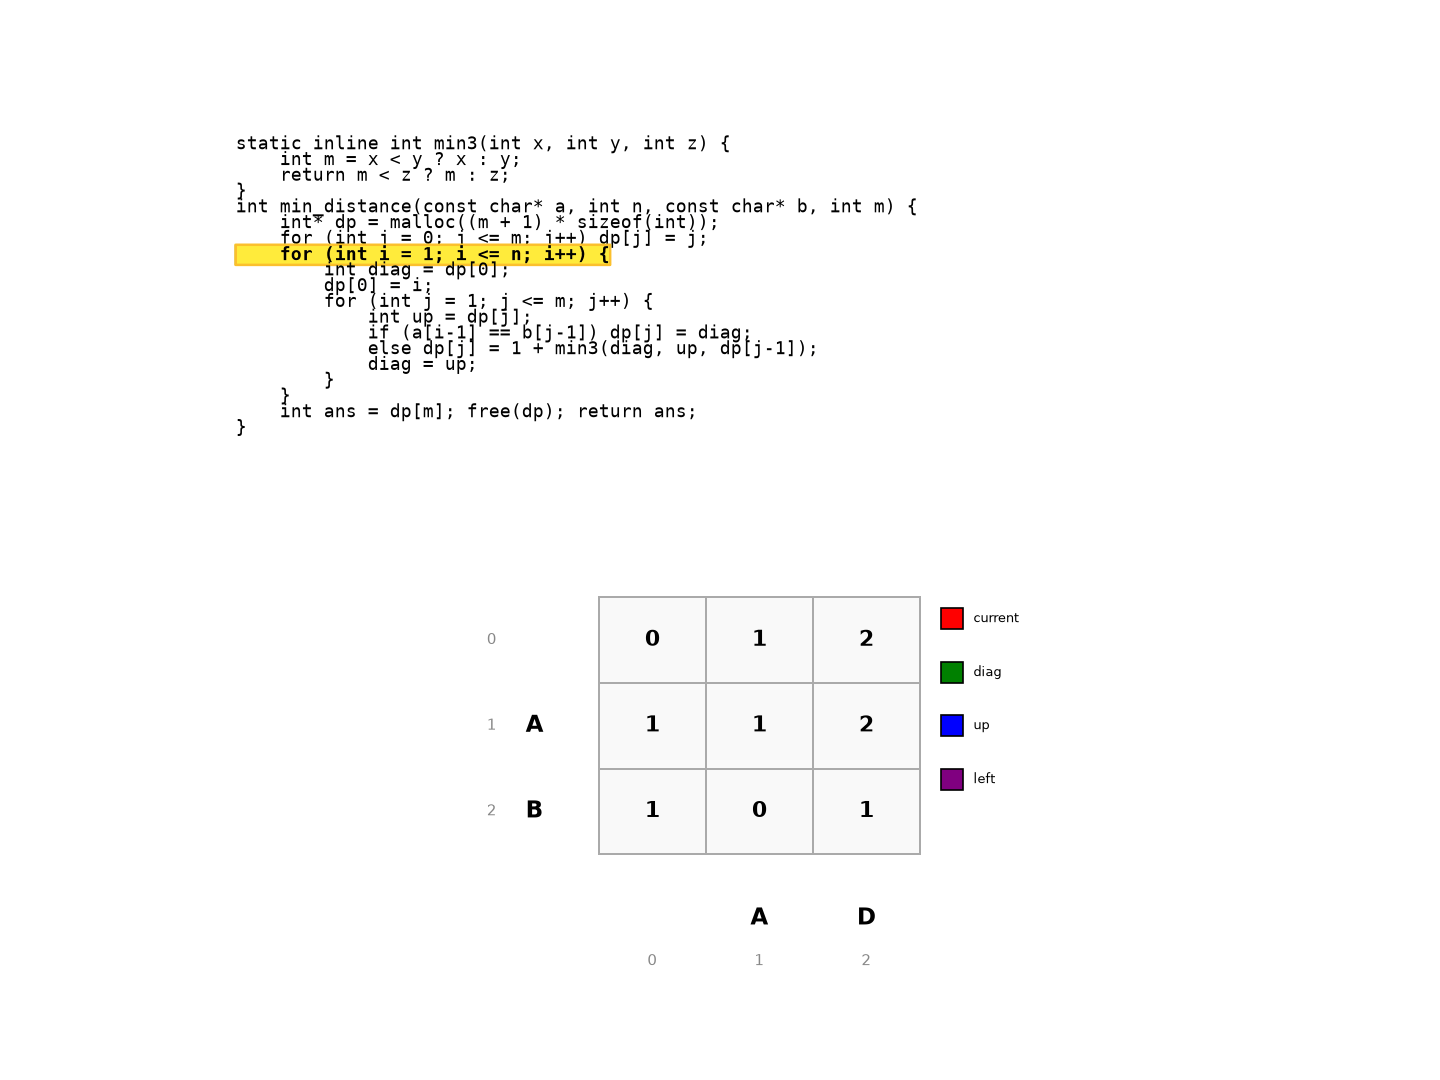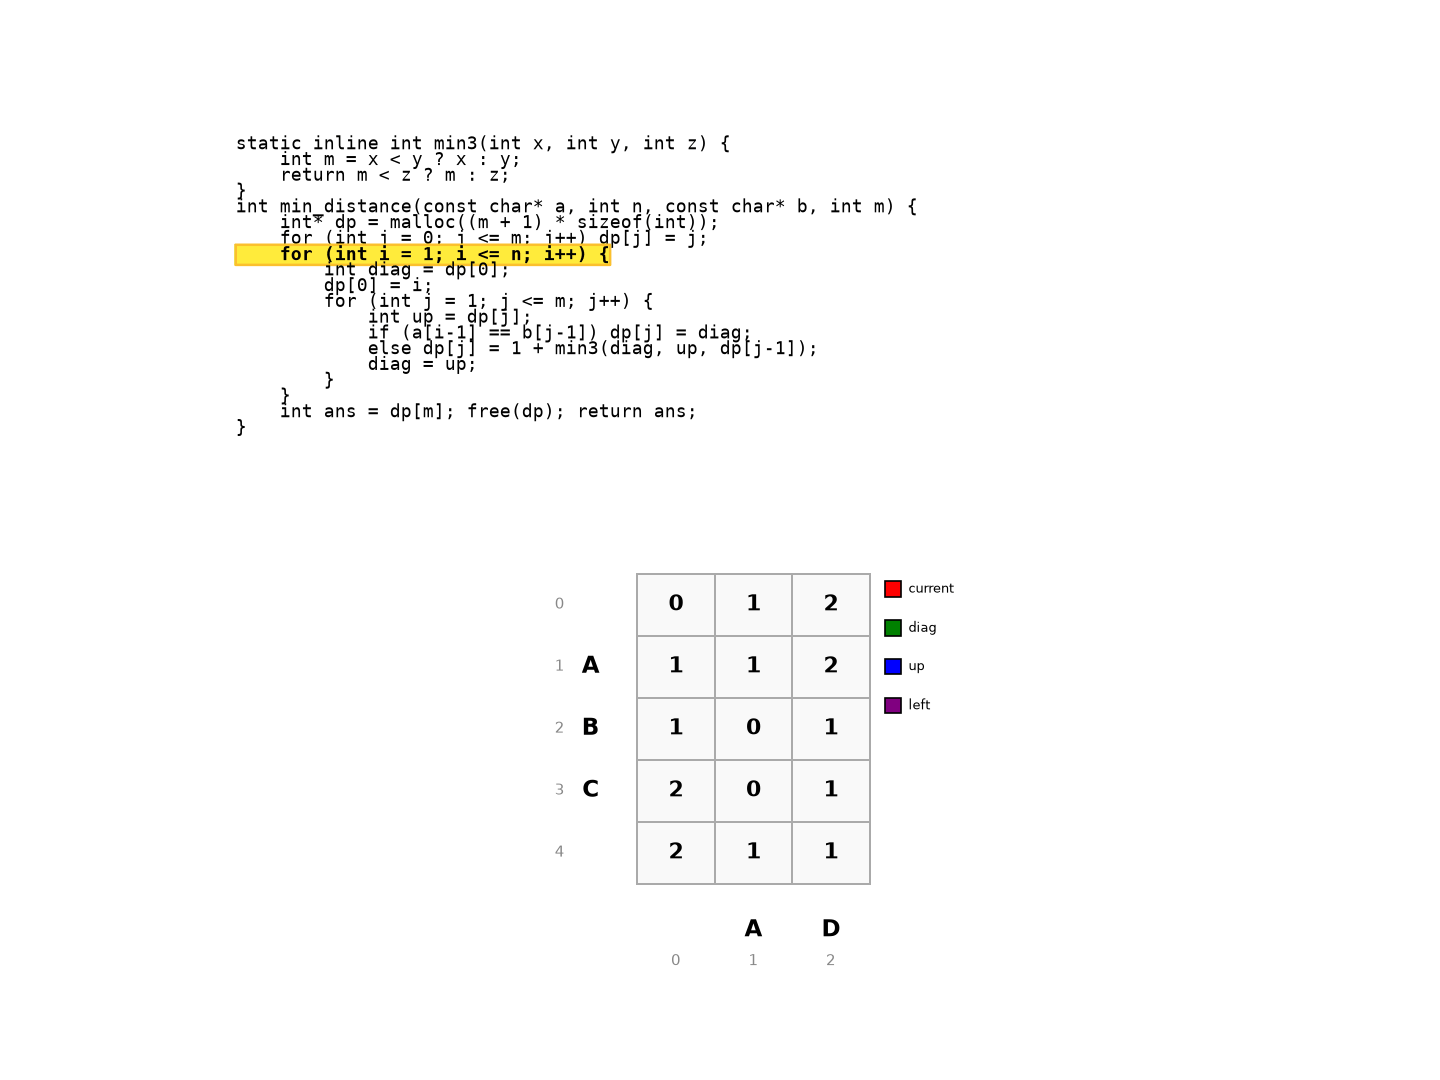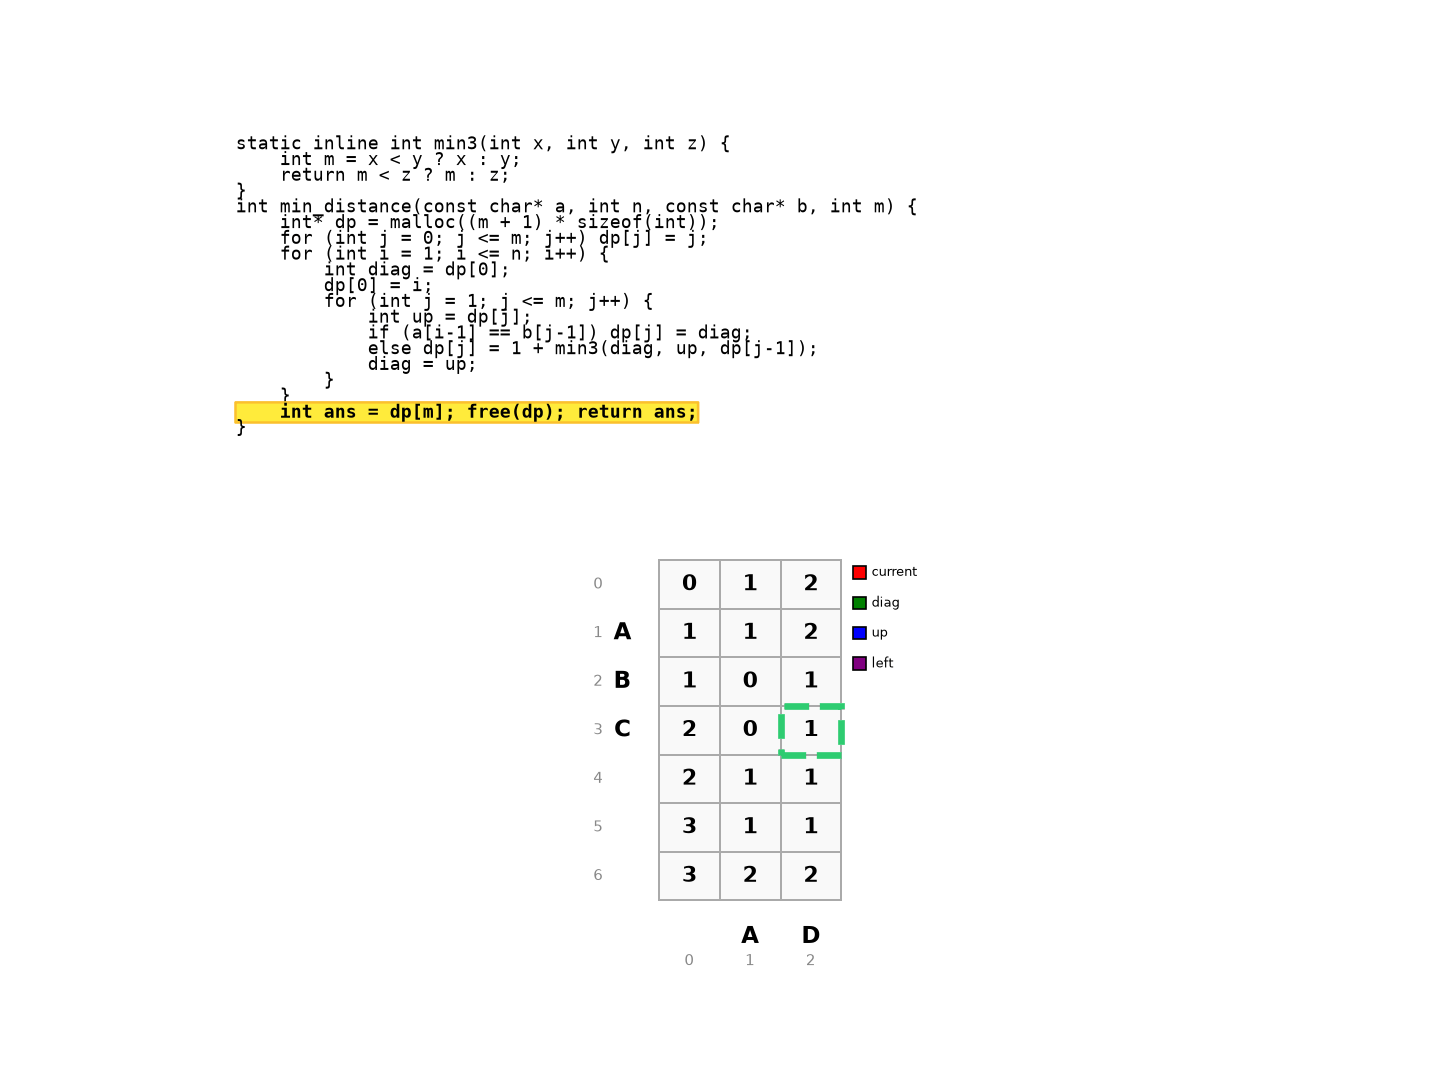
右下角 ,对应变换路径:horse → rorse(替换 h→r)→ rose(删 r)→ ros(删 e)。
时间空间都是 。注意到每个格子只依赖正上方、左方、左上三个邻居,空间可以滚动优化到 :
static inline int min3(int x, int y, int z) {
    int m = x < y ? x : y;
    return m < z ? m : z;
}

// 编辑距离 —— 滚动数组版,空间 O(m)
int min_distance(const char* a, int n, const char* b, int m) {
    int* dp = malloc((m + 1) * sizeof(int));
    for (int j = 0; j <= m; j++) dp[j] = j;    // 第 0 行:空串变成 B 前 j 个字符
    for (int i = 1; i <= n; i++) {
        int diag = dp[0];                      // diag = dp[i-1][j-1],左上角
        dp[0] = i;                             // 第 i 行第 0 列:A 前 i 个变成空串
        for (int j = 1; j <= m; j++) {
            int up = dp[j];                    // up = dp[i-1][j],正上方,先存后覆盖
            if (a[i-1] == b[j-1])
                dp[j] = diag;                  // 尾字符相同,免费继承左上
            else
                dp[j] = 1 + min3(diag, up, dp[j-1]);   // 替换 / 删除 / 插入
            diag = up;
        }
    }
    int ans = dp[m];
    free(dp);
    return ans;
}
编辑距离是拼写检查、DNA 序列比对(Smith-Waterman 局部对齐是它的变体)、模糊搜索的核心度量。
最长公共子序列(LCS)
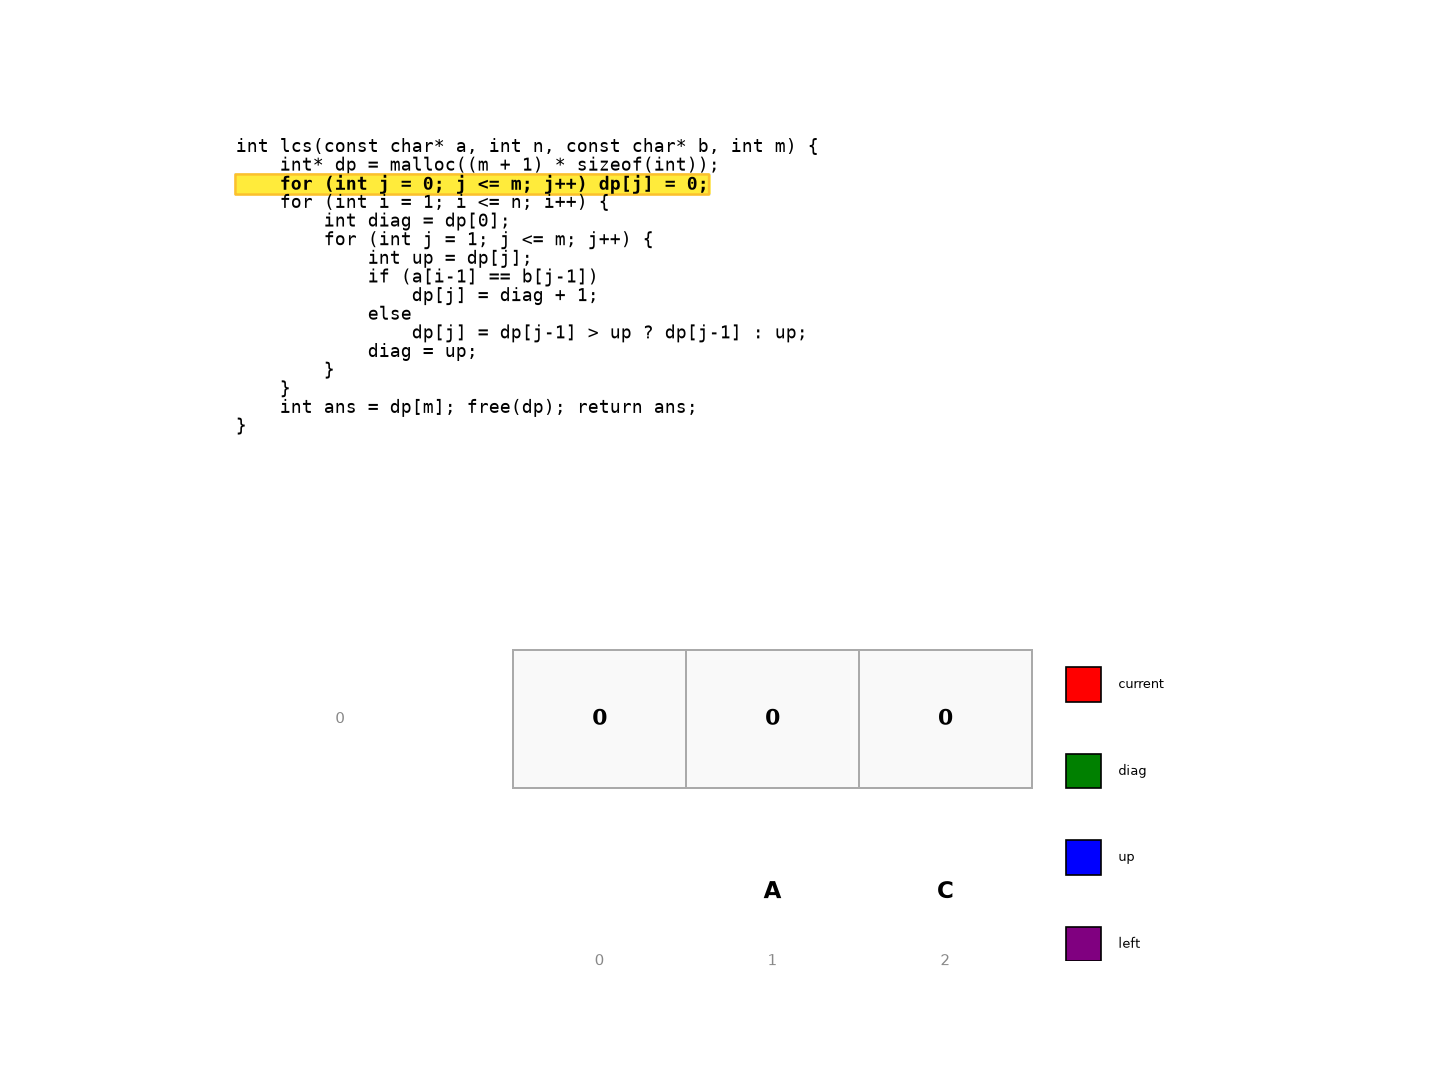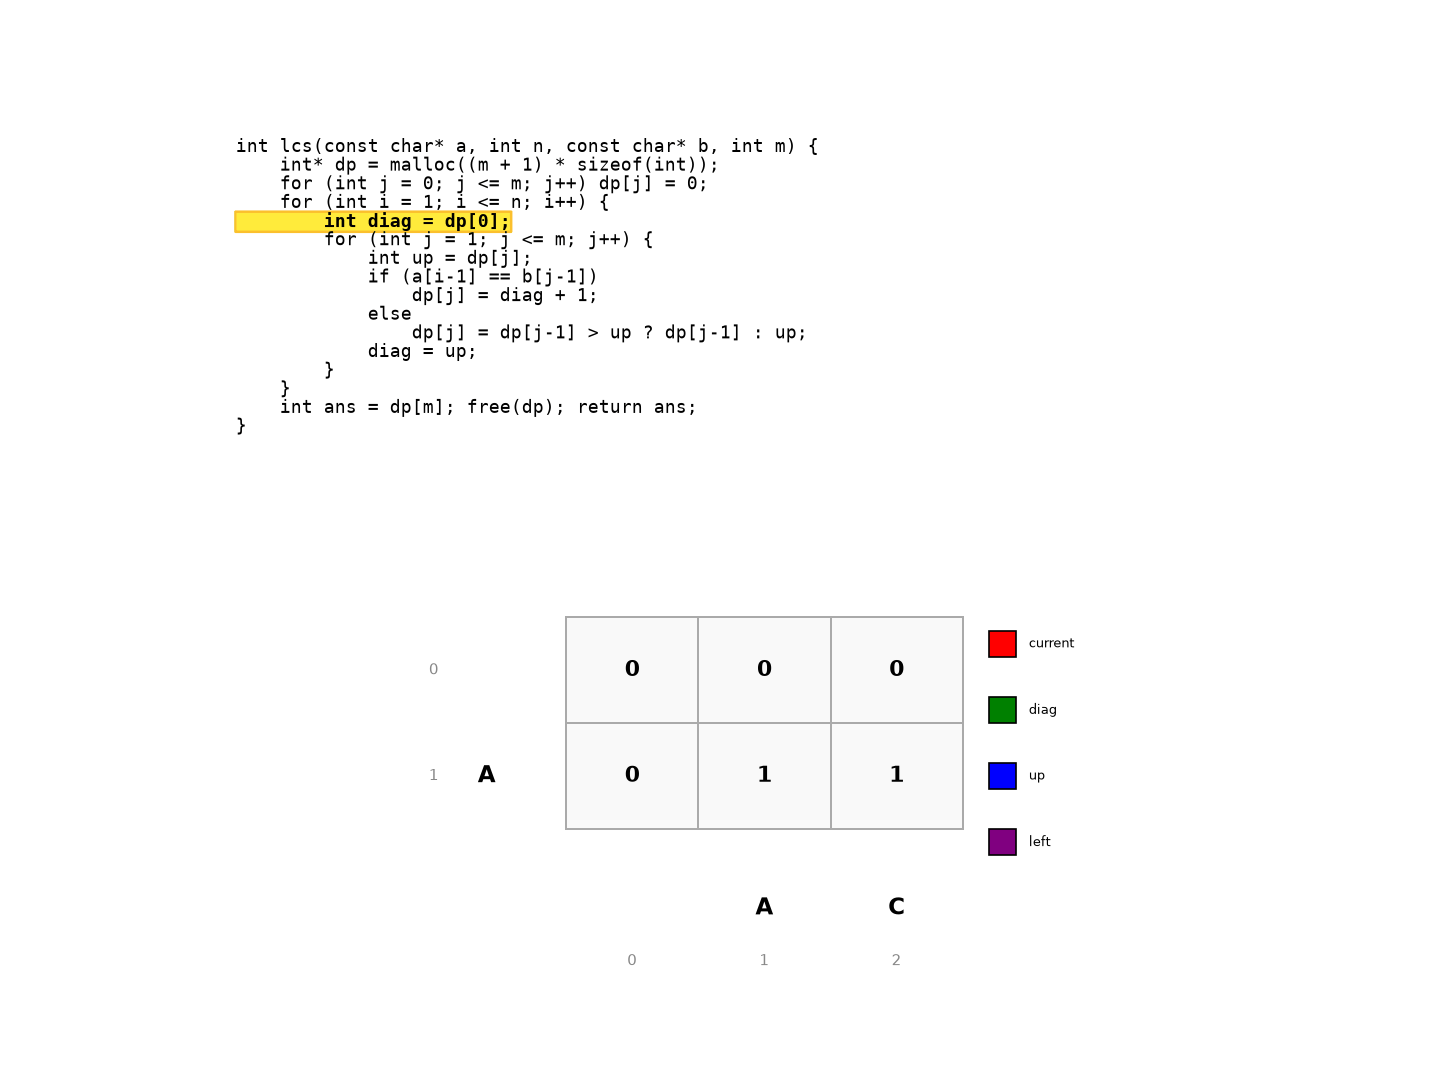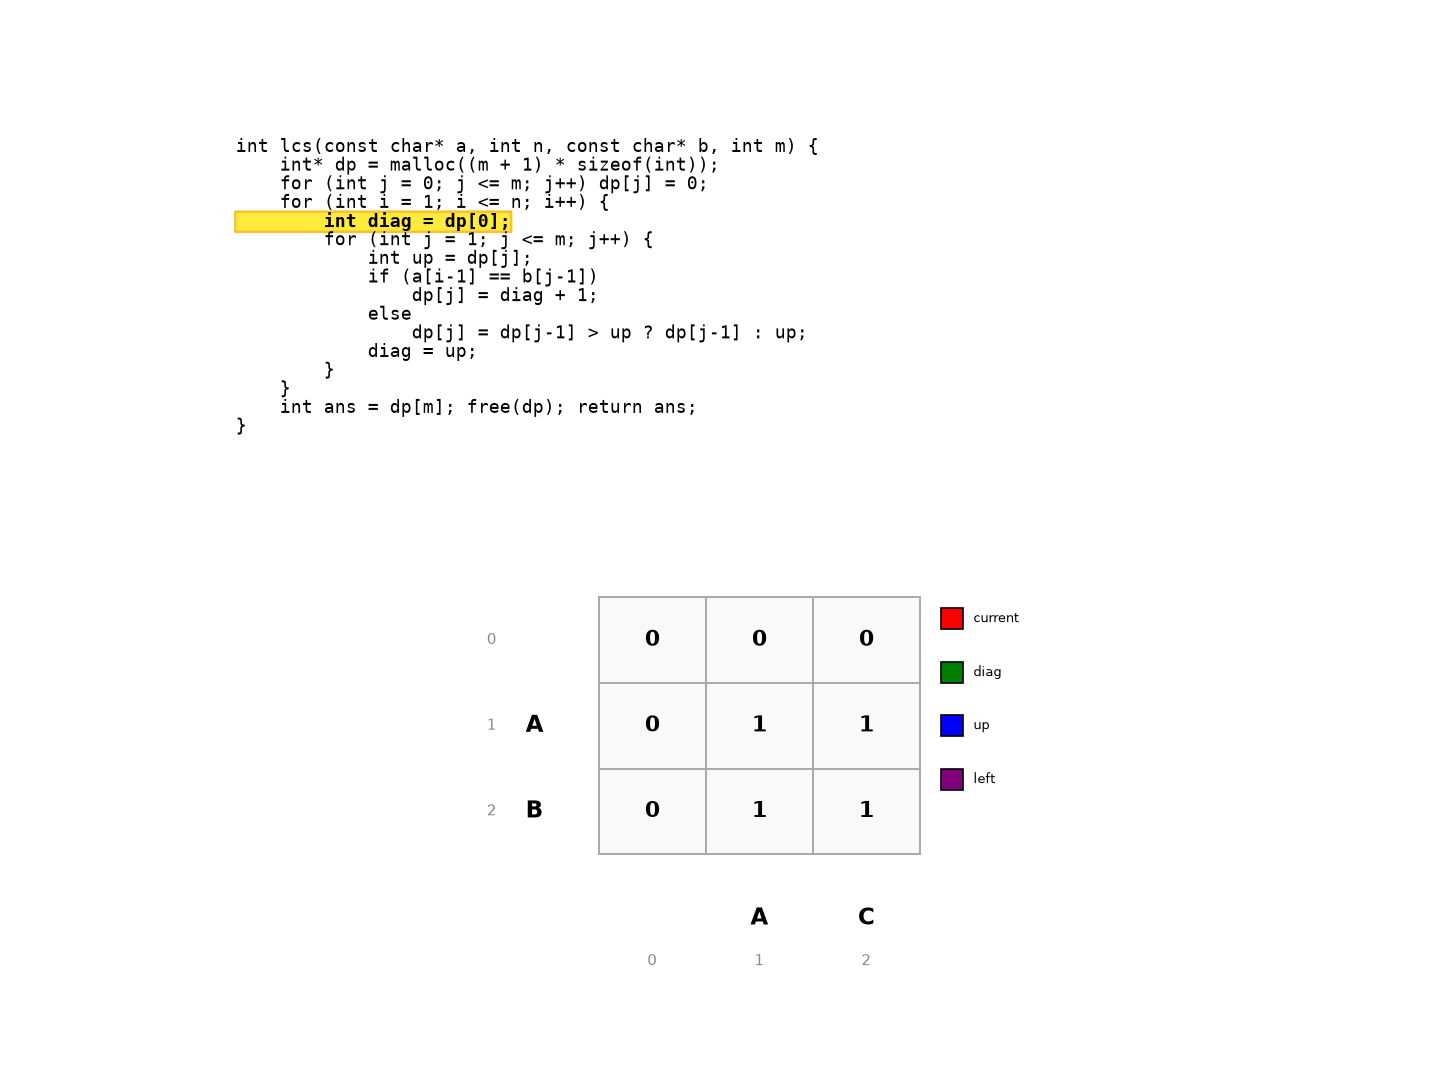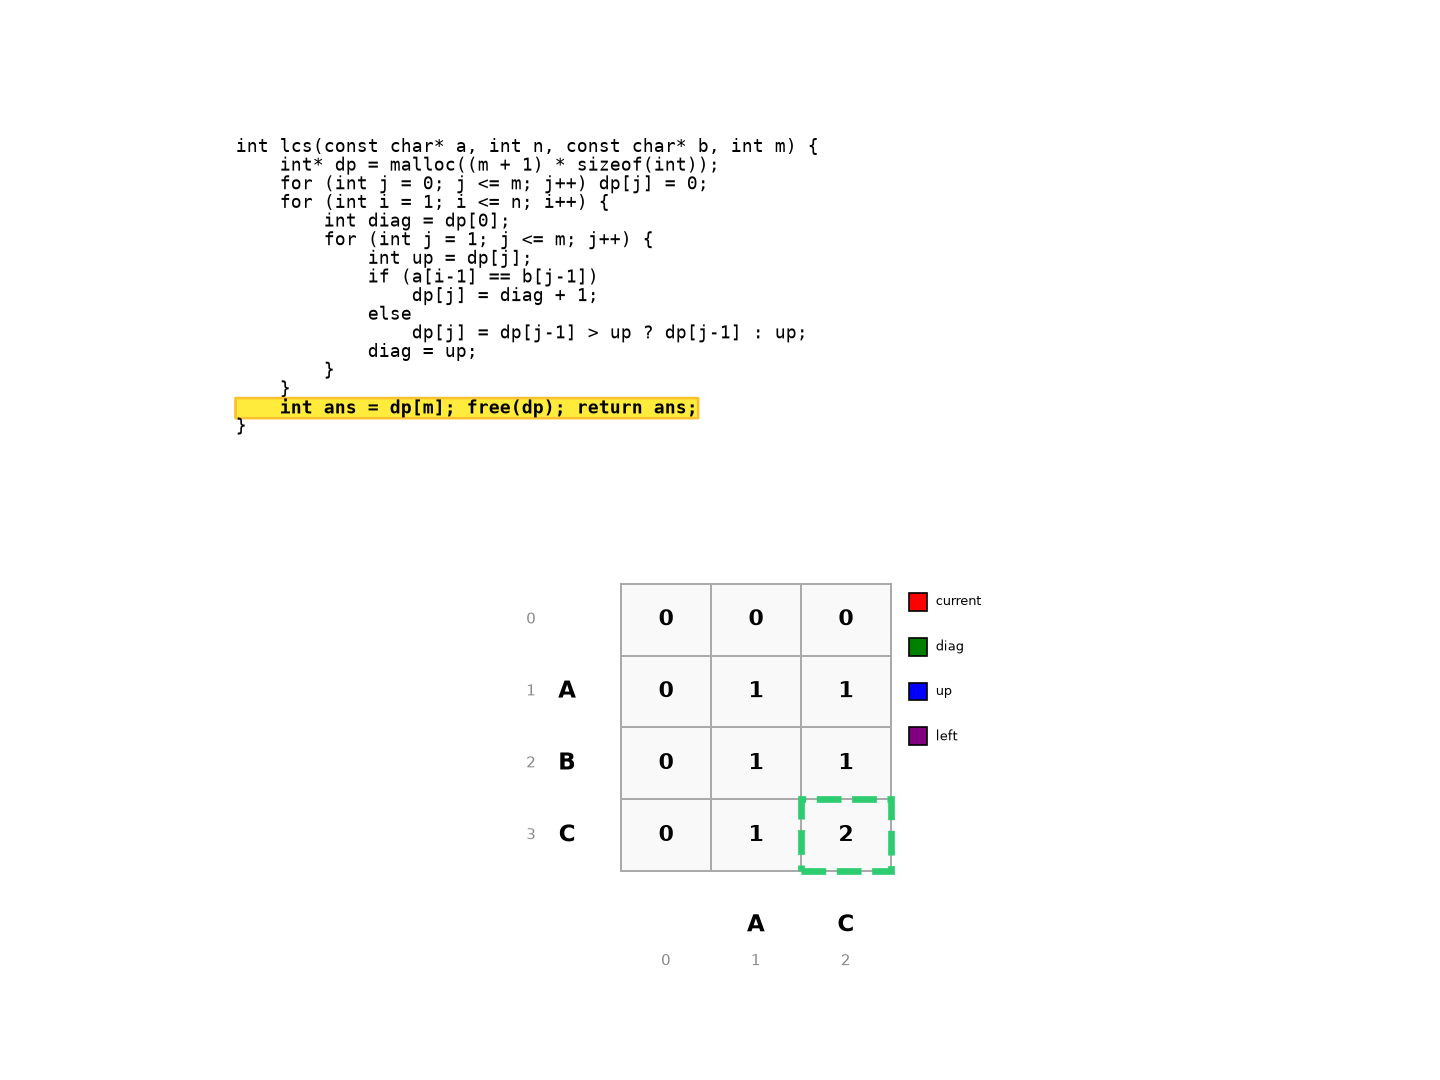
与编辑距离共用同一张网格,换一个问题: 记录 前 个与 前 个的最长公共子序列长度:
两者的深层关系:当只允许插入和删除时,。它们共享同一个” 网格 + 三邻居依赖”框架,差别只在转移方程的聚合方向(min 还是 max)。这个模式还会出现在通配符匹配、文件 diff(GNU diff 的内核就是 LCS)等场景中。
// LCS —— 滚动数组版,空间 O(min(m,n))
int lcs(const char* a, int n, const char* b, int m) {
    int* dp = malloc((m + 1) * sizeof(int));
    for (int j = 0; j <= m; j++) dp[j] = 0;
    for (int i = 1; i <= n; i++) {
        int diag = dp[0];
        for (int j = 1; j <= m; j++) {
            int up = dp[j];
            if (a[i-1] == b[j-1])
                dp[j] = diag + 1;
            else
                dp[j] = dp[j-1] > up ? dp[j-1] : up;
            diag = up;
        }
    }
    int ans = dp[m];
    free(dp);
    return ans;
}
注意 LCS 是子序列(可跳字符),而”最长公共子串”要求连续——后者用下一节的后缀数组可以高效求解。两个名字一字之差,做法完全不同。
DP 网格填表
给定两串,写出 DP 表格(或其前几行)
① 编辑距离: = "ab"、 = "ba",写出完整网格并给出距离。
② LCS: = "abcde"、 = "ace",写出完整网格并给出 LCS 长度。
①
"" | b | a | |
|---|---|---|---|
"" | 0 | 1 | 2 |
a | 1 | 1 | 1 |
b | 2 | 1 | 2 |
距离 = 2。自查要点:dp[1][1] 处 ‘a’≠‘b’,取 ;dp[1][2] 处尾字符相同免费继承左上的 1;dp[2][2] 处 ‘b’≠‘a’ 取 。顺手验证本章公式:,,与答案一致。
②
"" | a | c | e | |
|---|---|---|---|---|
"" | 0 | 0 | 0 | 0 |
a | 0 | 1 | 1 | 1 |
b | 0 | 1 | 1 | 1 |
c | 0 | 1 | 2 | 2 |
d | 0 | 1 | 2 | 2 |
e | 0 | 1 | 2 | 3 |
LCS = 3(即 “ace” 本身)。自查要点:字符相等时是 而不是 max 三邻居——这是与编辑距离最容易混的一格;不等时取上下、左右中的较大者。
后缀结构与后缀数组
KMP 解决的是”一个模式串在一篇文本中的定位”。如果要对同一篇固定文本反复查询任意子串(搜索引擎索引、DNA 库检索的场景),每次都跑一遍匹配就太慢了——正确姿势是对文本建立一次性的索引结构。后缀家族就是干这个的。
核心观察:文本 的所有后缀包含了它的全部子串——任何子串都是某个后缀的前缀。把 的 个后缀按字典序排序,得到后缀数组 sa: 是字典序排名第 的后缀的起始下标。
以 = "banana" 为例:
| 排名 | 后缀 | |
|---|---|---|
| 0 | 5 | a |
| 1 | 3 | ana |
| 2 | 1 | anana |
| 3 | 0 | banana |
| 4 | 4 | na |
| 5 | 2 | nana |
配套的 LCP 数组记录排名相邻两后缀的最长公共前缀长度:上表对应 lcp = [—, 1, 3, 0, 0, 2](如 ana 与 anana 公共前缀 "ana" 长 3)。
有了这两张表,一批经典问题化为几次二分或一次线性扫描:
| 问题 | 做法 | 复杂度 |
|---|---|---|
| 子串 是否出现 | 二分查找: 与有序后缀比较 | |
| 子串出现次数 | 二分定出上下界之差 | |
| 最长重复子串 | ||
| 两串最长公共子串 | 拼接后取跨界 max(lcp) | |
| 不同子串总数 |
构造方法的复杂度阶梯:
| 方法 | 思路 | 复杂度 |
|---|---|---|
| 直接排序 | 个后缀丢给 qsort,单次比较 | |
| 倍增法 Doubling | 按 长度的排名迭代重排 | |
| SA-IS / DC3 | 线性构造 |
它的不变量非常干净:“长度 片段的排名”由相邻两个”长度 片段的排名”组成的二元组决定:
每轮做一次基数排序完成重排,共 轮。它同时是理解后缀自动机、后缀树等更高级结构的台阶。
后缀家族的关系谱系:压缩后缀 Trie 得到后缀树(Ukkonen 算法可 构建),后缀树的边按字典序整理即得后缀数组。工程实践中后缀数组因内存紧凑、缓存友好而更常用;多模式串的在线匹配则交给 Trie 章节的 Aho-Corasick 自动机——它们共同构成”文本索引”主题的完整工具箱。
以下是后缀数组的核心实现——聚焦算法逻辑(完整模块含结构体定义见 ## 实现)。
倍增法构建后缀数组——从长度 1 的排名出发,每轮将排名翻倍,用基数排序重排:
// 倍增法构建后缀数组 sa[0..n-1]
// rank[i] = 起始位置为 i 的后缀当前排名,tmp[] 为辅助排序键
void build_sa(const char* s, int n, int* sa, int* rank, int* tmp) {
    for (int i = 0; i < n; i++) { sa[i] = i; rank[i] = s[i]; }
    for (int k = 1; k < n; k <<= 1) {
        // 按 (rank[i], rank[i+k]) 双关键字排序
        auto cmp = [&](int a, int b) {
            if (rank[a] != rank[b]) return rank[a] < rank[b];
            int ra = a + k < n ? rank[a + k] : -1;
            int rb = b + k < n ? rank[b + k] : -1;
            return ra < rb;
        };
        std::sort(sa, sa + n, cmp);
        // 重新编号排名
        tmp[sa[0]] = 0;
        for (int i = 1; i < n; i++)
            tmp[sa[i]] = tmp[sa[i-1]] + (cmp(sa[i-1], sa[i]) ? 1 : 0);
        for (int i = 0; i < n; i++) rank[i] = tmp[i];
        if (rank[sa[n-1]] == n - 1) break;   // 所有后缀已区分
    }
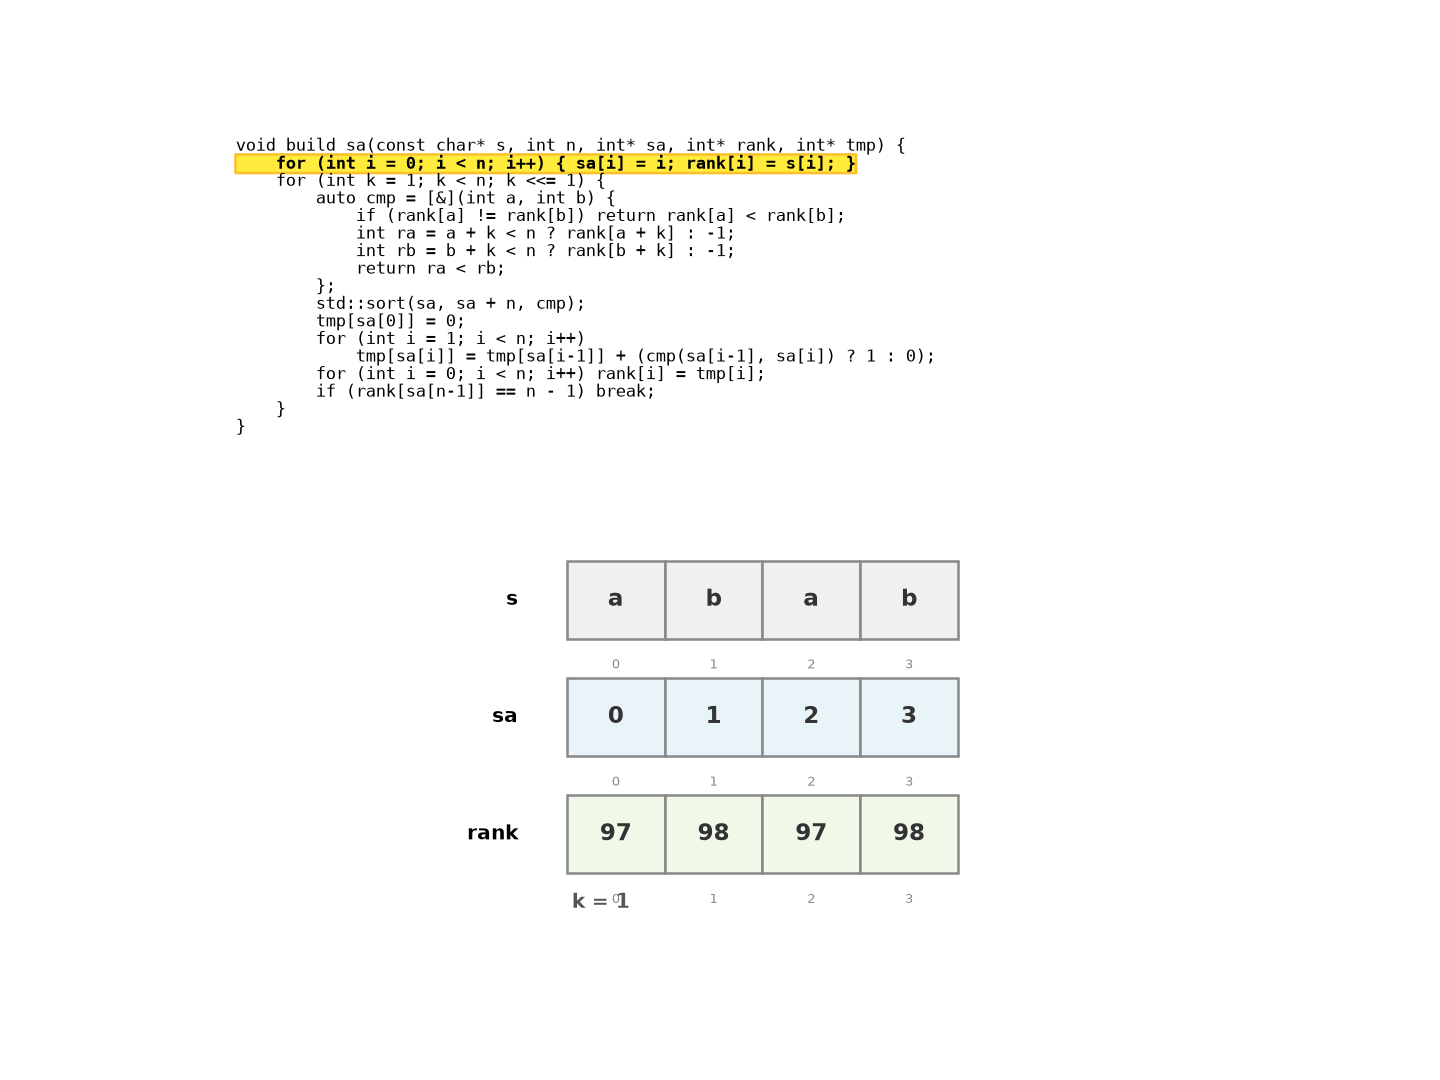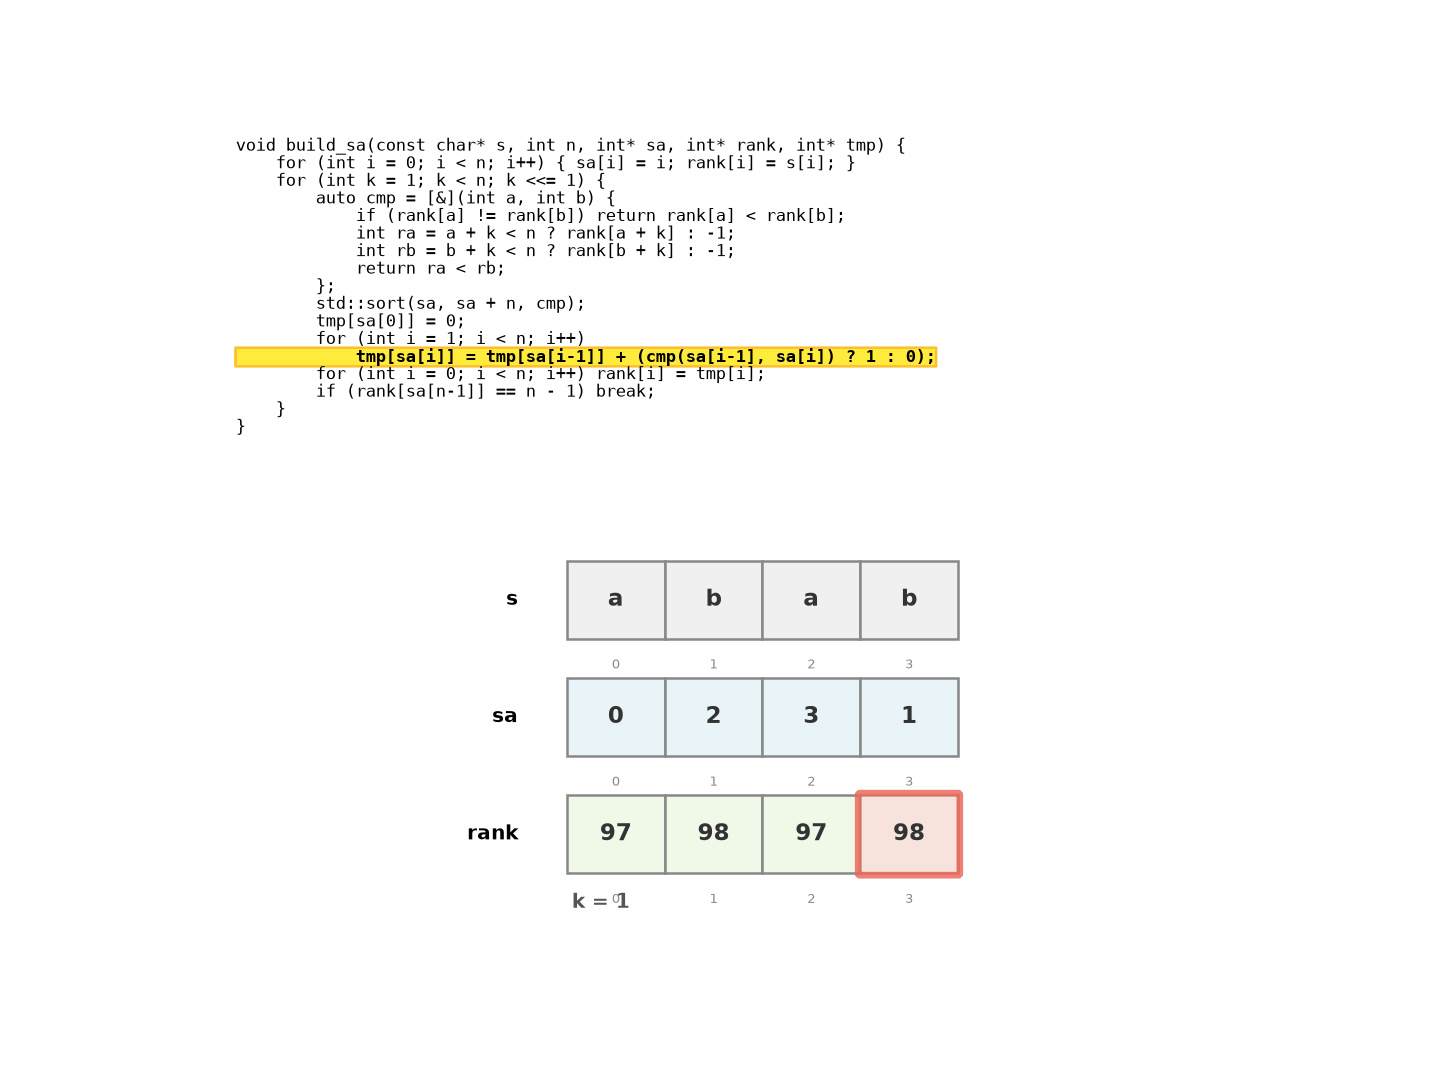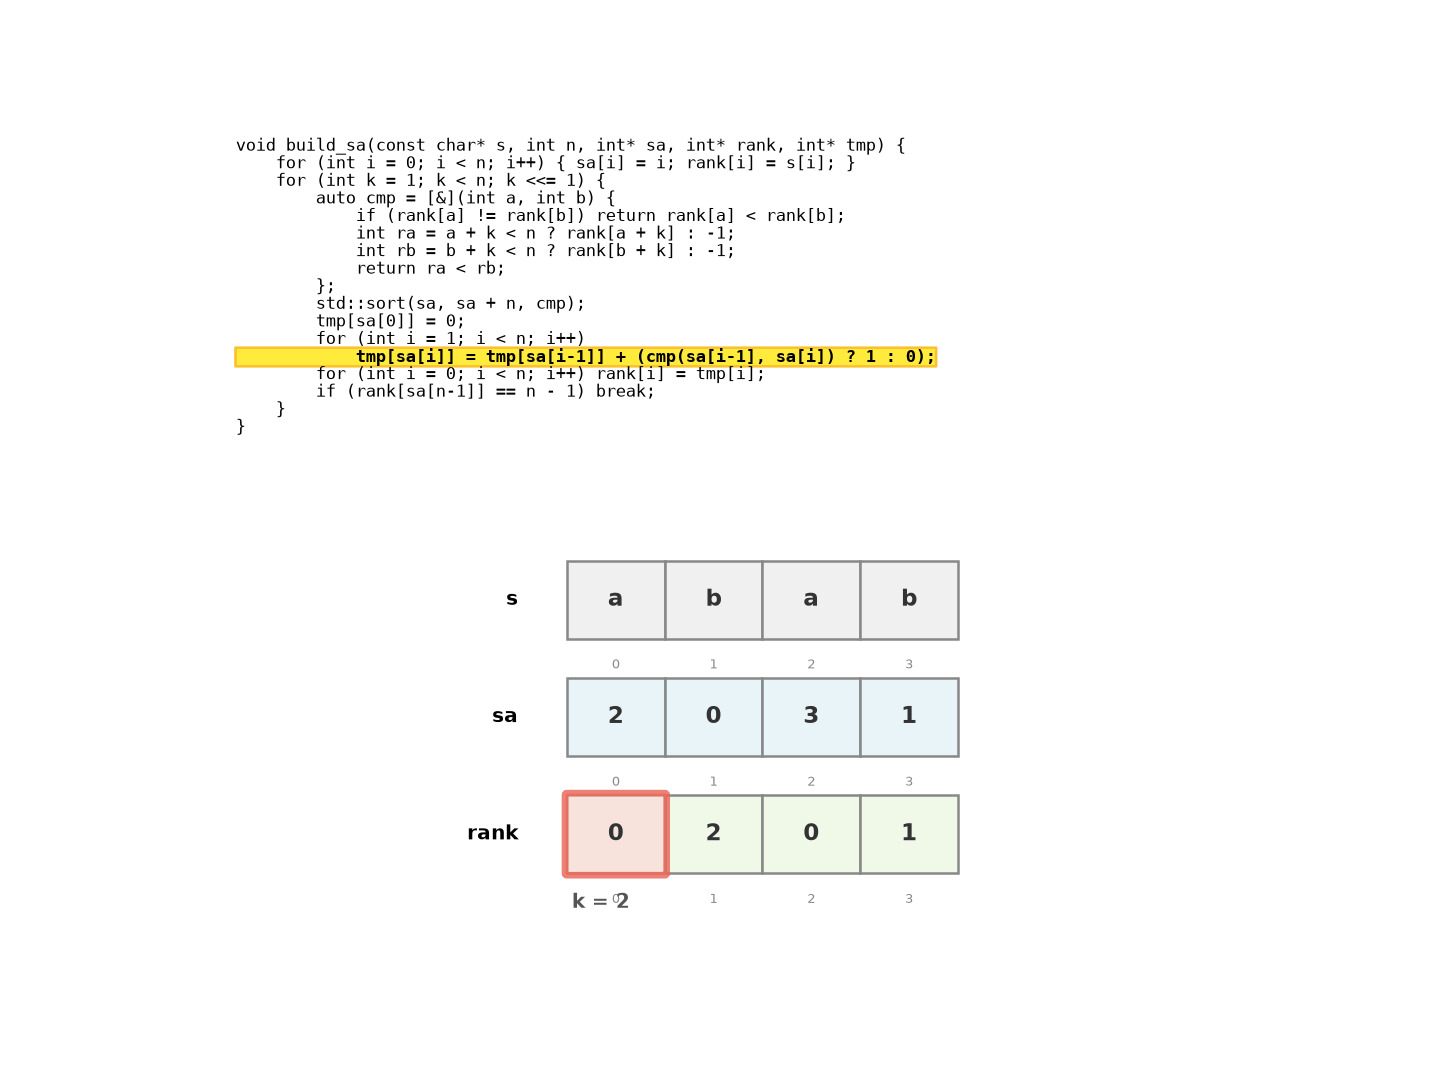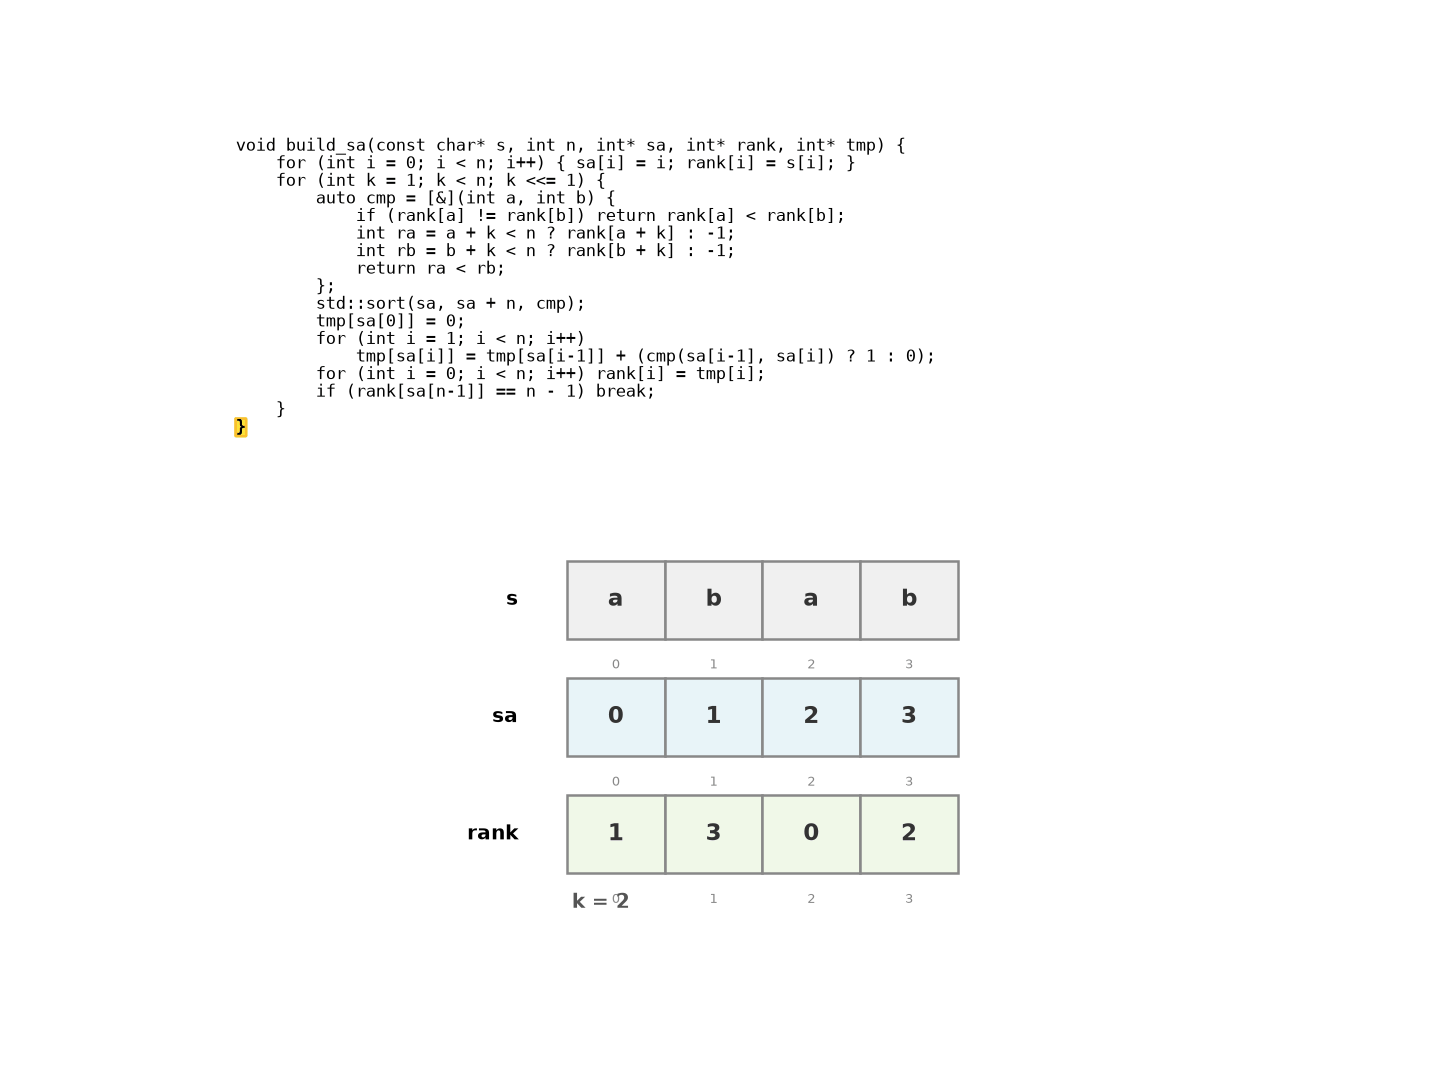
倍增的核心不变量:第 轮结束后,rank 数组精确反映”长度 前缀”的字典序排名。 轮中每轮 排序,总复杂度 ;若用基数排序可优化至 。
Kasai 算法构建 LCP 数组——利用 rank 的反向映射实现 线性扫描:
// Kasai 算法:由 sa[] 和 rank[] 构建 lcp[1..n-1]
// lcp[i] = sa[rank[i]] 与 sa[rank[i]-1] 的最长公共前缀长度
void build_lcp(const char* s, int n, const int* sa, const int* rank, int* lcp) {
    int k = 0;
    for (int i = 0; i < n; i++) {
        if (rank[i] == 0) { lcp[0] = 0; continue; }
        int j = sa[rank[i] - 1];           // 排名前一位的后缀
        while (i + k < n && j + k < n && s[i+k] == s[j+k]) k++;
        lcp[rank[i]] = k;
        if (k > 0) k--;                     // 关键:rank[i+1] 的 LCP 至少比 k 小 1
    }
}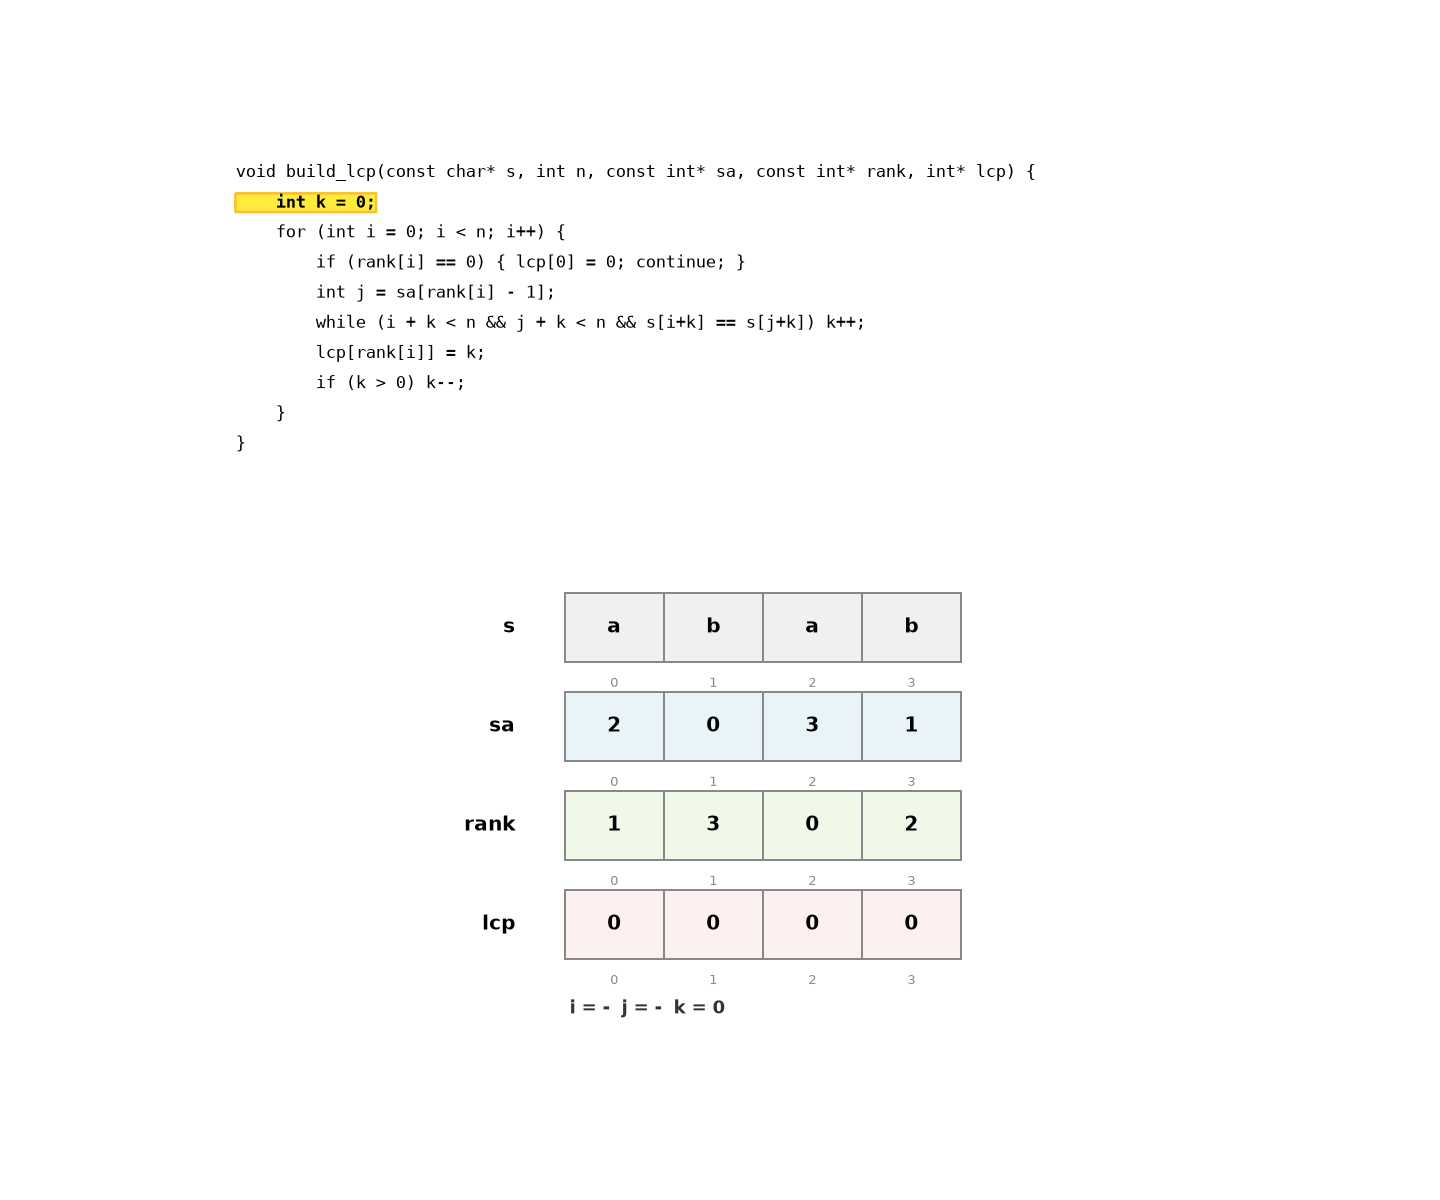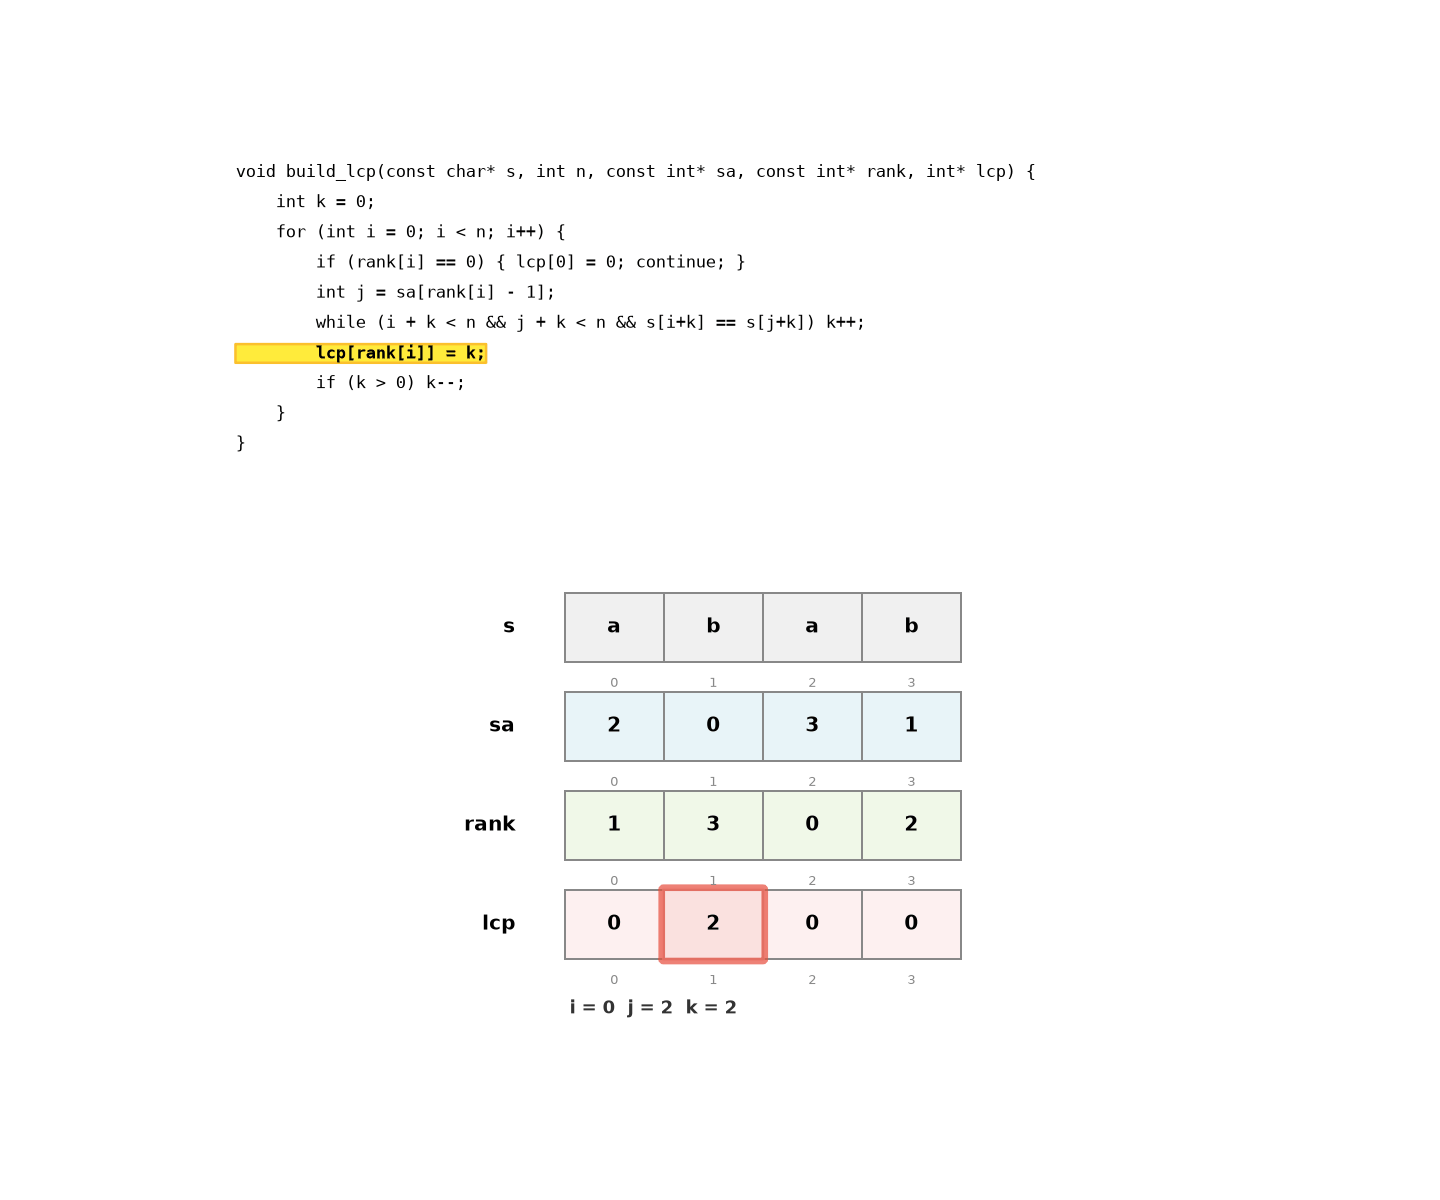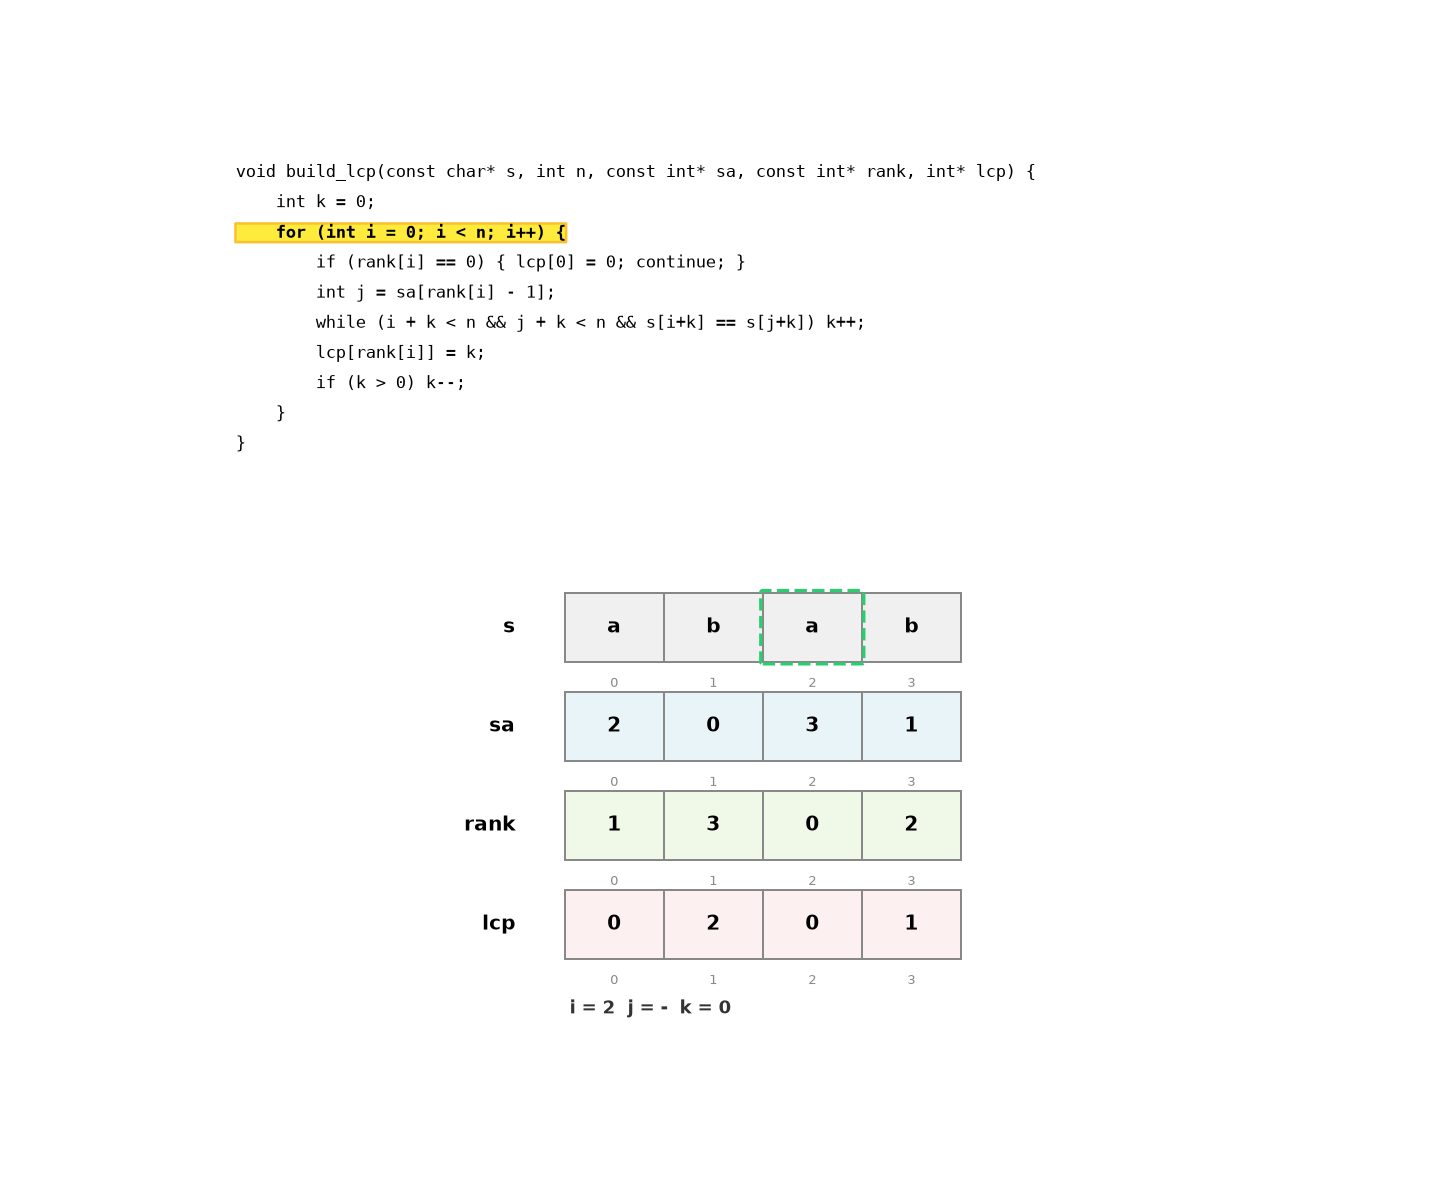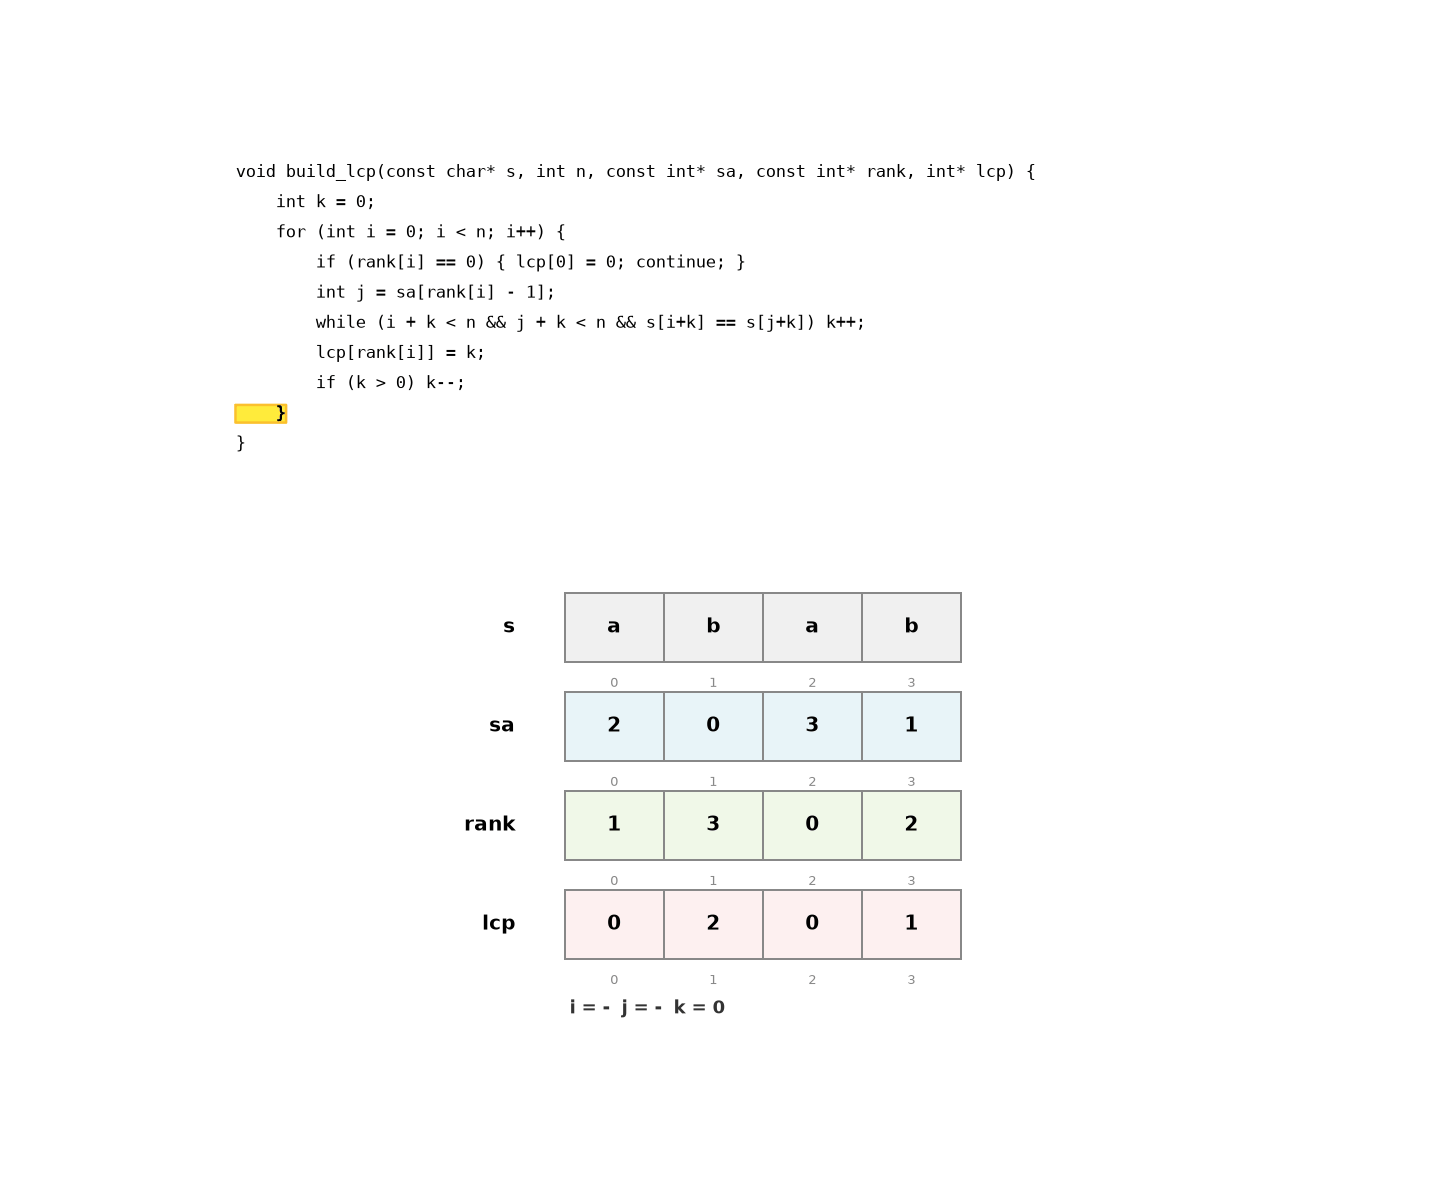
Kasai 的 秘密:rank[i+1] 对应的后缀比 rank[i] 对应的后缀在字符串中晚一位起始,因此它们的 LCP 至少比 rank[i] 的 LCP 少 1——k 只增不减地单调递减,总比较次数 。
SA 上的二分查找——将子串搜索转化为后缀数组上的范围二分:
// 在后缀数组中二分查找子串 P[0..m-1],返回首次出现位置(-1 表示不存在)
int sa_search(const char* s, int n, const int* sa, const char* P, int m) {
    int lo = 0, hi = n;                     // [lo, hi) 是候选后缀范围
    while (lo < hi) {
        int mid = (lo + hi) / 2;
        int cmp = memcmp(s + sa[mid], P, m < n - sa[mid] ? m : n - sa[mid]);
        if (cmp < 0) lo = mid + 1;
        else if (cmp > 0) hi = mid;
        else return sa[mid];                // 找到匹配
    }
    return -1;
}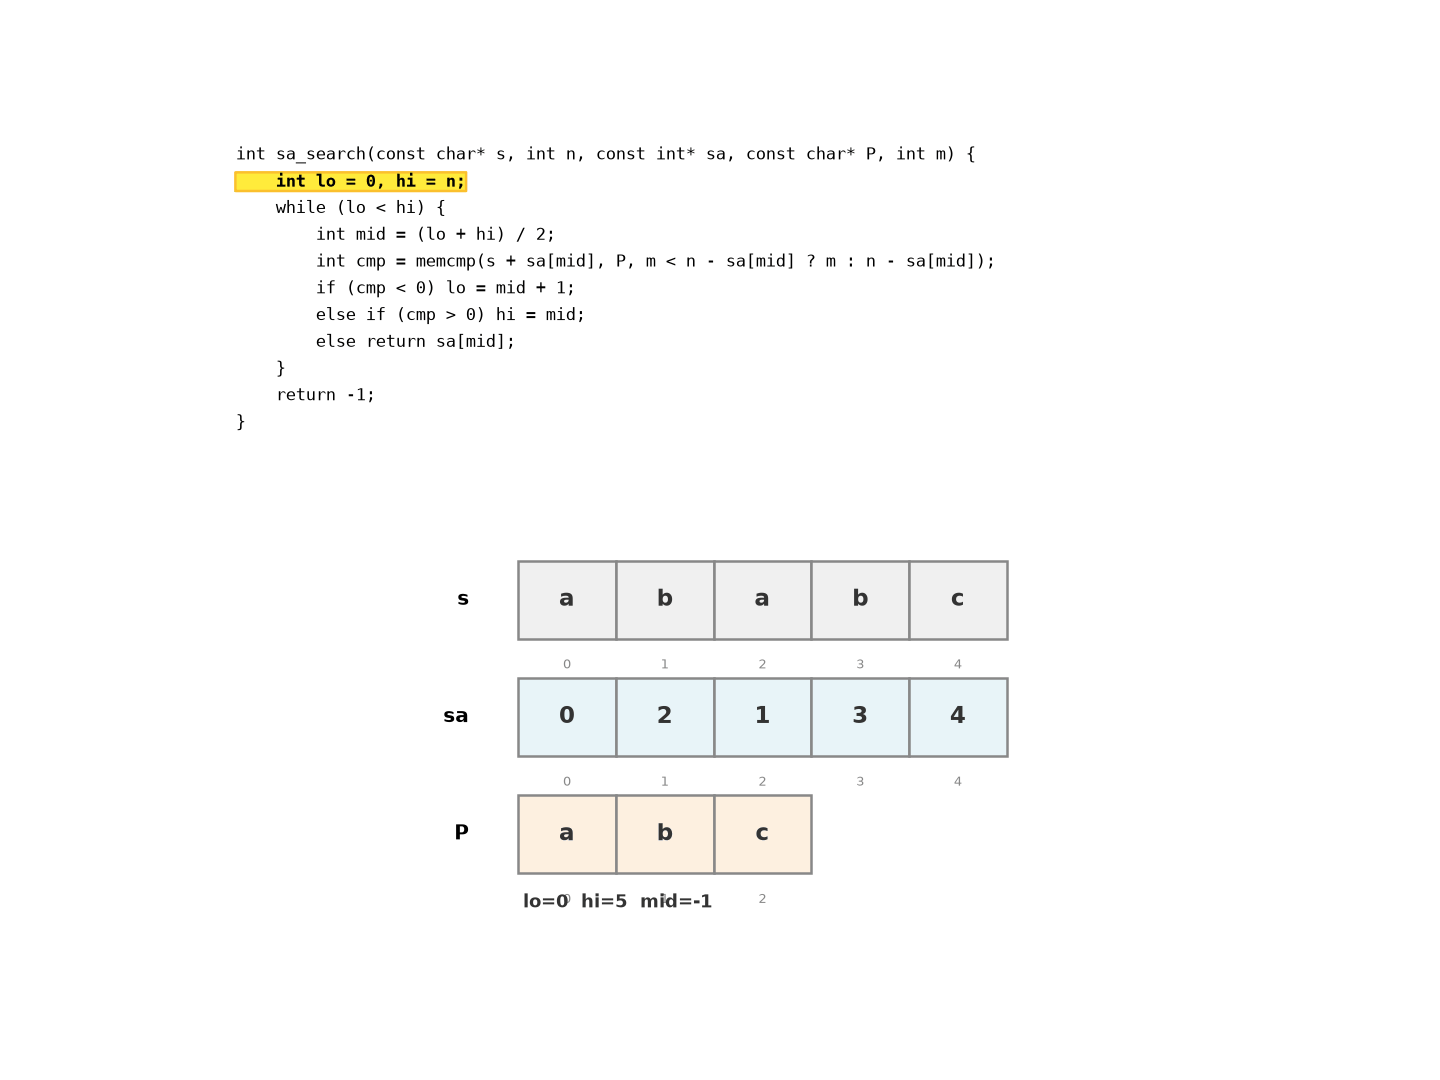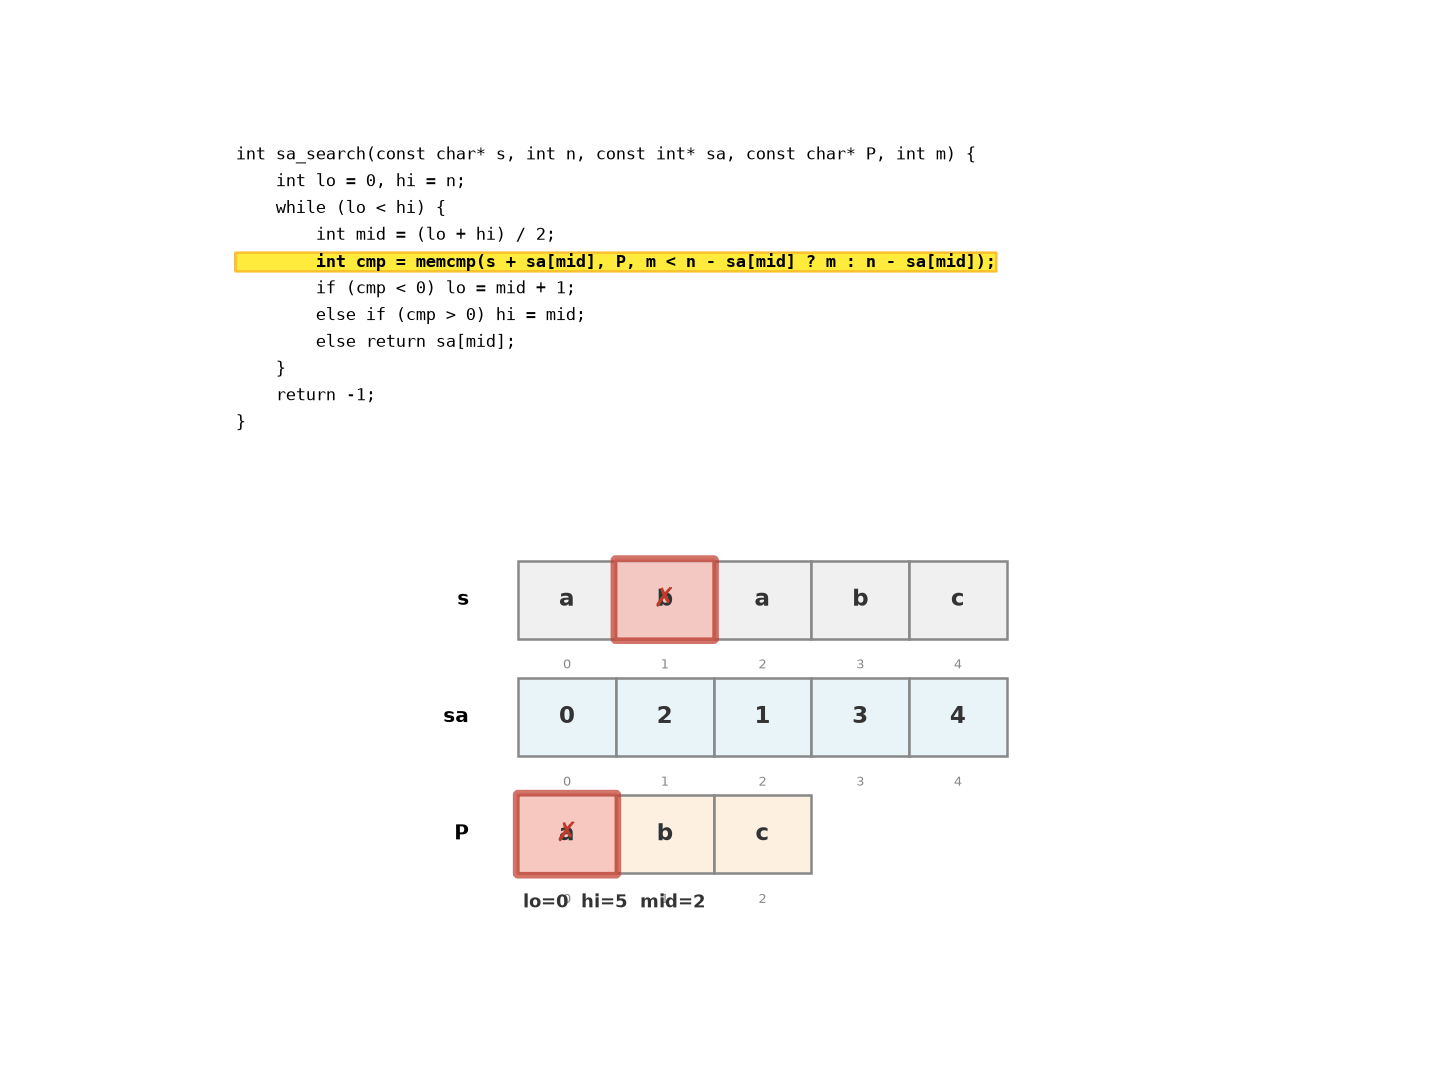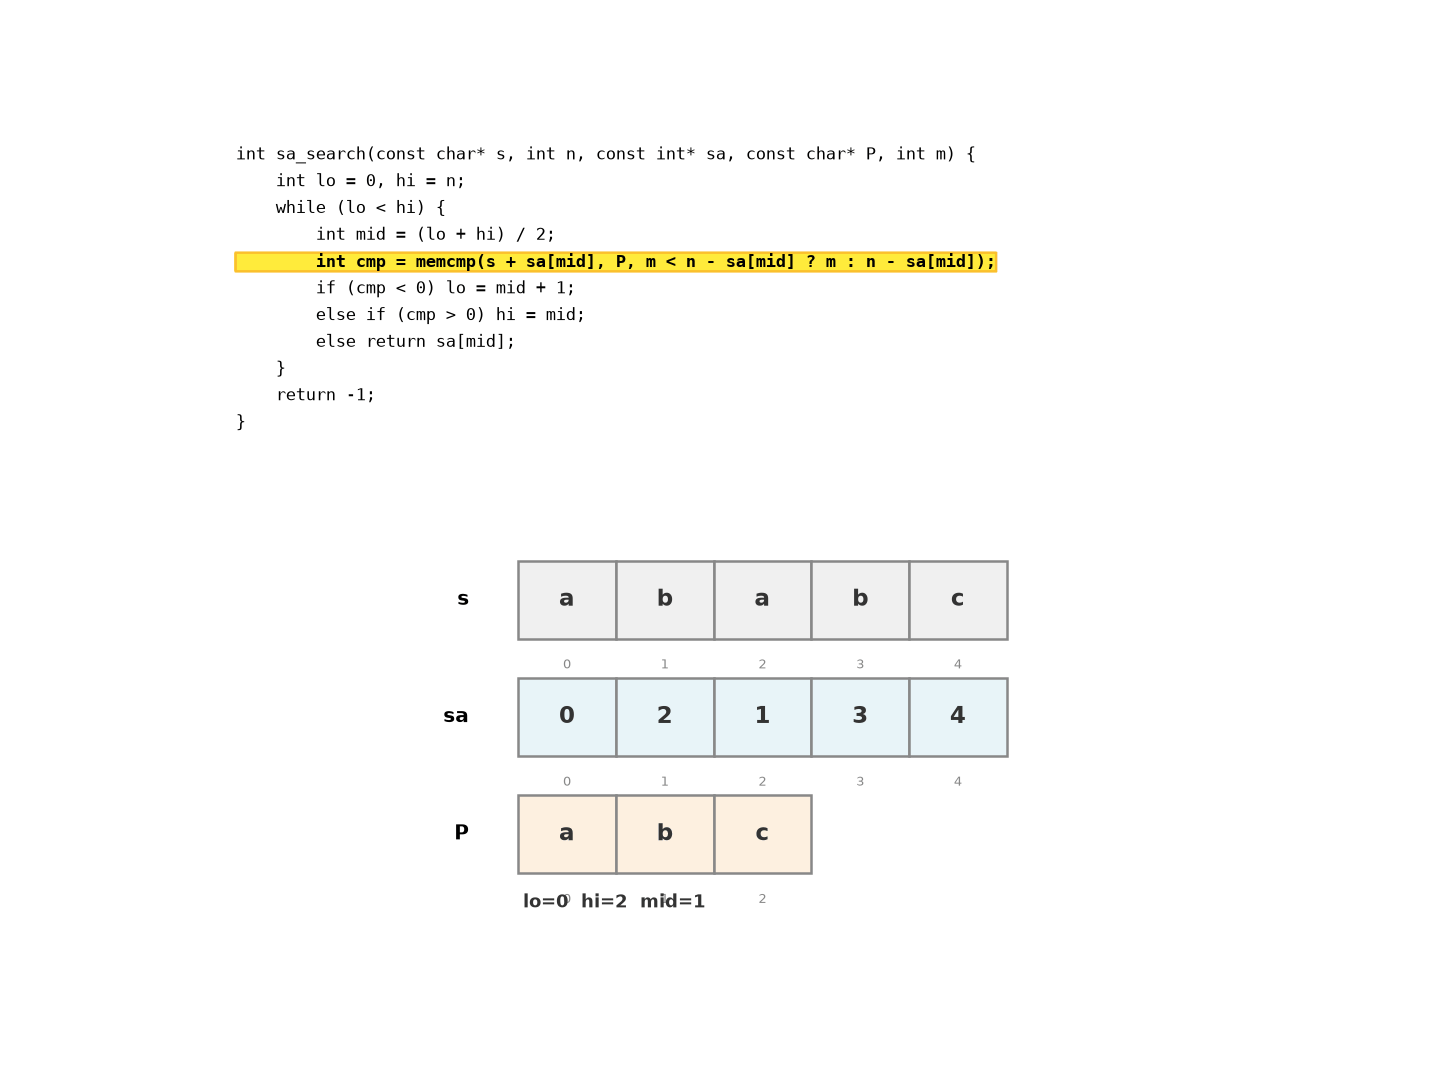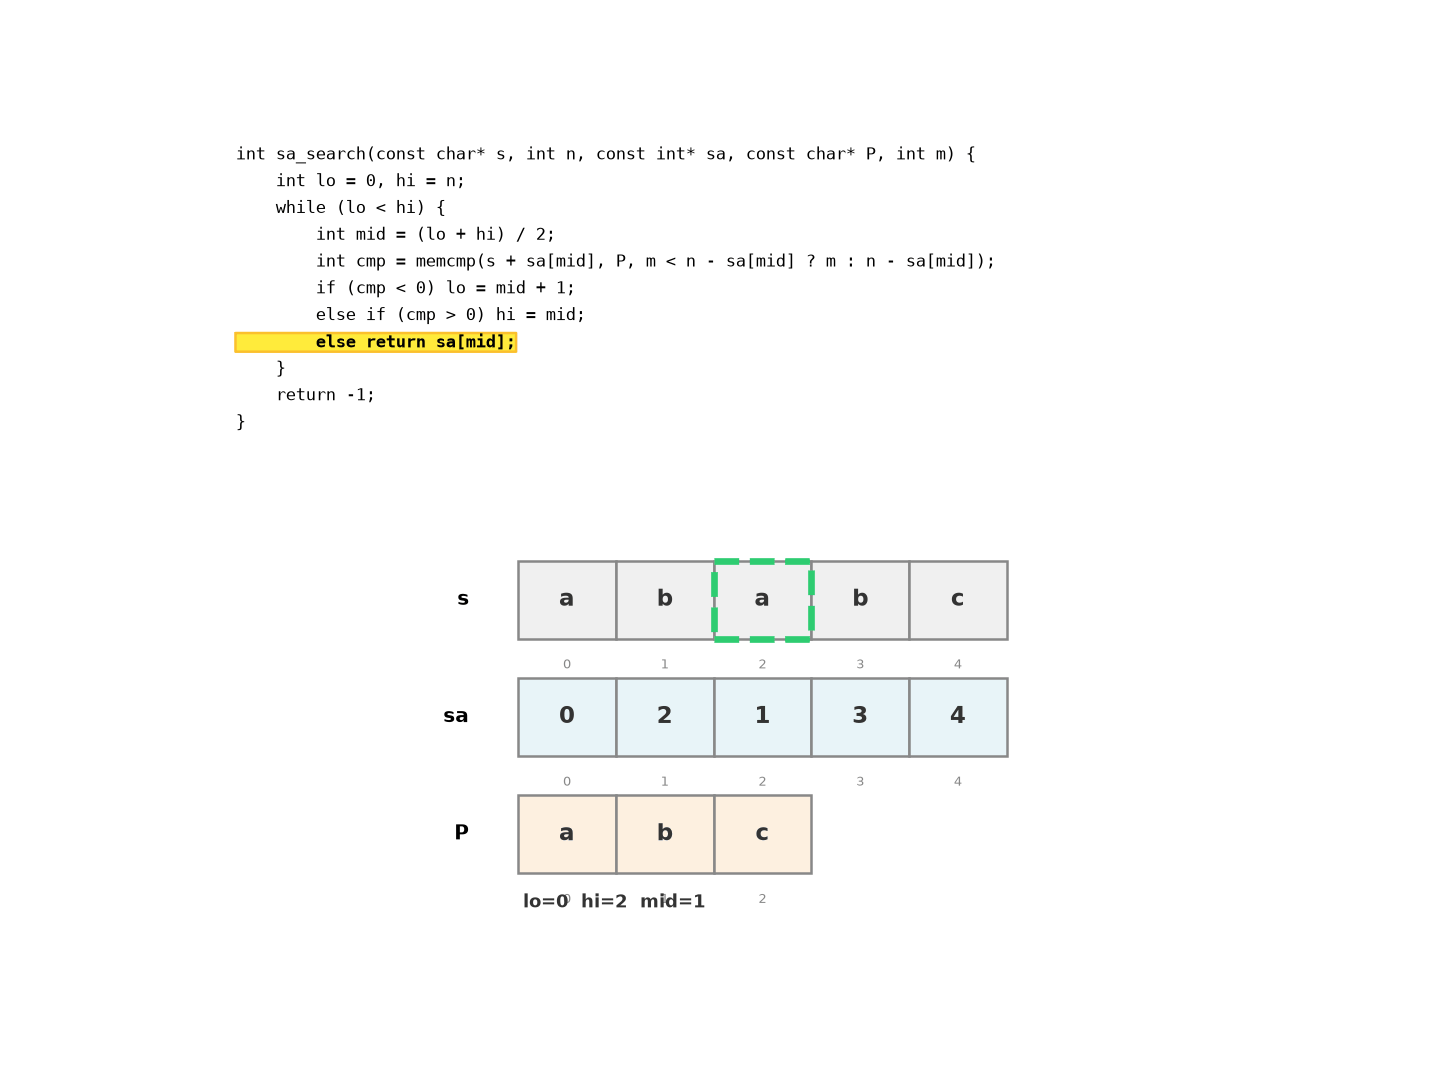
二分查找在有序后缀数组上执行 次比较,每次比较 ,总复杂度 。结合 LCP 数组还可优化为 (利用已知 LCP 跳过重复比较)。
深入底层
字符串匹配的缓存行为
上一章用整整一节讲了缓存的层级与访问模式(数组 — 缓存层级与访问模式),字符串作为 char 数组的特化,那些结论全部适用——而且能解释一个实践中常见的反常现象:理论复杂度更优的算法不一定更快。
三个匹配算法的访存模式完全不同:
BF——教科书级的缓存友好。 内层循环对 和 都是严格顺序访问,一条 64B 的 cache line 装 64 个 char,每 64 次比较只有 1 次 miss,L1 命中率约 98%;硬件预取器对步长为 1 的流式访问预测近乎完美。这就是 BF 在短模式串()的实际运行中经常不输 KMP 的原因——每次失配虽然浪费了已比对的工作量,但每次比对本身便宜得惊人(L1 命中约 4 周期 vs 一次 L2 约 12 周期、主存约 100 周期)。
KMP——文本顺序,π 表随机。 文本指针 只增不减、顺序扫过 ,这部分同样缓存友好;但失配时 j = pi[j-1] 是对 数组的随机跳转。 数组只有 个 int,通常整个装进 L1,实际开销可控;真正的隐藏成本是分支预测失败——T[i] == P[j] 与否高度不可预测,在流水线深度 15 左右的现代 CPU 上一次 mispredict 浪费 15-20 个周期,接近一次 L2 访问。KMP 相对 BF 省下的”重复比对”,有一部分被 mispredict 吃掉了。
BM——跳跃访问,赢在少摸内存。 坏字符规则的跳跃常常一次跨过若干 cache line,破坏预取器的等步长模型(预取器擅长连续流和固定 stride,不擅长随机大跳)。但 BM 的总触达字节数远小于前两者——平均只检查 量级的字符,摸过的 cache line 总数最少,这一优势压倒了跳跃本身的代价。
| BF | KMP | BM | |
|---|---|---|---|
| 文本访问模式 | 严格顺序 | 顺序 | 大跨度跳跃 |
| 每次比对的 cache 成本 | 极低(~1 miss / 64 次) | 极低 | 触达行数最少 |
| 额外访存 | 无 | 数组随机跳转 | 坏字符表查表(256 项常驻 L1) |
| 分支可预测性 | 高 | 低(mispredict 密集) | 中 |
| 实践定位 | 短模式串够用 | 保证最坏线性 | 长模式串 + 自然文本最快 |
结论:当 、 都不大时,缓存与分支预测把常数项拉平甚至反转,选 BF 完全合理;只有模式串长、文本量大时,BM/KMP 的渐近优势才能兑现实测收益。“换算法之前先看常数项”是性能工程的一般规律,字符串匹配是最典型的案例场。动手验证见本章实验 E4。
小字符串优化(SSO / Small String Optimization)
现代 C++ 的 std::string 实现(libstdc++ v5+、libc++、MSVC STL)都使用 SSO 避免短字符串的堆分配。以 libc++ 的实现为例:
graph TD
 subgraph "长模式: size > 15"
 LM["struct string {<br/> char* ptr —→ 堆上分配的字符串<br/> size_t size = 23<br/> size_t capacity = 32<br/>}<br/>sizeof = 24 字节<br/>堆上有额外的 32 字节"]
 end
 subgraph "短模式: size <= 15"
 SM["struct string {<br/> char* ptr —→ 指向自身内部的 local[16]<br/> size_t size = 8<br/> char local[16] = 'h','e','l','l','o','\0',...<br/>}<br/>sizeof = 24 字节<br/>无堆分配"]
 end
核心技巧是 union:capacity 字段和 local[16] 共享同一块内存。两者的长度恰好相同(8 字节的 size_t capacity 和 16 字节的 char local[16]),但 union 的实际大小取决于较大者——local[16] 占 16 字节。对于长模式,这 16 字节存 capacity;对于短模式,local[0..14] 存 15 个字符,local[15] 存 \0。字符串总大小 24 字节(64 位系统:指针 8 + size 8 + local/capacity 16 → 共 32,但编译器可能因对齐把 size 和 capacity 合并)。
SSO 的阈值 15 不是随意选择的——它精确权衡了 string 对象总大小(对齐到 32 字节,即 64 位系统的两个 cache line 的一半)和能容纳的最长 ASCII 短字符串(15 个字符覆盖了绝大多数 JSON key、配置项名称、字段名等场景)。
SSO 的性能影响:
- 堆分配消除:跳过
malloc/free约 50-200ns 的延迟 - Cache 局部性:字符串内容与字符串对象在同一 cache line 中,访问成本降低
- 复制加速:
std::string的拷贝在短模式下退化为memcpy32 字节
Null-Terminated 的安全隐患
以 \0 为 sentinel 的设计导致了 C 语言史上最严重的安全漏洞类别——缓冲区溢出(buffer overflow):
// 不安全的字符串拼接
char dst[10] = "hello";
char src[] = "world!!!";
strcat(dst, src); // dst 只能存 10 字节,但最终需要 12 字节
// 溢出覆盖了栈上的其他变量,可能重写返回地址

// 不安全的字符串拷贝
char buf[64];
gets(buf); // 不检查长度,输入 1000 个字符照样写入
// 攻击者可通过此覆盖返回地址,劫持程序控制流
这些问题在硬件层面被利用的机制:栈帧上变量从低地址向高地址排列,但返回地址在更高地址。当 strcpy 从目标缓冲区的低地址向高地址写并溢出时,它覆写了返回地址。攻击者精心构造输入使得返回地址指向恶意代码(shellcode)或 ROP 链。现代防御措施包括栈 canary(在返回地址前插入随机值,函数返回前检查是否被破坏)、W
安全使用 null-terminated 字符串的底线:
strncpy(dst, src, sizeof(dst) - 1); // 永远留一个字节放 \0
dst[sizeof(dst) - 1] = '\0'; // 确保 null-terminated

snprintf(dst, sizeof(dst), "%s", src); // snprintf 始终保证 \0
宽字符与 Unicode 的底层
字符串的”字符”在底层没有统一的长度。UTF-8 可变长度编码设计精妙,让 ASCII 成为 UTF-8 的真子集:
UTF-8 编码规则:
| Unicode 码点范围 | UTF-8 字节序列 | 说明 |
|---|---|---|
| U+0000 – U+007F | 0xxxxxxx | 1 字节,与 ASCII 完全兼容 |
| U+0080 – U+07FF | 110xxxxx 10xxxxxx | 2 字节,覆盖拉丁扩展、希腊、阿拉伯 |
| U+0800 – U+FFFF | 1110xxxx 10xxxxxx 10xxxxxx | 3 字节,CJK 汉字在此范围 |
| U+10000 – U+10FFFF | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx | 4 字节,emoji、罕见汉字 |
每个后续字节的 10 前缀保证了反向扫描时不会将多字节序列的中间字节误认为一个字符的开始——这是 UTF-8 的自同步(self-synchronizing)特性。即使从流中间开始解析,最多扫描 3 字节就能确定字符边界。
UTF-16 与代理对(Surrogate Pairs):
Java 和 Windows 内核使用 UTF-16,大多数字符占 2 字节。但对于 U+10000 以上的字符,UTF-16 用两个 16 位单元(代理对)表示。Java 的 String.length() 返回的是 UTF-16 单元数量而非真正的 Unicode 码点数量:
String s = ""; // U+1F602, 占用 2 个 UTF-16 单元
s.length(); // = 2, 不是 1
s.codePointCount(0, s.length()); // = 1, 这才是真正的码点数
这种”一个字符占多个 char 单元”的行为是 Java 字符串函数中出现偏移量错误的常见原因。在 C 语言环境,使用 wchar_t(Linux 和 macOS 上是 32 位 UTF-32,Windows 上是 16 位 UTF-16)的跨平台代码面临同样的不一致。
Copy-on-Write 字符串(历史教训)
C++98 时代的 libstdc++ 使用 COW(copy-on-write)实现 std::string。多个字符串对象可以共享同一块堆缓冲区,直到某个字符串尝试修改时才复制:
sequenceDiagram
 participant s1 as s1 = "hello"
 participant s2 as s2 = s1
 participant Buf as 共享缓冲区<br/>(refcount=2)

 s1->>Buf: 创建 "hello", refcount=1
 s2->>Buf: s2 = s1, refcount=2 (无数据拷贝)
 s1->>Buf: s1[0] = 'H' 触发 COW
 Buf->>Buf: 检测 refcount > 1
 Buf->>s1: 复制新缓冲区, refcount(new)=1
 Buf-->>s2: 旧缓冲区 refcount 降为 1
COW 在单线程下工作良好——当字符串拷贝频繁但修改稀少时,避免了大量不必要的堆分配。然而在多线程环境下,修改引用计数需要原子操作,每次拷贝(即使不修改)也需要原子地增加引用计数。在 C++11 引入移动语义后,COW 的性能优势被颠覆——std::string 可以”移动”而非复制,堆缓冲区所有权转移不需要引用计数。C++11 标准明确禁止了 COW 实现——std::string 上的 operator[] 不再允许共享缓冲区。
实现
KMP 前缀函数与匹配
#include <stdlib.h>
#include <string.h>

// 构建前缀函数 pi[0..m-1]
// pi[k] = P[0..k] 的最长相等真前后缀长度
void compute_pi(const char* P, int m, int* pi) {
 pi[0] = 0;
 int j = 0; // j = pi[k-1]
 for (int k = 1; k < m; k++) {
 while (j > 0 && P[k] != P[j])
 j = pi[j - 1]; // 递归回退:试次长 border
 if (P[k] == P[j])
 j++;
 pi[k] = j;
 }
}

// KMP 匹配:在 T 中找 P,返回匹配索引个数
int kmp_search(const char* T, int n, const char* P, int m, int* result) {
 int* pi = malloc(m * sizeof(int));
 compute_pi(P, m, pi);

 int count = 0, j = 0;
 for (int i = 0; i < n; i++) {
 while (j > 0 && T[i] != P[j])
 j = pi[j - 1];
 if (T[i] == P[j])
 j++;
 if (j == m) {
 result[count++] = i - m + 1;
 j = pi[j - 1]; // 继续搜索后继匹配
 }
 }
 free(pi);
 return count;
}

// KMP 计数:返回 P 在 T 中出现的次数
int kmp_count(const char* T, int n, const char* P, int m) {
 int* pi = malloc(m * sizeof(int));
 compute_pi(P, m, pi);
 int count = 0, j = 0;
 for (int i = 0; i < n; i++) {
 while (j > 0 && T[i] != P[j])
 j = pi[j - 1];
 if (T[i] == P[j])
 j++;
 if (j == m) {
 count++;
 j = pi[j - 1];
 }
 }
 free(pi);
 return count;
}

// 简单子串包含判断:返回 1 表示 P 出现在 T 中,0 表示未出现
int str_contains(const char* T, const char* P) {
 int n = strlen(T), m = strlen(P);
 if (m == 0) return 1;
 int* pi = malloc(m * sizeof(int));
 compute_pi(P, m, pi);
 int j = 0;
 for (int i = 0; i < n; i++) {
 while (j > 0 && T[i] != P[j])
 j = pi[j - 1];
 if (T[i] == P[j])
 j++;
 if (j == m) { free(pi); return 1; }
 }
 free(pi);
 return 0;
}
这段代码的核心在于 j 的双重身份——它既表示”已匹配的字符数”,又作为模式串中下一个待比较字符的下标。两个 while 嵌套看似 或 ,但均摊分析证明是线性的:j 在整个循环中至多被增加 n 次,每次回退至少减少 1,所以总体回退次数不超过总体增加次数。均摊思想的数学本质见 容器章节 — 均摊思想。
Boyer-Moore 坏字符规则(简版)
BM 的完整实现需要好后缀规则,但单靠坏字符规则已经展示了 BM 的核心思想——从右向左比对,利用失配字符的位置信息跳过大量字符:
#define ALPHABET 256

// 坏字符表:每个字符在模式串中最右出现的位置(-1 表示不出现)
void build_bad_char(const char* P, int m, int bc[ALPHABET]) {
 for (int i = 0; i < ALPHABET; i++) bc[i] = -1;
 for (int i = 0; i < m; i++) bc[(unsigned char)P[i]] = i;
}

int bm_search(const char* T, int n, const char* P, int m) {
 int bc[ALPHABET];
 build_bad_char(P, m, bc);

 int i = 0;
 while (i <= n - m) {
 int j = m - 1;
 while (j >= 0 && T[i + j] == P[j]) j--; // 从右向左比对
 if (j < 0) return i; // 完全匹配
 // 坏字符规则:将模式串右移,使失配字符对齐到它在 P 中最右的匹配位置
 int shift = j - bc[(unsigned char)T[i + j]];
 i += (shift > 0) ? shift : 1;
 }
 return -1;
}
在实际英文文本上,BM 的坏字符规则平均跳过 个字符——模式串越长,跳得越远。这个特性使得 BM 在搜索长模式串时远超 KMP。
Boyer-Moore 好后缀规则
上面的简版只用坏字符规则。完整 BM 还有第二把武器——好后缀规则(good suffix rule)。
场景:从右向左比对时,后缀 已经匹配成功(这段就叫”好后缀”),随后 失配。此时不要只盯着失配的那个坏字符,还要问:模式串里有没有别的位置能接上这段好后缀? 三条位移来源取最大:
- 模式串中另有一段与好后缀完全相同的片段 → 对齐它;
- 没有完整相同片段,但有模式串的前缀恰好等于好后缀的某个后缀 → 让该前缀顶上来;
- 都没有 → 整体滑过好后缀,移动 位。
// 好后缀表 gs[j]:失配在位置 j 时应右移的距离
void build_good_suffix(const char* P, int m, int* gs) {
    memset(gs, 0, m * sizeof(int));
    int* border = malloc((m + 1) * sizeof(int));   // 广义 border 辅助数组
    int i = m, j = m + 1;
    border[i] = j;
    while (i > 0) {                                // 步骤一:预处理广义 border
        while (j <= m && P[i-1] != P[j-1]) {
            if (gs[j] == 0) gs[j] = j - i;         // 情形 1/2 的位移
            j = border[j];
        }
        border[--i] = --j;
    }
    j = border[0];                                 // 步骤二:前缀兜底(情形 2)
    for (i = 0; i <= m; i++) {
        if (gs[i] == 0) gs[i] = j;
        if (i == j) j = border[j];
    }
    free(border);
}
匹配主循环改为 shift = max(坏字符位移, gs[j]),两者取大者。叠加好后缀规则后,BM 的最坏情况从 改善到 ,同时自然文本上的平均跳跃进一步提升——GNU grep 把 BM 选作默认引擎,靠的就是双规则叠加。
值得玩味的是:好后缀表的构建本质上又回到了 KMP 的 border 思想——“让模式串自己和自己做匹配”。两个看似相反的算法在最深处殊途同归。
Rabin-Karp 滚动哈希
Rabin-Karp 的核心:用滚动哈希把子串比较转化为整数比较,哈希匹配时再逐字符验证。
#define RK_BASE 256
#define RK_MOD  1000000007

// 计算 a^b mod RK_MOD
static long long rk_powmod(long long a, long long b) {
 long long res = 1;
 a %= RK_MOD;
 while (b > 0) {
 if (b & 1) res = res * a % RK_MOD;
 a = a * a % RK_MOD;
 b >>= 1;
 }
 return res;
}

// Rabin-Karp:返回匹配索引,未找到返回 -1
int rabin_karp(const char* T, int n, const char* P, int m) {
 if (m > n) return -1;
 long long h = rk_powmod(RK_BASE, m - 1);  // 最高位的权重
 long long p_hash = 0, t_hash = 0;

 // 计算模式串哈希和文本第一个窗口哈希
 for (int i = 0; i < m; i++) {
 p_hash = (p_hash * RK_BASE + P[i]) % RK_MOD;
 t_hash = (t_hash * RK_BASE + T[i]) % RK_MOD;
 }

 // 滑动窗口
 for (int i = 0; i <= n - m; i++) {
 if (p_hash == t_hash) {
 int j;
 for (j = 0; j < m; j++)
 if (T[i + j] != P[j]) break;
 if (j == m) return i;  // 哈希匹配且字符验证通过
 }
 // 滚动更新:移除 T[i],加入 T[i+m]
 if (i < n - m) {
 t_hash = (t_hash - T[i] * h % RK_MOD + RK_MOD) % RK_MOD;
 t_hash = (t_hash * RK_BASE + T[i + m]) % RK_MOD;
 }
 }
 return -1;
}
Sunday 算法(完整部分)
Sunday 是 BM 的简化版——失配时看对齐位置后面的下一个字符(即 ),查偏移表决定跳跃距离。
#define SUNDAY_ALPHABET 256

// 构建 Sunday 偏移表:每个字符在模式串中最右出现位置到串尾的距离+1
void build_sunday_shift(const char* P, int m, int shift[SUNDAY_ALPHABET]) {
 for (int i = 0; i < SUNDAY_ALPHABET; i++) shift[i] = m + 1;
 for (int i = 0; i < m; i++) shift[(unsigned char)P[i]] = m - i;
}

int sunday_search(const char* T, int n, const char* P, int m) {
 int shift[SUNDAY_ALPHABET];
 build_sunday_shift(P, m, shift);

 int i = 0;
 while (i <= n - m) {
 int j = 0;
 while (j < m && T[i + j] == P[j]) j++;
 if (j == m) return i;
 // 看对齐位置后的下一个字符,决定跳多远
 i += shift[(unsigned char)T[i + m]];
 }
 return -1;
}
后缀数组完整模块
#include <stdlib.h>
#include <string.h>

typedef struct {
    int* sa;            // 后缀数组:sa[k] = 排名第 k 的后缀起始下标
    int* rank;          // rank[i] = 起始位置 i 的后缀排名
    int* lcp;           // lcp[k] = sa[k] 与 sa[k-1] 的最长公共前缀长度
    int n;
} SuffixArray;

// 辅助:交换两个整数
static void swap_int(int* a, int* b) { int t = *a; *a = *b; *b = t; }

// 基数排序辅助:按第二关键字排序后,再按第一关键字计数排序
static void radix_sort(int* sa, int* rank, int* tmp, int n, int k) {
    int cnt[256] = {0};
    for (int i = 0; i < n; i++)
        cnt[(rank[i + k < n ? rank[i + k] : 0] + 1) & 255]++;
    for (int i = 1; i < 256; i++) cnt[i] += cnt[i-1];
    for (int i = n - 1; i >= 0; i--)
        tmp[--cnt[(rank[sa[i] + k < n ? rank[sa[i] + k] : 0] + 1) & 255]] = sa[i];
    memset(cnt, 0, sizeof(cnt));
    for (int i = 0; i < n; i++) cnt[rank[tmp[i]] + 1]++;
    for (int i = 1; i < 256; i++) cnt[i] += cnt[i-1];
    for (int i = n - 1; i >= 0; i--)
        sa[--cnt[rank[tmp[i]] + 1]] = tmp[i];
}

// 构建后缀数组(倍增法 + 基数排序,O(n log n))
SuffixArray* sa_build(const char* s) {
    int n = (int)strlen(s);
    SuffixArray* sa_data = malloc(sizeof(SuffixArray));
    sa_data->n = n;
    sa_data->sa   = malloc(n * sizeof(int));
    sa_data->rank = malloc(n * sizeof(int));
    sa_data->lcp  = malloc(n * sizeof(int));
    int* tmp = malloc(n * sizeof(int));

    // 初始:按单字符排序
    for (int i = 0; i < n; i++) {
        sa_data->sa[i] = i;
        sa_data->rank[i] = s[i];
    }
    for (int gap = 1; gap < n; gap <<= 1) {
        // 基数排序:先按第二关键字,再按第一关键字
        radix_sort(sa_data->sa, sa_data->rank, tmp, n, gap);
        radix_sort(sa_data->sa, sa_data->rank, tmp, n, 0);
        // 重新编号排名
        tmp[sa_data->sa[0]] = 0;
        for (int i = 1; i < n; i++) {
            int eq = sa_data->rank[sa_data->sa[i]] == sa_data->rank[sa_data->sa[i-1]]
                  && sa_data->rank[sa_data->sa[i]+gap] == sa_data->rank[sa_data->sa[i-1]+gap];
            tmp[sa_data->sa[i]] = tmp[sa_data->sa[i-1]] + (eq ? 0 : 1);
        }
        for (int i = 0; i < n; i++) sa_data->rank[i] = tmp[i];
        if (tmp[sa_data->sa[n-1]] == n - 1) break;
    }

    // Kasai 算法构建 LCP 数组
    int k = 0;
    sa_data->lcp[0] = 0;
    for (int i = 0; i < n; i++) {
        if (sa_data->rank[i] == 0) { k = 0; continue; }
        int j = sa_data->sa[sa_data->rank[i] - 1];
        while (i + k < n && j + k < n && s[i+k] == s[j+k]) k++;
        sa_data->lcp[sa_data->rank[i]] = k;
        if (k > 0) k--;
    }

    free(tmp);
    return sa_data;
}

// 子串查找:在后缀数组中二分查找 P,返回首次出现下标(-1 表示不存在)
int sa_search(const SuffixArray* sa, const char* s, const char* P) {
    int m = (int)strlen(P), n = sa->n;
    int lo = 0, hi = n;
    while (lo < hi) {
        int mid = (lo + hi) / 2;
        int cmp = memcmp(s + sa->sa[mid], P, (m < n - sa->sa[mid] ? m : n - sa->sa[mid]));
        if (cmp < 0) lo = mid + 1;
        else if (cmp > 0) hi = mid;
        else return sa->sa[mid];
    }
    return -1;
}

// 最长重复子串:取 lcp 数组的最大值
int sa_longest_repeated(const SuffixArray* sa) {
    int best = 0, best_pos = 0;
    for (int i = 1; i < sa->n; i++) {
        if (sa->lcp[i] > best) {
            best = sa->lcp[i];
            best_pos = sa->sa[i];
        }
    }
    return best_pos;    // 调用方用 s[best_pos .. best_pos+best-1] 取子串
}

// 释放后缀数组
void sa_destroy(SuffixArray* sa) {
    if (!sa) return;
    free(sa->sa);
    free(sa->rank);
    free(sa->lcp);
    free(sa);
}
各语言标准库对比
| 语言 | 字符串类型 | 底层表示 | 可变 | SSO | 说明 |
|---|---|---|---|---|---|
| C | char* / char[] | null-terminated | 是 | — | 无内置字符串类型 |
| C++ | std::string | 长度+容量+SSO | 是 | 15 字符 | libstdc++/libc++ 均启用 |
| Java | String | UTF-16, 不可变 | 否 | — | StringBuilder 用于拼接 |
| Python | str | 不可变, 长度记录 | 否 | — | 内部用柔性数组表示 |
| Rust | &str / String | 胖指针 / 堆分配 | String 可 | — | &str 是借用,无分配 |
| Go | string / []byte | 胖指针(长度前缀) | string 否 | — | strings.Builder 可变构建 |
应用场景
- 编译器前端:词法分析器(lexer)使用有限自动机——KMP 的 DFA 视角——逐个字符识别 token
- 入侵检测系统:Snort/Suricata 规则引擎使用 Aho-Corasick(KMP 的多模式扩展)同时匹配数千条攻击特征
- 数据库:B+Tree 的键比较、LIKE 模式匹配、全文检索的倒排索引都依赖高效的字符串操作
- 数据压缩:LZ77/LZ78 家族用滑动窗口找”前面出现过的字符串”——本质上是 BM/KMP 的匹配逻辑在可变长度模式上的推广
- 文本编辑器:查找/替换功能使用 BM(GNU grep 的核心算法),正则表达式引擎使用 Thompson NFA 或回溯匹配
练习
| 题号 | 题目 | 难度 | 知识点 |
|---|---|---|---|
| 28 | 找出字符串中第一个匹配项的下标 | 入门 | KMP / BF / BM |
| 14 | 最长公共前缀 | 入门 | 前缀比较 |
| 459 | 重复的子字符串 | 入门 | 前缀函数的周期性应用 |
| 151 | 反转字符串中的单词 | 中等 | 原地修改 |
| 72 | 编辑距离 | 中等 | 字符串 DP(滚动数组优化) |
| 1143 | 最长公共子序列 | 中等 | 字符串 DP |
| 1044 | 最长重复子串 | 困难 | 后缀数组 / 二分+滚动哈希 |
动手实验
| 编号 | 题目 | 说明 |
|---|---|---|
| E1 | KMP vs BF vs BM 实测 | 对随机英文文本(取自维基百科 dump)和不同长度模式串(m=6,12,24,48),分别用 BF、KMP、BM 搜索 1000 次,绘制耗时-m 曲线。BM 在长模式串下应该显著快于 KMP |
| E2 | 小字符串优化 (SSO) 观察 | 使用 C++ std::string 对长度 1,8,15,16,64 的字符串各创建 10000 个。用 valgrind --tool=massif 观察堆分配总量变化——15 及以下应无堆分配 |
| E3 | 前缀函数与周期性 | 随机生成 100 组模式串,计算前缀函数。验证命题:若 且 ,则该串由周期子串重复构成。打印验证通过率 |
| E4 | 匹配算法的缓存行为实测 | 在 100MB 英文文本(维基百科 dump)上分别用 BF、KMP、BM 搜索一批真实单词,用 perf stat -e cache-misses,branch-misses 统计三个指标:总耗时、cache-miss、branch-misses。验证本章”深入底层”节的论断——BF 的 miss 率最低但总耗时未必最低,BM 触达的 cache line 最少;再用 m=4 与 m=32 两组模式串对比,观察常数项优势随 m 增大的消失 |