数组 (Array)
建议先阅读:无。数组是所有数据结构的基础逻辑基石,也是计算机硬件唯一直接理解的数据组织方式——CPU 只认识”基地址 + 偏移”。
本章定位:数组是顺序存储的载体,以数组实现的线性表称为顺序表。线性表 ADT、顺序表插入/删除的平均移动次数推导与 408 算法设计题见 线性表与顺序表。
原理
为什么数组是起点
在计算机科学中,“数据结构的本质是内存布局”。数组之所以成为第一课,是因为它对应硬件最直接的抽象:一段连续的内存,通过基地址 + 偏移量寻址。链表、树、哈希表等所有其它数据结构,最终都是在此基础上施加额外的指针管理或算法逻辑。
从 CPU 的视角看,数组不是”数据结构”,而是”一段地址”。arr[i] 在 x86-64 汇编层被翻译为一条 mov eax, [rdi + rsi*4],其中 rdi 存基地址,rsi 存下标 i,乘数 4 是 sizeof(int)。整个访存过程在一条指令内部完成地址计算和加载。
; C: int x = arr[3];
; 假设 arr -> rdi, 3 -> rsi
mov eax, DWORD PTR [rdi + rsi*4] ; 基址 + 偏移*元素字节数
内存模型与寻址公式
数组在内存中占据一段连续地址空间。对于元素类型为 T 的数组,第 i 个元素的地址是:
其中 base 是 arr[0] 的地址(即数组首地址)。
这个公式由 CPU 核心在执行指令时完成——编译器会把 arr[i] 编译成带”基址 + 变址×比例”寻址模式的指令(如 x86 的 lea),一步算出地址,不需要额外的内存访问——这是 O(1) 随机访问的硬件基础。(MMU 只负责后续的虚拟地址→物理地址转换,不参与这个计算。)
此处仅作了解
简单解释:计算数组 arr 的第 i 个元素的地址,就是用首地址 base 加上 i × sizeof(T)。i 是相对首元素的下标偏移(从 0 开始,即”第 0 个、第 1 个……第 i 个”),sizeof(T) 是数组单个元素所占的字节数(位宽)。
常见的类型位宽(C语言展示,这里有显示问题Bool其实是_Bool):
- sizeof(int) = 4
- sizeof(char) = 1
- sizeof(_Bool) = 1
- sizeof(long long) = 8
- sizeof(指针) = 4 或 8(取决于 32 位还是 64 位系统)
- c++里的sizeof(string)通常与编译器相关,一般是32字节,C语言没有string类型
所以整个寻址公式就是:
一维数组第 i 个元素所占的地址 = 首地址 + i × 该数组数据类型的位宽
int arr[5] = {10, 20, 30, 40, 50};
int x = arr[3]; // 等价于 *(arr + 3)
int y = 3[arr]; // C 语言允许的古怪写法,等价于 *(3 + arr)
arr[3] 和 3[arr] 在 C 标准中完全等价,因为 a[b] 被定义为 *(a + b),加法交换律使得两者计算结果相同。编译后生成的汇编指令毫无区别。这揭示了 C 语言的一个核心事实:数组下标在语义层面就是指针算术的语法糖。
graph LR
 subgraph "物理内存 (地址递增 →)"
 A0["arr[0]<br/>addr=0x1000"] --- A1["arr[1]<br/>addr=0x1004"] --- A2["arr[2]<br/>addr=0x1008"] --- A3["arr[3]<br/>addr=0x100C"] --- A4["arr[4]<br/>addr=0x1010"]
 end
 subgraph "寻址过程"
 BASE["base = 0x1000"] --> MUL["i × sizeof(int) = 3 × 4 = 12"]
 MUL --> ADD["base + 12 = 0x100C"]
 ADD --> RESULT["加载 0x100C 处的值 = 40"]
 end
静态数组 vs 动态数组
数组的生命周期和存储位置取决于其声明方式。这个区别不仅影响语法,更决定性能特征和安全边界。
| 静态数组 | 动态数组 | |
|---|---|---|
| 大小 | 编译期常量,不可变 | 运行时可变 |
| 内存来源 | 栈或全局数据段(.data/.bss) | 堆(通过 malloc/realloc) |
| 生命周期 | 随作用域结束自动销毁 | 需手动 free,或由 GC 处理 |
| 分配成本 | ~0(仅移动栈指针 rsp) | malloc 需遍历空闲链表 / 切割 chunk |
| 扩容成本 | 不支持 | O(n) 数据拷贝,且旧内存需释放 |
| 大小上限 | 受栈大小限制(Linux 默认 8MB) | 受虚拟地址空间限制(64 位下约 2^47 字节) |
栈与堆:为什么静态数组大小有上限
操作系统在进程创建时为栈分配固定大小的虚拟地址空间(Linux 默认 8MB,ulimit -s 查看)。主线程栈地址通常在用户空间的高地址端,向下增长。每次函数调用将栈指针(rsp)下移,为局部变量腾出空间。
graph TD
 subgraph "进程虚拟地址空间 (Linux x86-64)"
 STACK["栈 (Stack)<br/>默认 8MB<br/>高地址 → 低地址增长"]
 GAP1["⬇ 随机偏移 (ASLR)<br/>约 128MB 间隙"]
 MMAP["mmap 区域<br/>动态库 / 大块 malloc"]
 HEAP["堆 (Heap)<br/>sbrk 增长<br/>低地址 → 高地址增长"]
 GAP2["⬆"]
 BSS[".bss 段<br/>未初始化全局变量"]
 DATA[".data 段<br/>已初始化全局变量"]
 TEXT[".text 段<br/>代码 / 只读数据"]
 end
 STACK --> GAP1 --> MMAP --> HEAP --> GAP2 --> BSS --> DATA --> TEXT
静态数组声明在栈上时,若数组大小超过栈剩余空间,会触发栈溢出(stack overflow),在 Linux 下通常表现为段错误(SIGSEGV)。编译器无法完全检测这种运行时越界——这就是为什么大数组必须在堆上分配。
动态数组通过 malloc 从堆获取内存。堆的虚拟地址空间远大于栈(受 vm.max_map_count 和地址空间上限限制,而非 8MB),因此动态数组可以分配数 GB。但是 malloc 并不只是”给一块内存”:
- 小块内存(< 128KB,实际阈值由 glibc 的
mmap_threshold控制):malloc从预先向 OS 申请的堆段(通过sbrk系统调用扩展数据段边界)中切割一块空闲 chunk。chunk 之间有元数据(大小、标记位),free 时合并相邻空闲 chunk - 大块内存(≥ 128KB):
malloc直接调用mmap向内核申请一块全新的虚拟地址区域(anonymous mapping),free 时通过munmap归还内核
- malloc是C的标准函数,源自标准库<stdlib.h>,用法: void* malloc(size_t size);
- 返回一个通用指针,最终指针类型取决于所需,比如 num= (int * )malloc(size_t size);这里malloc返回的指针就是指向int类型的。这里num可以作为动态数组,内存空间在堆上分配
- size_t size表示要分配的字节数,通常由程序员自己定义,比如malloc(sizeof(int))分配一个int大小的堆上连续内存空间。
- 成功返回的指向首地址的指针,失败返回NULL
- malloc分配的内存空间不会被初始化,其中的值是随机的
动态数组扩容的核心机制在 容器章节 有完整的均摊数学分析,本章 深入底层 一节从聚合方法和势能法两个角度给出了严格证明。
多维数组的内存布局
对于形状为 的 维数组,内存始终是一维的。将多维下标映射到一维偏移量的策略决定了遍历时的缓存行为。
行优先(Row-Major)
C、C++、Python(NumPy)、Go 使用行优先。最右侧下标变化最快——同一行在内存中连续存放。
对于 的二维数组:
在这里解释一下计算机的数组维度概念
在线性代数中,m×n = m 行 n 列,每行 n 个数,共 m 行
计算机(C 语言为例)中,二维数组 arr[m ][n]的含义按层划分:第一维有 m 个元素,每个元素是一个长度为 n 的一维数组(即”m 行,每行 n 个数据”),和线代的 m×n 约定一致。内存中按行优先连续存放:第 0 行的 n 个元素、接着第 1 行的 n 个元素……
注意*在计算机中,第一计数标记为0
下面用图形来举例:
0行 O O O O …O <- n个
1行 O O O O …O
2行 O O O O …O
.
.
m行 O O O O …O
addr(i,j)在这里所代表的位置是第i行,第j列
接下来的位数就要看其占多少个O(从左往右数,从上往下数)
很显然,这个位置加上前面的一共有n x i +j个O
推广到 维,各维大小为 :
乘积 称为维度 的步幅(stride),表示下标 每增加 1,在内存中跨越的元素个数。
实例:一个 的三维数组,访问 arr[1][2][3]:
编译器在编译时就将各维的 stride 乘积计算为常量,运行时只需一条乘加指令(imul + add)即可完成地址计算。
从第一性原理推导寻址公式
上面的公式并非凭空给出,而是从连续内存的定义出发严格推导的。
定义:一维数组 T arr[n] 在内存中占据一段连续的 n × sizeof(T) 字节。元素 arr[0] 位于基地址 base,arr[1] 位于 base + sizeof(T),以此类推。这是 C 标准(§6.5.6)的直接要求——数组元素按序排列,地址严格递增。
引理:一维数组 arr[i] 的地址 = base + i × sizeof(T)。
证明:对 做数学归纳。当 时,,成立。假设对 成立,即 。由于数组连续存放,。由归纳法,对所有 成立。
定理(二维行优先寻址公式):对于 的二维数组 T arr[m][n](行优先存储),元素 arr[i][j] 的地址为:
证明:二维数组 arr[m][n] 在内存中被解释为”m 个一维数组,每个长度为 n”——即 arr 是长度为 m 的数组,其每个元素 arr[i] 是长度为 n 的一维数组。根据 C 标准(§6.5.2.1),arr[i] 等价于 *(arr + i),即从 arr 起始地址偏移 个”长度为 n 的一维数组”。
由引理,每个一维数组占用 字节,因此:
再对 arr[i][j] 应用引理(arr[i] 是一维数组,下标为 ):
定理(二维列优先寻址公式):对于 的二维数组(列优先存储),arr[i][j] 的地址为:
证明:列优先的内存解释相反——数组被视为”n 个一维数组,每个长度为 m”,即 arr[j] 是第 列(长度为 的一维数组)。因此:
步幅(stride)的物理含义:公式中 的系数 和 的系数 (行优先)或 和 (列优先),分别表示该维度每增 1 时跨越的元素个数。行优先下, 每增 1 跳过完整一行( 个元素), 每增 1 只跳 1 个元素;列优先正好相反。步幅决定了遍历时的缓存行为——步幅越小的维度放内层循环,cache 命中率越高。
推广到 维:对于形状为 的 维数组(最右侧维度变化最快),元素 的步幅为:
即维度 的步幅等于其右侧所有维度大小的乘积。这可以归纳证明:假设 维以上的步幅已正确,则 每增 1,需要跳过 个元素,即 。这是一个递推关系,从最内层 出发逐步展开即可得到乘积公式。
列优先(Column-Major)
Fortran、MATLAB、R 使用列优先。最左侧下标变化最快——同一列在内存中连续存放。
对于 的二维数组:
在行优先中,是先从左往右数,再从上往下数,而在列优先中,则是先从上往下数,再从左往右数,判断位置也是先看列,再看行。
行优先(C/C++、Python) 好处:
- 遍历整行快:for(i) for(j) a[i][j] 时按内存顺序访问,充分利用 CPU 缓存局部性(连续元素在缓存行里,一次载入多个),性能远高于跳着访问。
- 与”数组的数组”实现天然契合:C 的多维数组就是嵌套定义,行优先是自然结果;a[i] 退化为行指针,切片/取行操作是连续内存,便宜。
- Fortran 等科学计算库调用:若你的数据最终要传给按列优先存的库(如某些 BLAS/LAPACK 变体),需要转置,这是缺点而非好处。
列优先(Fortran、MATLAB、R) 好处: - 遍历整列快:for(j) for(i) a[i][j] 按内存顺序访问,同样吃缓存局部性——适合以列为基本运算单位的问题(线性代数中列向量运算、矩阵乘法按列分块)。
- 数学/数值计算惯例:线代教材中矩阵常用列表示(列空间、列主元消去),Fortran 面向数值计算而生,列优先让矩阵操作(如按列取向量)无复制开销。
- 与某些硬件/库对齐:BLAS/LAPACK 原生就是列优先,用 Fortran 写可直接零拷贝对接。
graph TD
 subgraph "行优先 (C/C++)"
 direction LR
 RM0["[0,0]"] --> RM1["[0,1]"] --> RM2["[0,2]"] --> RM3["[0,3]"]
 RM3 --> RM4["[1,0]"] --> RM5["[1,1]"] --> RM6["[1,2]"] --> RM7["[1,3]"]
 end
 subgraph "列优先 (Fortran/MATLAB)"
 direction LR
 CM0["[0,0]"] --> CM1["[1,0]"] --> CM2["[2,0]"] --> CM3["[0,1]"]
 CM3 --> CM4["[1,1]"] --> CM5["[2,1]"] --> CM6["[0,2]"] --> CM7["[2,3]"]
 end
C 语言中的多维数组:真正的二维 vs 指针数组
这是 C 语言中最容易误解的概念之一。以下两种写法在语法上都能写成 arr[i][j],但内存布局截然不同:
// 方式 1:真正的连续二维数组(栈上分配,编译时确定列数)
int arr1[3][4]; // 一块连续的 3×4×4 = 48 字节内存

// 方式 2:指针数组模拟的二维数组(堆上分配)
int** arr2 = malloc(3 * sizeof(int*));
for (int i = 0; i < 3; i++)
 arr2[i] = malloc(4 * sizeof(int));
graph TD subgraph "int arr[3][4] — 连续内存" direction LR C0["[0,0]"] --- C1["[0,1]"] --- C2["[0,2]"] --- C3["[0,3]"] C3 --- C4["[1,0]"] --- C5["[1,1]"] --- C6["[1,2]"] --- C7["[1,3]"] C7 --- C8["[2,0]"] --- C9["[2,1]"] --- C10["[2,2]"] --- C11["[2,3]"] end subgraph "int** arr2 — 指针数组,各行散列" PTR["arr2[0] →"] --> R0["row0: [0,0] [0,1] [0,2] [0,3]"] PTR2["arr2[1] →"] --> R1["row1: [1,0] [1,1] [1,2] [1,3]<br/>(可能在完全不同的堆地址)"] PTR3["arr2[2] →"] --> R2["row2: [2,0] [2,1] [2,2] [2,3]"] end
连续二维数组的性能优势:
- 内存局部性:一整块连续内存,一次 cache miss 拉入一整条 cache line,后续同行的元素全命中
- 无额外指针开销:没有存储行指针的数组,也没有每次访问的间接跳转
- 分配简单:一条
malloc(rows * cols * sizeof(T)),释放一条free
指针数组的场景:
- 当各行的长度不同时(锯齿数组 / jagged array),指针数组不可避免
- 当需要交换行时,指针数组可以直接交换两个指针(O(1)),而连续数组需要 O(cols) 的数据复制
- 但每次
arr2[i][j]需要两次内存访问:一次读arr2[i]获取行指针,一次读*(arr2[i]+j)获取值。如果arr2本身被逐出缓存,第一次访问就是 cache miss
数组作为抽象数据类型(ADT)
内存视角之外,还有接口视角。数据结构课上,数组首先是一个 ADT——一组命名操作的集合,与它如何落进内存无关:
| 操作 | 典型名字(C++ / Python / Java) | 语义 | 成本 |
|---|---|---|---|
| 读 | v[i] / lst[i] / get(i) | 取第 i 个元素 | |
| 写 | v[i] = x / lst[i] = x / set(i,x) | 覆盖第 i 个元素 | |
| 尾插 | push_back / append / add | 末尾追加(动态数组才有) | 均摊 |
| 尾删 | pop_back / pop / remove(size-1) | 删除末尾元素 | |
| 中插 | insert(begin()+i, x) / insert(i, x) / add(i, x) | 插到位置 i,后续整体后移 | |
| 中删 | erase(begin()+i) / pop(i) / remove(i) | 删位置 i,后续整体前移 | |
| 长度 | size / len / size | 当前元素个数 |
三列名字一一对应——C++ vector、Python list、Java ArrayList 本质上是同一个 ADT 的三种方言,实现差异在 容器章节 展开。
这张表里最重要的事实是读写 与中插删 的不对称。它不是某个实现的缺点,而是连续内存的物理必然:要保持”基地址+偏移”寻址,元素就必须连着放;要插删,就得搬移其后全部元素。本章后续的一切——动态数组扩容、缓存友好、乃至下面的经典算法节——都是围绕这对矛盾展开的工程回应。
时间复杂度
| 操作 | 静态数组 | 动态数组(末尾) | 动态数组(中间) |
|---|---|---|---|
| 随机访问 | |||
| 更新 | |||
| 线性扫描 | |||
| 尾部插入 | 不支持 | 均摊 | — |
| 中间插入 | 不支持 | — | |
| 删除 | 不支持 |
压缩矩阵存储:寻址公式的直接变体
当矩阵本身带有结构(对称、三角、带状)时,可以把 个元素压进一维数组存 个——而压缩后”矩阵坐标 → 一维下标 “的映射,正是本节开头寻址公式的逆向运用。
对称矩阵
阶对称矩阵满足 ,只需存下三角(含对角线)的 个元素。按行优先存入 :
公式的来历就是数数:第 行之前共有 个元素,再加上行内偏移 。以 为例的布局:
| k | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 存放 |
验证:()→ ,与上表一致;(上三角)→ 取对称元 → ,同样吻合。
// 下三角行优先压缩:访问 a[i][j](1-indexed)等价于读 sa[k]
int sym_index(int i, int j) {
    if (i < j) { int t = i; i = j; j = t; }   // 上三角取对称元
    return i * (i - 1) / 2 + j;
}
三角矩阵
主对角线一侧为常数 (其余随机)的矩阵:下三角部分照搬对称矩阵的公式,再追加一个单元存放 :
与对称矩阵的唯一区别:上三角元素不再映射到对称位置,而是全部共享末尾那一个常量槽——因为它们值都相同,没必要各存一份。
三对角(带状)矩阵
只有主对角线及其上下两条斜线非零(),非零元共 个。按条带逐行压入 ,映射公式:
验证:,,,,……恰好是”每行 3 个、第一行只有 2 个”的紧凑排布。推导思路仍是数数:前 行共 个(第一行少一个),加行内偏移化简即得。
与稀疏矩阵的分界
以上三种是”结构规律已知、公式可直接写出”的压缩。当非零元位置完全无规律时(零元占绝大多数),改用三元组顺序表或十字链表记录”(行,列,值)“,见 稀疏矩阵章节。
深入底层
动态数组扩容的均摊分析
动态数组(std::vector / ArrayList)尾插的均摊 不是直觉——它有一个严格的数学证明。
问题模型:初始容量为 1 的动态数组,执行 次 push_back。每次空间不足时,分配 2 倍大小的新数组,将旧元素全部复制过去。
关键观察:扩容只在容量为 ()时发生,每次扩容复制的元素数分别为 个。
均摊分析(聚合方法 / Aggregate Method):
次插入的总复制次数为等比级数:
这是因为 ,所以 。
加上 次常数写入,总代价为 。因此均摊每次插入:
更精细的计算:设 (),总复制次数为:
总操作成本 = 次写入 + 次复制 = 。均摊每次操作的实际代价 。
势能法(Potential Method)证明:
定义势能函数 ,其中 是第 次操作后的状态。
- 非扩容操作(size 未触及 cap):实际代价 = 1, 增加 2(size +1,cap 不变),均摊代价 = 。
- 扩容操作(cap 翻倍):实际代价 = (复制旧元素 + 写入新元素),扩容后 不变而 翻倍, 减少 。均摊代价 = 。
每次操作的均摊代价 ,与 无关,即均摊 。
为什么是 2 倍而非其他倍数? 倍增因子 的选择影响均摊常数:
- 扩容为 倍时,均摊代价 = (复制成本分摊到后续 次插入中)
- 时,均摊代价 =
- 时,均摊代价 = ,但内存利用率更高(最多浪费 33% 空间)
- Java
ArrayList用 ,std::vector用
是复制次数和空间浪费的最优折中:均摊常数最小,同时空间浪费不超过 50%。
缓存层级与访问模式
CPU 缓存是理解数组性能的关键。现代 CPU 使用多级缓存架构:
| 层级 | 大小 | 延迟 | 关联度 | 位置 |
|---|---|---|---|---|
| L1d (数据缓存) | 32KB / 核心 | ~1ns (4-5 周期) | 8 路组相联 | 每核心私有 |
| L2 | 256KB-1MB / 核心 | ~4ns (12 周期) | 4-16 路 | 每核心私有 |
| L3 (LLC) | 8-32MB / 芯片 | ~12ns (40 周期) | 16 路 | 所有核心共享 |
| 主存 (DRAM) | 8-64GB | ~100ns | — | 通过内存控制器 |
先介绍一下一些基本的名词和基本单位:
寄存器,容量几百字节,延迟低于1周期,CPU直接读取计算,是存取的最基本单位。
cache line(缓存行),这个是计算机缓存机制的基本单位之一。
set(缓存组) 由缓存行组成,way(路数) 表示一个set可以存储多少个cache line
Cache(缓存) 由以上的东西组成,它属于SRAM(静态随机存取存储器) ,它和内存(DRAM) 最本质的区别在于它使用触发器,而内存使用电容。因此Cache相对于内存更快。Cache在计算机体存取体系中作为核心的中转站,就是因为它的快。
Cache有L1 L2 L3,分别对用一级缓存,二级缓存,三级缓存,容量依次增大,速度依次减慢。上面的表格可以看到。L1和L2核心独享,L3和内存核心共享。
简单介绍一下L123的主要功能,L1的功能就是是为了填满CPU,让CPU处于持续工作态,当L1没命中时会调用L2。L3常作为数据共享枢纽,计算完存储在L3,后续调用在这里。
cache miss(缓存未命中) 当CPU在L123里面没有找到数据的时候,会去内存甚至硬盘里面找,一次cache miss将会浪费巨大时间,代价巨大,理想情况,如果少一次cache miss,L1将会多工作100次。
cache miss在一下三种情况会发生,且无法避免:
1.强制缺失:数据第一次访问,缓存还没有发生,必须去内存加载
2. 容量缺失:缓存装不下数据(数据总大小大于Cache缓存总大小),数据被排去其他地方。
3.冲突缺失:缓存明明有空位(其他组是空的),但因为硬件映射规则(组索引),多个数据非要挤在同一个组里,导致该组满员而互相踩踏。
层级看待:
寄存器 -> Cache -> 内存 容量依次增大,延迟依次增加。
CPU 不是按字节而是以 cache line(64 字节)为单位与主存交互。一次 cache miss 会导致整条 cache line 从主存加载到缓存层级中。
接下来说说关于数据读取的换算和计算的问题
比如一个Cache Line块是64个字节,按照int占4字节来算,那么一个Cache Line可以存储64/4=16个int元素,同理,longlong占8字节,那么一个Cache Line可以存储64/8=8个longlong元素。
Cache总大小换算,比如L1总大小是32KB=32 x 1024=32768字节。
组数=总大小/(块大小X路数),上面例子计算就是 组数=32768/(64x 8)=64组 (L1一般8路)
组索引位数=log2(64)=6,同时,块内偏移也是6位
缓存命中分析(理想 LRU 模型):
遍历第一行时,加载 Line,全部 Miss(强制性缺失)。
当遍历第二行时,新的 Line 会覆盖(驱逐)第一行的 Line。
Cache 总共只有 512 个 Line(依据硬件来看,一般是512),如果数组远大于 Cache。
因为是顺序访问,且步长(1个int)远小于一个Line,所以每读入 16 个 int(一个cache line占有的int数),只有第一个 int 发生 Miss,后 15 个都在 Line 内命中。
因此*总 Miss = 总元素数 / 一个cacheline占有多少个元素
行优先遍历 vs 列优先遍历
对于 的二维 int 数组(每个 int = 4 字节),一条 cache line 容纳 个连续 int:
行优先遍历(循环外 i,内 j)—— 内存访问顺序与存储顺序一致:
for (int i = 0; i < m; i++)
 for (int j = 0; j < n; j++)
 sum += arr[i][j]; // 连续的 16 次访问几乎在一条 cache line 内
每 16 次访问中约 1 次 cache miss,其余 15 次命中。L1 命中率 。
列优先遍历(循环外 j,内 i)—— 内存访问与存储顺序垂直:
for (int j = 0; j < n; j++)
 for (int i = 0; i < m; i++)
 sum += arr[i][j]; // arr[i][j] 与 arr[i+1][j] 相距 n × 4 字节
相邻两次访问相距 字节。若 ,间距为 4000 字节(62.5 条 cache line)。每次访问几乎一定是 cache miss。
graph TD
 subgraph "行优先遍历 — 缓存友好"
 R1["读 arr[0][0] → miss<br/>加载 cache line (arr[0][0..15])"] --> R2["读 arr[0][1] → HIT"]
 R2 --> R3["读 arr[0][2] → HIT"]
 R3 --> R4["...连续 13 次全 HIT..."]
 R4 --> R5["读 arr[0][16] → miss<br/>加载下一条 cache line"]
 end
 subgraph "列优先遍历 — 缓存不友好"
 C1["读 arr[0][0] → miss<br/>加载 cache line (arr[0][0..15])"] --> C2["读 arr[1][0] → miss<br/>间距 n×4B,belongs to 另一条 cache line"]
 C2 --> C3["读 arr[2][0] → miss"]
 C3 --> C4["读 arr[3][0] → miss<br/>每条 cache line 只被访问了一个 4B 元素"]
 end
实验数据参考( 的 int 数组,即约 400MB):
| 遍历方式 | 时间 | L1 命中率 | 总 cache miss |
|---|---|---|---|
| 行优先 | ~0.04s | 93% | ~2.5M |
| 列优先 | ~0.8s | 0% | ~100M |
差距约 20 倍。这不是”算法”的差距——两种写法都是 O(n²) 访问所有元素——差距完全是硬件缓存行为造成的。
跨步访问(Strided Access)
不是所有”连续扫描”都享受完美的缓存行为。考虑以下遍历模式:
// stride = 1: 访问 arr[0], arr[1], arr[2], ...
for (int i = 0; i < N; i++) sum += a[i];

// stride = 16: 访问 arr[0], arr[16], arr[32], ...
for (int i = 0; i < N; i += 16) sum += a[i];

// stride = 64: 访问 arr[0], arr[64], arr[128], ...
// 如果数组元素是 int (4B), stride 64 意味着 256 字节步长
// 每次访问都在不同的 cache line 上!
for (int i = 0; i < N; i += 64) sum += a[i];
当 stride 增大时,每次访问落入不同 cache line 的概率增大。当 stride × sizeof(T) > cache line 大小时,每次访问都是 miss。更隐蔽的是 缓存抖动(cache thrashing):在组相联缓存中,如果 stride 恰好使得访问地址落入同一组的不同行,会导致频繁的逐出和重新加载。
缓存命中率的数学模型
顺序访问模型:对于长度为 的一维数组,顺序遍历(步长 )时,每条 cache line( 字节)容纳 个元素。首次访问该 line 时发生一次 miss,后续 次访问全部命中。因此:
对于 int(4 字节)、64 字节 cache line:,即命中率 ——与上表实验数据吻合。
随机访问模型:当访问位置完全随机时,每次访问独立地落在 cache 中 个 cache line 的某一条上。若数组占用 条 cache line(),且 (数组远大于 cache),则每次访问命中 cache 的概率为 ,miss rate 为:
即几乎每次访问都是 miss。这就是为什么随机遍历比顺序遍历慢数十倍。
跨步访问模型:步长为 时,每 次访问命中一条 cache line(向下取整)。因此:
当 时,miss rate = 100%。
二维数组行/列优先对比模型:对于 的 int 数组(4 字节),cache line = 64 字节(16 个 int):
| 遍历方式 | 步长(元素数) | 步长(字节) | miss rate | 理论加速比 |
|---|---|---|---|---|
| 行优先 行优先 | 1 | 4 | 6.25% | 1× |
| 行优先 列优先 | — |
当 时,列优先步长 字节 字节,miss rate 。行优先 miss rate = 6.25%。性能比 ,与实验数据的 20 倍量级一致(差异来自 L2/L3 缓存的缓冲效应)。
多级缓存下的等效延迟模型:设 L1 hit rate = ,L2 hit rate = ,L3 hit rate = ,各层延迟为 (主存):
行优先遍历时 , ns。
列优先遍历时 , ns。
加速比 (仅 L1-L3,不含主存带宽瓶颈的额外惩罚)。
数组退化(Array Decay)
在 C 语言中,数组名在大多数上下文中退化(decay)为指向其第一个元素的指针。这是 C 语言设计中最常导致 bug 的特性之一。
int arr[10];

// sizeof 是少数不退化的场景之一
sizeof(arr); // 40 (= 10 × 4),数组总字节数
&arr; // int(*)[10],指向整个数组的指针

// 大多数场景下 arr 退化为 int*
int* p = arr; // 退化:arr → &arr[0]
sizeof(p); // 8 (64位系统上指针大小),长度信息丢失

// 函数传参时必然退化
void foo(int arr[10]) {
 // arr 在这里是 int*,不是 int[10]
 sizeof(arr); // 8,不是 40!长度信息完全丢失
}退化导致的安全隐患:
// 典型的缓冲区溢出 —— 函数内无法获知数组大小
void read_data(int* buf) {
 // buf 的大小是多少?函数签名没有提供信息
 // 只能依赖调用者传入的 size 参数
 // 如果没有 size 参数,只能猜测——这是 heartbleed 等漏洞的根源
}正确的安全写法:
// 明确传递大小信息
void read_data(int* buf, size_t len) {
 for (size_t i = 0; i < len; i++) // 有明确边界
 buf[i] = ...;
}
在现代 C++ 中,std::span 和 std::array 解决了数组退化问题——它们携带大小信息,不丢失。
大数组与虚拟内存
当数组大小超过几百 MB 时,虚拟内存行为成为性能瓶颈。malloc 分配大数组的过程:
sequenceDiagram
 participant App as 应用程序
 participant Malloc as malloc (glibc)
 participant Kernel as OS 内核
 participant MMU as 内存管理单元 (MMU)

 App->>Malloc: malloc(1GB)
 Malloc->>Kernel: mmap(NULL, 1GB, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0)
 Kernel->>MMU: 在页表中创建虚拟地址→没有物理页框的映射 (demand-zero mapping)
 Kernel-->>Malloc: 返回虚拟地址
 Malloc-->>App: 返回指针 (瞬间完成,仅分配虚拟地址)

 App->>MMU: 写入 arr[0..4095] (第 0 页)
 MMU->>Kernel: 页表项为空,触发 page fault
 Kernel->>Kernel: 分配物理页框 (4KB),清零,建立页表映射
 Kernel-->>MMU: 返回,重新执行写入指令
 MMU-->>App: 写入成功

 note over App,MMU: arr[0] 到 arr[1023] 在此页内,不再缺页

 App->>MMU: 写入 arr[1024] (第 1 页的起始)
 MMU->>Kernel: 再次 page fault...
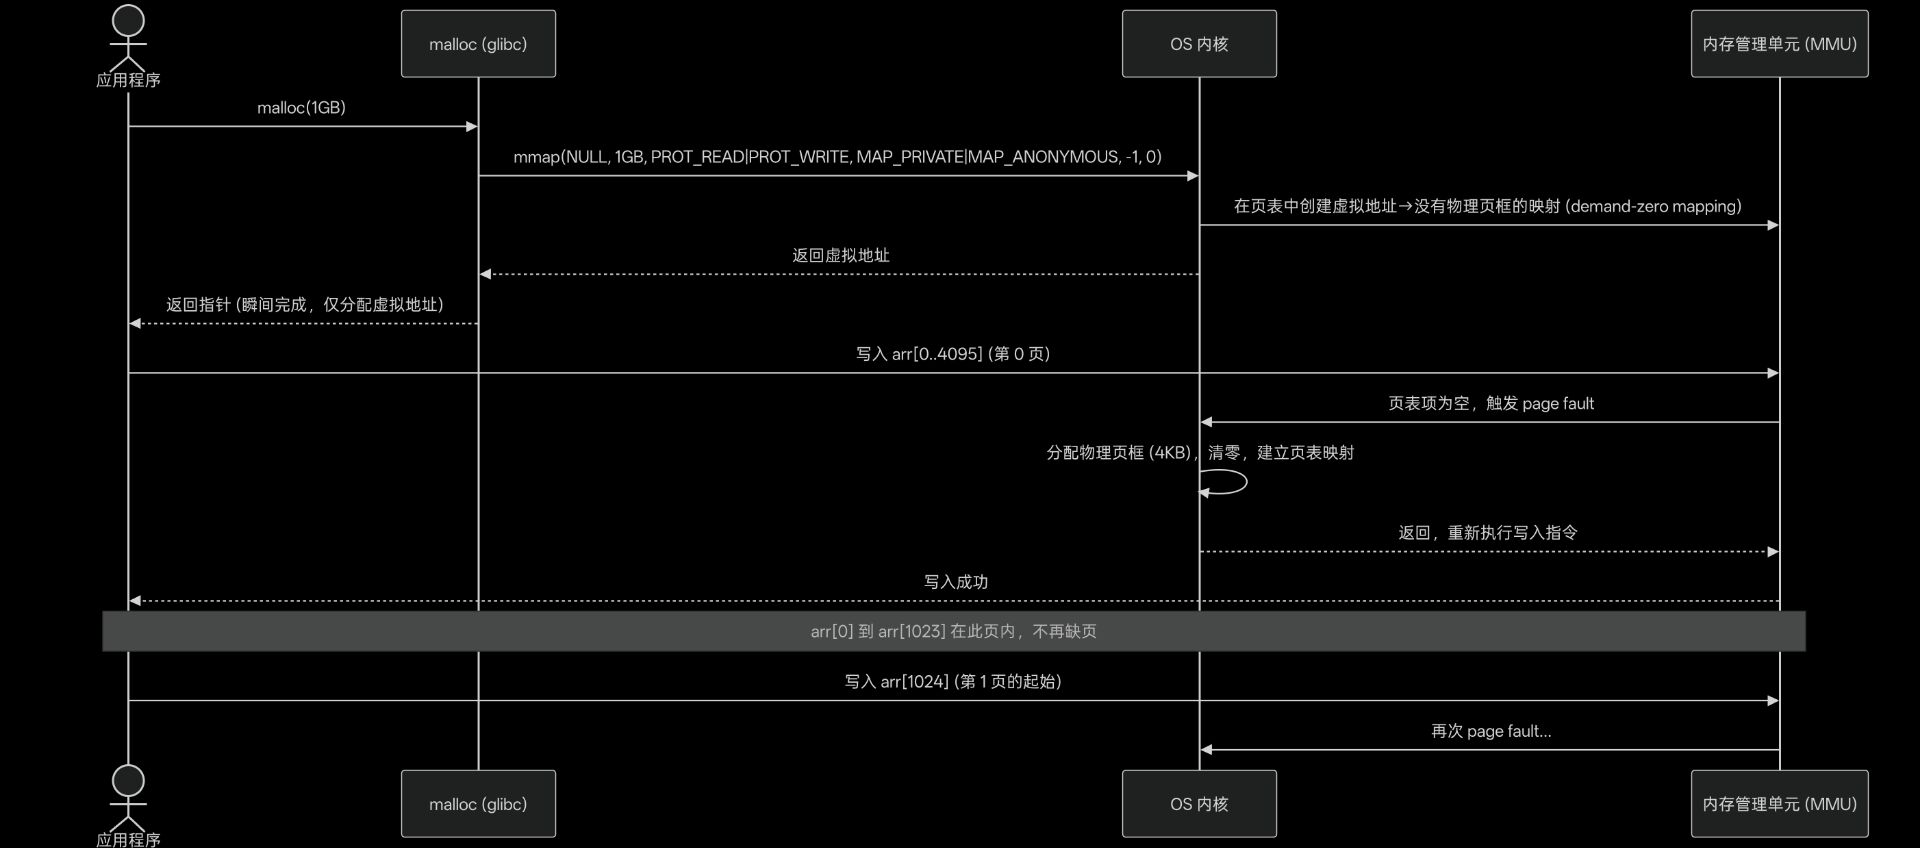
这里点击放大可以看到完整图片
缺页中断的三阶段开销:
- CPU 上下文保存:硬件自动压栈 RIP/CS/RFLAGS/RSP/SS(约 20 周期),然后跳转 page fault handler
- 内核处理:遍历进程 VMA 链表确认地址合法 → 调用伙伴分配器获取空闲物理页框 → 用
memset清零 4KB 页 → 填写页表项(PTE)→ 刷新 TLB 对应项 - 返回用户态:
iret恢复上下文,重新执行引发缺页的那条指令
一次缺页中断的总延迟约 1000-10000ns(1-10μs),即 3000-30000 个 CPU 周期。对于 1GB 的 int 数组(256M 个 int),共占据 个 4KB 页。首次遍历时,每个页触发一次缺页中断,总计约 262144 × 5μs ≈ 1.3 秒延迟,远超过内存带宽本身的时间。
优化策略:
// 使用 madvise 预加载大数组的物理页
int* big = malloc(1GB);
madvise(big, 1GB, MADV_WILLNEED); // 提示内核:这些页即将被访问
// 内核可能在后台预先完成缺页处理,减少后续首次访问的停顿
MADV_WILLNEED 是一个乐观的 hint——内核可能预取也可能忽略,取决于当前系统内存压力。在生产系统中,对大数组使用 MAP_POPULATE 标志(mmap 时)或 mlockall(锁定物理页)可以保证物理页框一次性分配完毕。
SIMD 与自动向量化
数组操作是现代编译器自动向量化的主要目标。对于以下循环:
void add_arrays(const int* a, const int* b, int* c, int n) {
 for (int i = 0; i < n; i++)
 c[i] = a[i] + b[i];
}
编译器(GCC -O3 -march=native)会将其转换为使用 AVX2 的 SIMD 指令:
; 简化的向量化版本 (AVX2, 一次处理 8 个 int)
vpmovsxdq ymm0, [rdi + rax] ; 加载 a[i..i+7] 的 8 个 int
vpaddd ymm0, ymm0, [rsi + rax] ; 与 b[i..i+7] 对应相加
vmovdqu [rdx + rax], ymm0 ; 存储结果到 c[i..i+7]
add rax, 32 ; 前移 8 × 4 = 32 字节
cmp rax, rcx
jl .loop
向量化要求:
- 数组在内存中连续:
int*和真二维数组满足,int**指针数组不满足——各行可能散落在堆的各处,编译器无法确定数组的位置关系 - 无依赖冲突(aliasing):编译器必须确信
c不覆盖a或b(否则顺序写入 c 可能污染尚未读取的 a/b)。使用restrict关键字可以给编译器这个承诺:
void add_arrays(int* restrict a, int* restrict b, int* restrict c, int n);- 对齐:SIMD 加载指令(如
vmovdqa)要求地址 32 字节对齐,未对齐则需使用vmovdqu(允许未对齐但略慢)
SIMD 向量化的性能模型
理想加速比:设 SIMD 寄存器宽度为 (字节),元素大小为 (字节),则单条 SIMD 指令可并行处理 个元素。对于 个元素的数组操作:
其中 是单个元素操作的时钟周期数,remainder 处理不足 个的尾部元素。理想加速比:
| SIMD 指令集 | 寄存器宽度 | int 加速比 | double 加速比 |
|---|---|---|---|
| SSE2 | 128 bit = 16 B | 4 | 2 |
| AVX2 | 256 bit = 32 B | 8 | 4 |
| AVX-512 | 512 bit = 64 B | 16 | 8 |
实际限制因素:
-
带宽瓶颈:当数组操作是内存受限型(如简单拷贝)时,加速比受内存带宽限制而非计算能力。若内存带宽为 GB/s,数据大小为 字节,理论最小时间为 ,SIMD 无法突破这个下限。
-
尾部处理开销: 不是 的整数倍时,尾部 个元素需标量处理,开销占比 (可忽略)。
-
指令吞吐限制:现代 CPU 每周期可发射 1-2 条 SIMD 指令(端口限制)。若循环体有 条 SIMD 指令,实际加速比为 。
-
循环展开(Unrolling):将循环展开 次可减少分支预测开销和指令发射瓶颈:
例如 AVX2()处理 int(),展开 4 次、3 条指令:——此时计算能力足够,加速比受寄存器宽度限制。
内存对齐对数组性能的影响
数组元素的对齐决定了每次访问跨越几条 cache line。对于结构体数组:
struct BadAlign {
 char flag; // 1 字节
 double val; // 8 字节 — 编译器在 flag 后插入 7 字节 padding
}; // sizeof = 16 字节,而非 1+8=9 字节

struct BadAlign arr[1000]; // 占用 16000 字节,浪费 7000 字节
将大字段排在前面可以减少 padding:
struct GoodAlign {
 double val; // 8 字节
 char flag; // 1 字节 — padding 仅在末尾(对齐到 8 的倍数)
}; // sizeof = 16 字节(但 val 在最前,对缓存预取更友好)
graph TD subgraph "BadAlign — flag 在前" B0["flag(1) + pad(7)"] --- B1["val[0..7]"] B1 --- B2["flag(1) + pad(7)"] --- B3["val[0..7]"] end subgraph "GoodAlign — val 在前" G0["val[0..7]"] --- G1["flag(1) + pad(7)"] G1 --- G2["val[0..7]"] --- G3["flag(1) + pad(7)"] end
对于遍历 val 字段的场景,GoodAlign 布局使得连续的 val 字段尽可能靠近,cache line 利用率更高。详细对齐原理见 计算机原理 — 内存对齐。
数组上的经典算法
前面两节回答了”数组是什么、为什么快”。本节回答另一半要求:在这块连续内存上,有哪些被反复验证过的索引操纵套路。双指针、滑动窗口、二分、前缀和与差分——它们都不改变存储结构,而是把 随机访问这个硬件特性兑换成算法层面的效率跃升。
双指针:用两个下标替代两层循环
暴力枚举所有配对是 。双指针的核心洞察:如果数据具备某种单向有序性(已排序 / 可归约条件),两个下标的相对运动就能剪掉绝大多数无效配对。
对撞指针——两端向中间收拢,典型场景是有序结构上的配对搜索:
// 有序数组中找 a[i] + a[j] == target(LeetCode 167 两数之和 II)
bool two_sum_sorted(const int* a, int n, int target, int* oi, int* oj) {
    int lo = 0, hi = n - 1;
    while (lo < hi) {
        int s = a[lo] + a[hi];
        if (s == target) { *oi = lo; *oj = hi; return true; }
        else if (s < target) lo++;   // 最小者太小,只能换更大的
        else                 hi--;   // 最大者太大,只能换更小的
    }
    return false;
}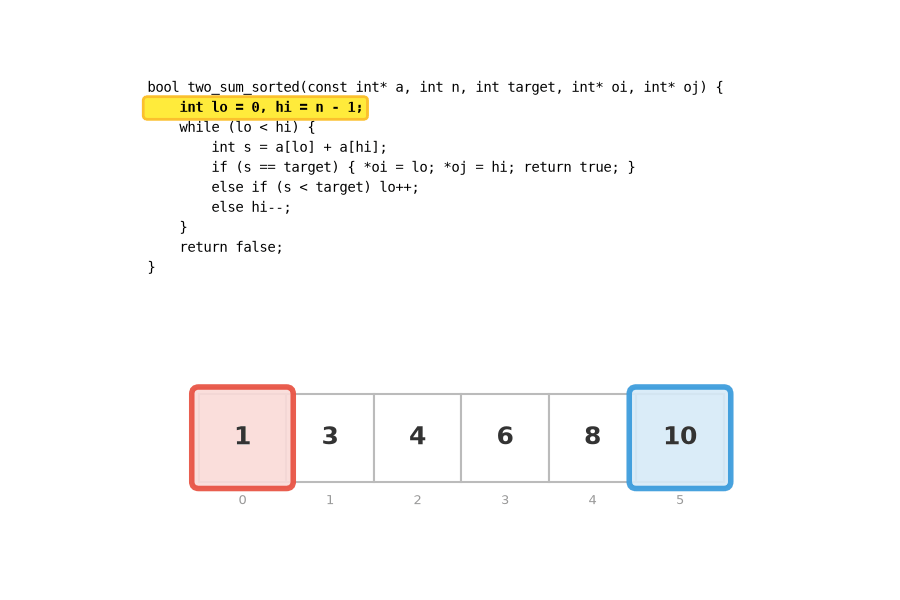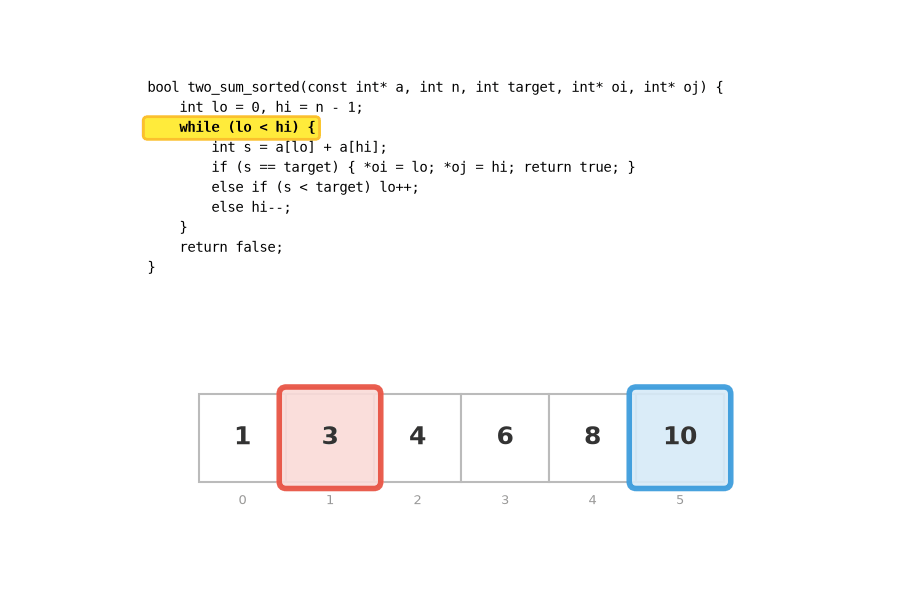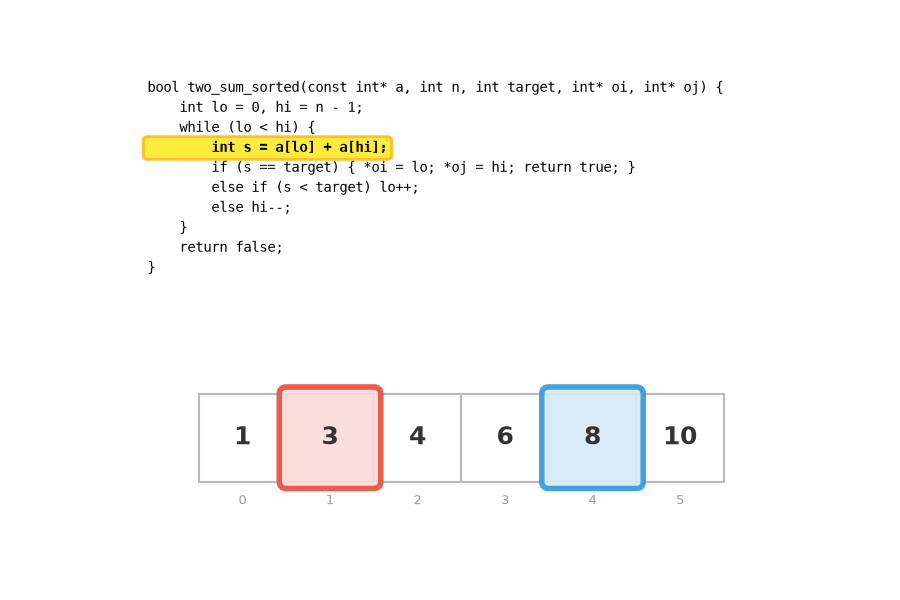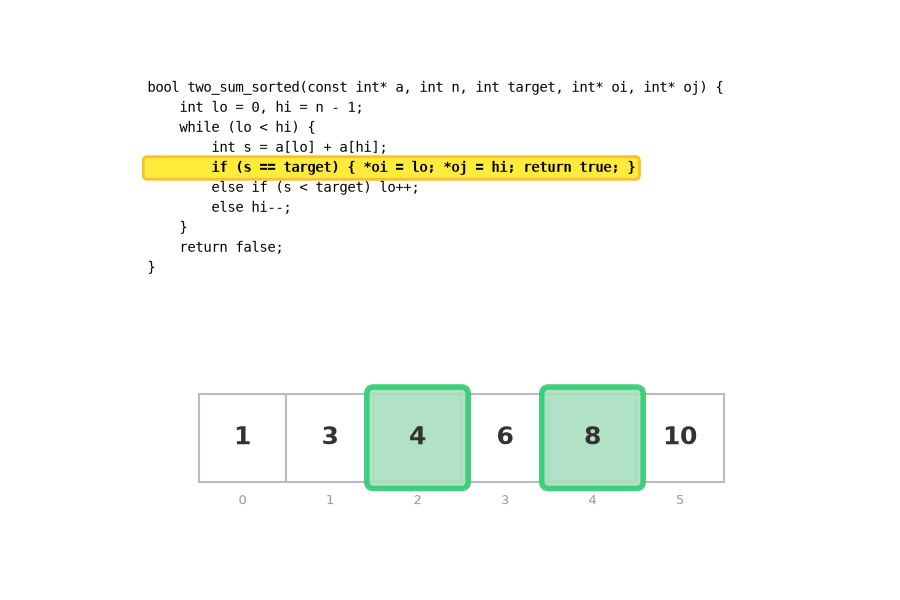
每一步都确定性排除一整行候选——当 时, 与任何更小的 配对只会更小,于是 这一整行被一次性淘汰。 步内收敛,复杂度从暴力 降到 。三数之和(LeetCode 15)就是外层固定一个数、内层跑一遍对撞指针。
快慢指针——同向而行,快指针探路、慢指针守结果区。本章练习的”原地删除”系列全是这一个模板:
// 有序数组原地去重,返回新长度(LeetCode 26)—— 快慢指针 O(n)
int remove_duplicates(int* a, int n) {
    if (n == 0) return 0;
    int slow = 0;                          // [0..slow] 是去重后的结果区
    for (int fast = 1; fast < n; fast++)
        if (a[fast] != a[slow])
            a[++slow] = a[fast];           // 遇到新值才推进结果边界
    return slow + 1;
}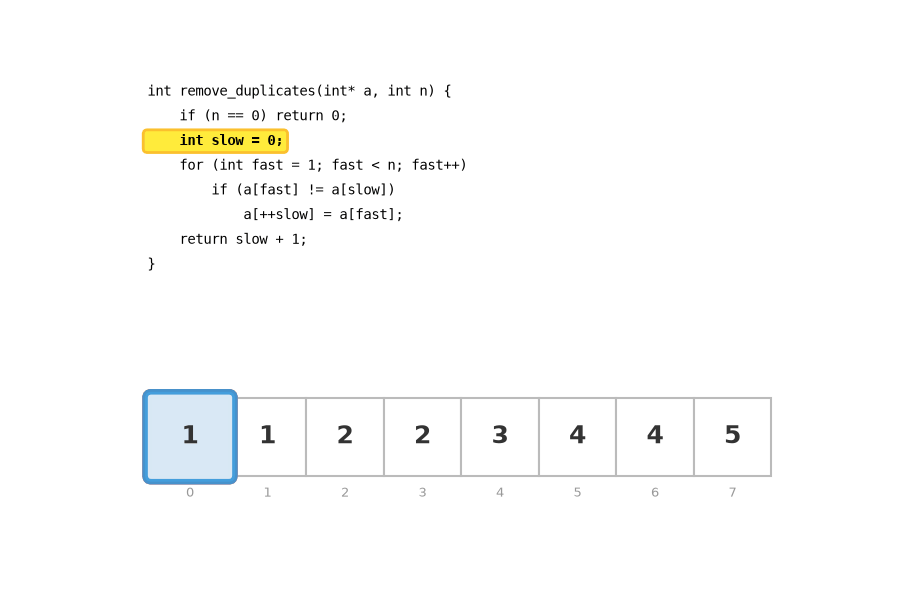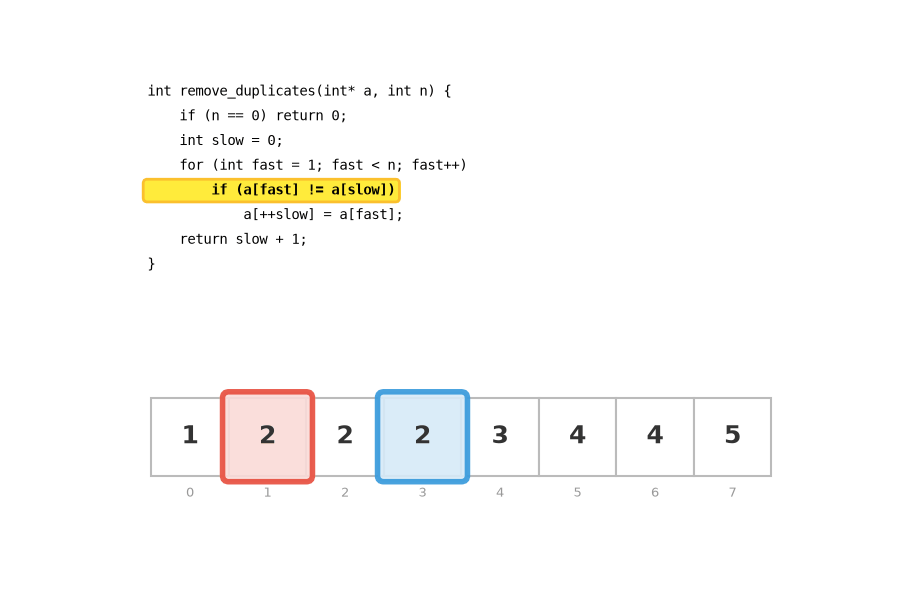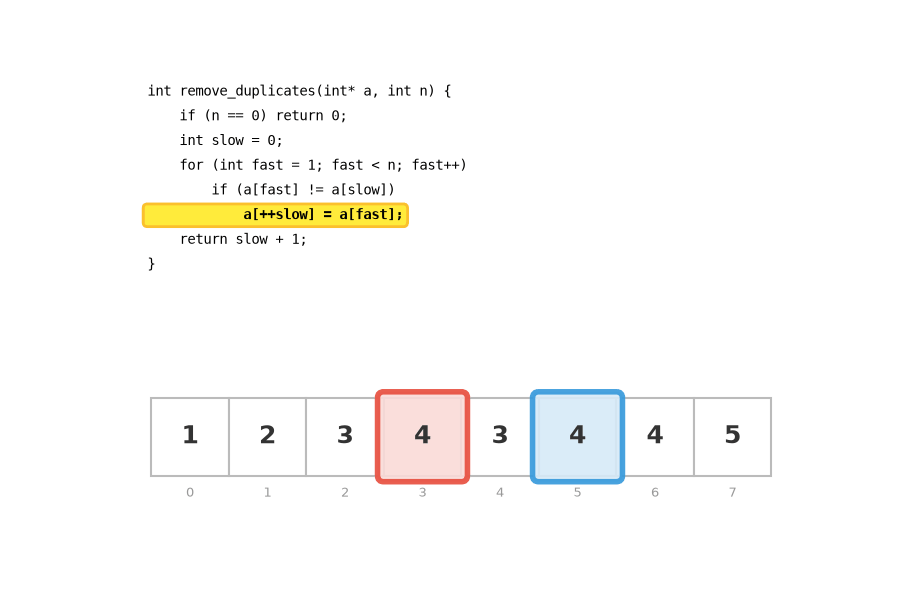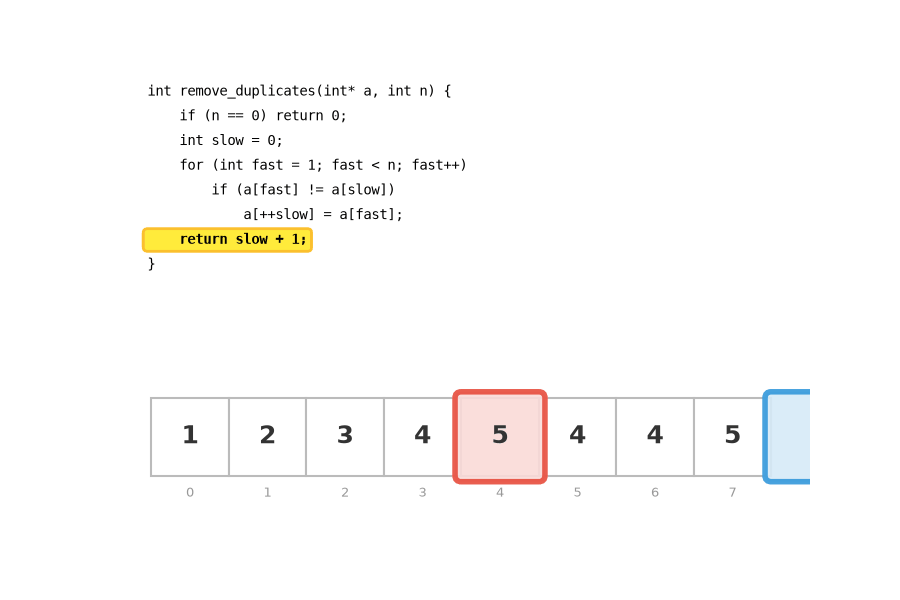
快指针必然扫满 次,慢指针至多前进 次——时间 、空间 ,全程不需要第二个数组。“原地”二字正是连续内存的红利:写入位置由自己掌控。
滑动窗口:双指针的同向特化
两根指针同向且永不回退,中间夹住的 就是窗口。适用问题有明确特征:连续区间 + 指标随伸缩单调变化。
| 形态 | 窗口行为 | 典型问题 |
|---|---|---|
| 固定窗口 | right 走一步,left 同步走一步 | 定长子数组的最大和 |
| 可变窗口 | right 探索扩张,违反约束时 left 收缩 | 最长/最短满足条件的子数组 |
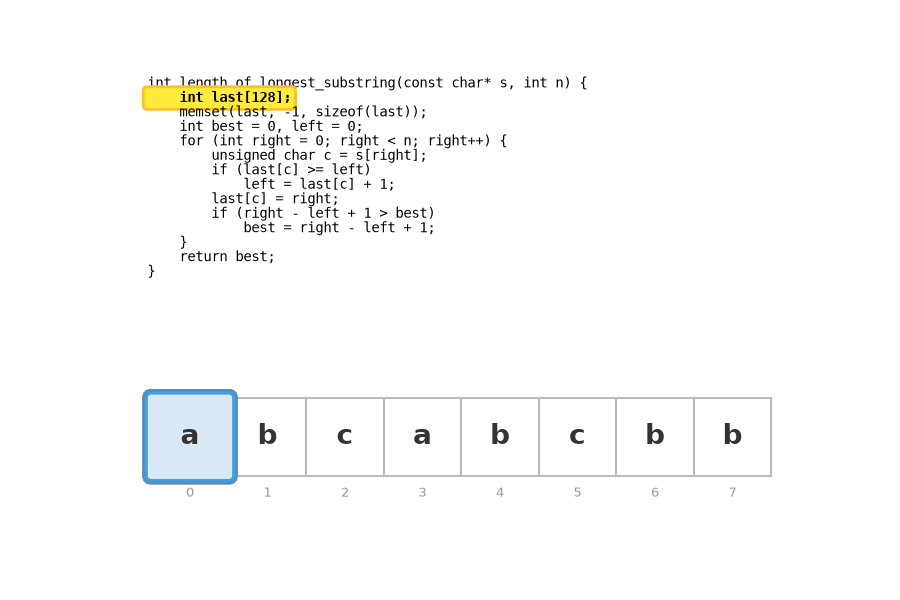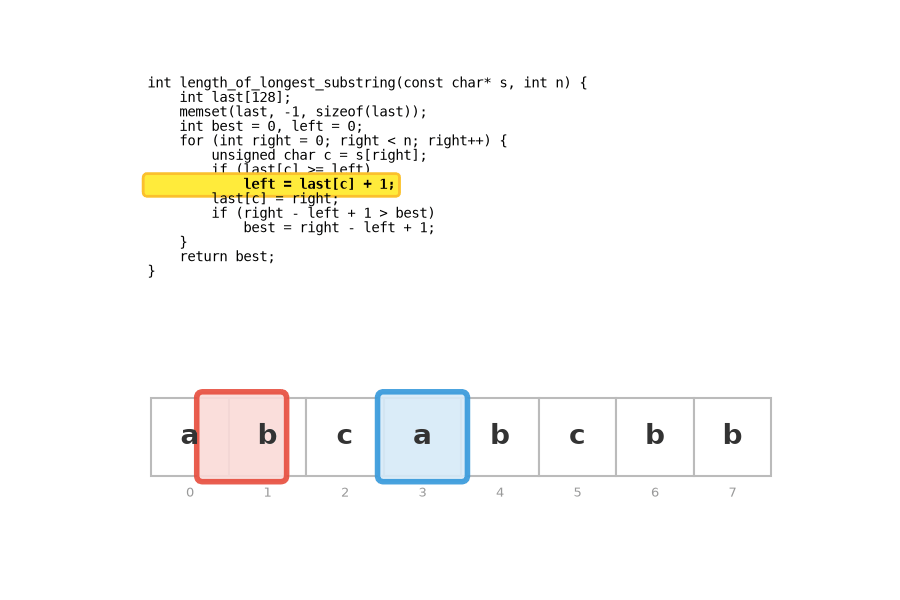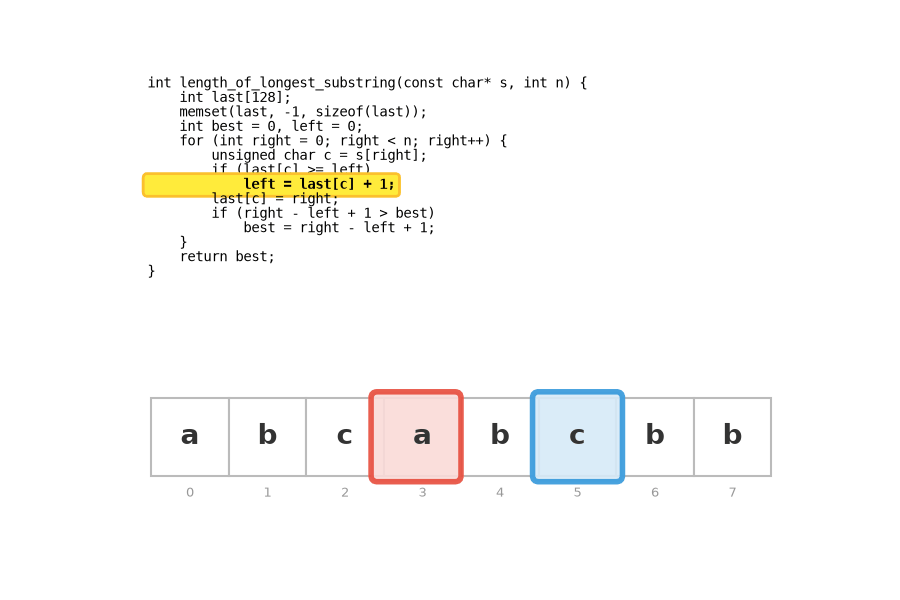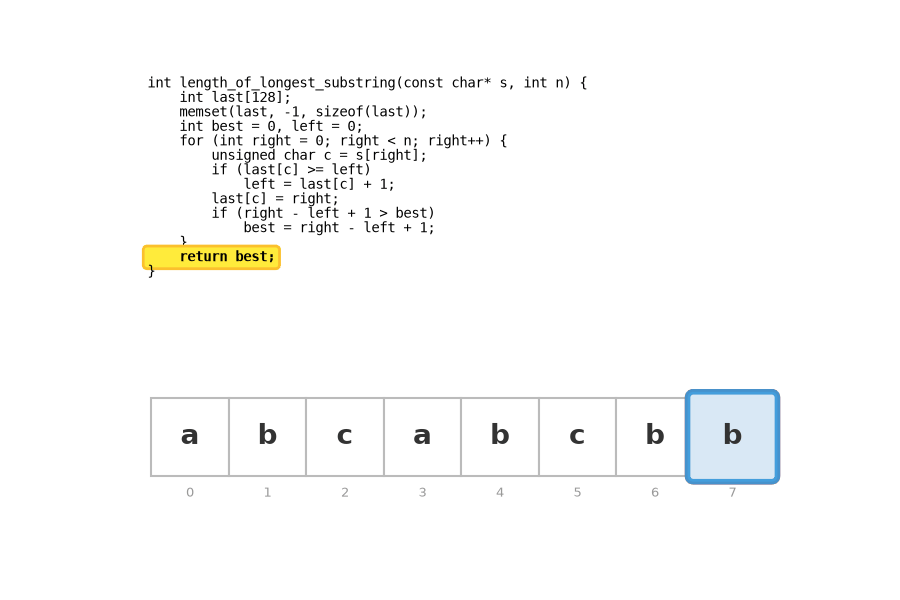
可变窗口的经典实现(LeetCode 3 最长无重复字符子串):
#include <string.h>

int length_of_longest_substring(const char* s, int n) {
    int last[128];
    memset(last, -1, sizeof(last));      // 每个字符上次出现的位置
    int best = 0, left = 0;              // 窗口 [left, right],无重复
    for (int right = 0; right < n; right++) {
        unsigned char c = s[right];
        if (last[c] >= left)             // c 在当前窗口内出现过
            left = last[c] + 1;          // 左界直接跳到重复位置的下一格
        last[c] = right;
        if (right - left + 1 > best)
            best = right - left + 1;
    }
    return best;
}
为什么是 而不是 ?均摊分析:right 全程只增 次,left 只增不减、也至多 次,两指针总位移 ——每个元素最多进窗一次、出窗一次。这与 KMP 的 、vector 扩容的分析共享同一个数学骨架:单调不减的计数器各自至多走 n 步。
二分查找:每次比较砍掉一半定义域
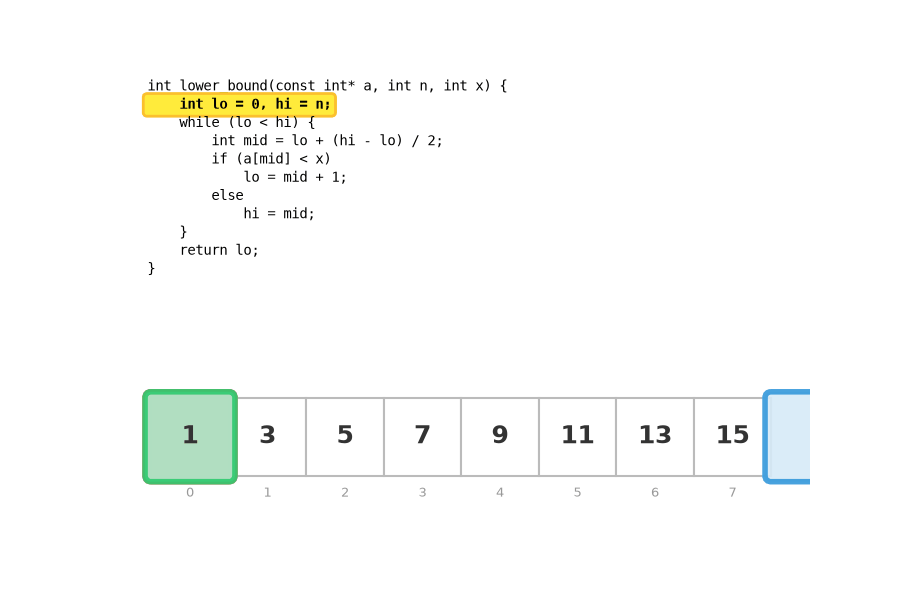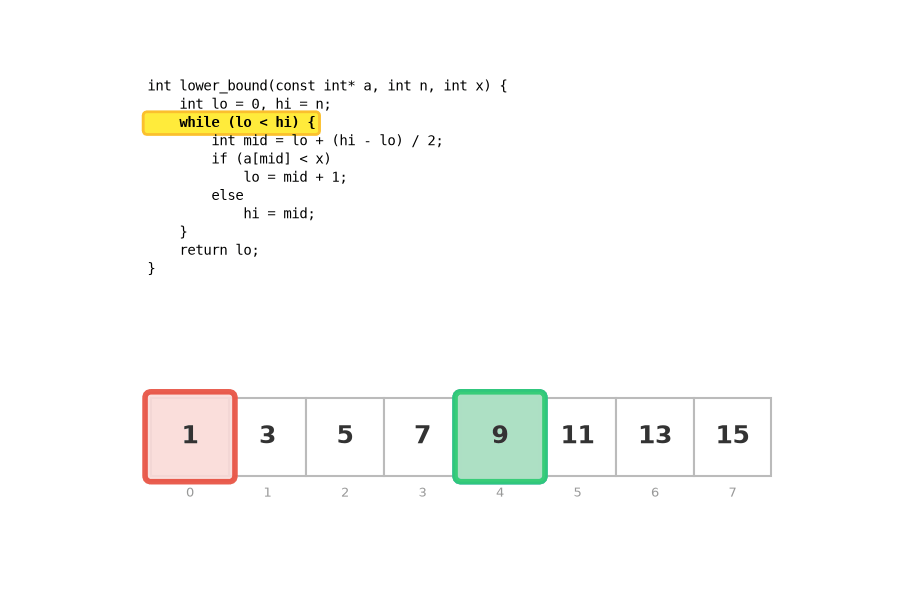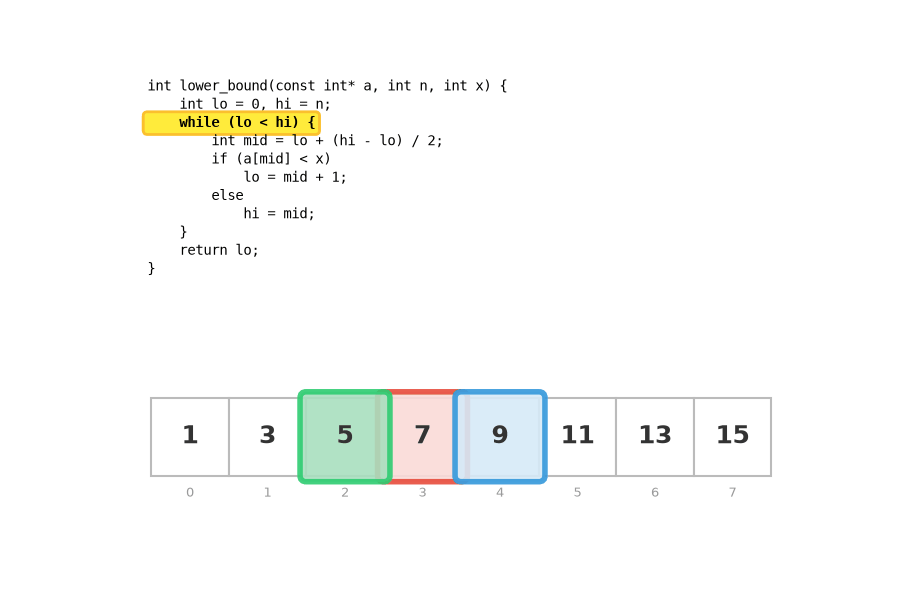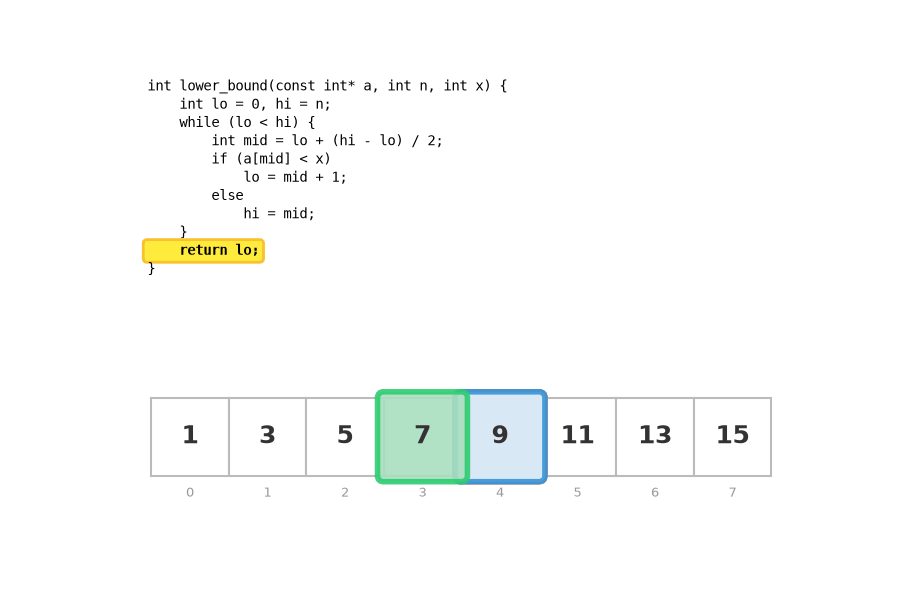
有序数组上定位元素不必逐个看:跳到正中比较,一次排除一半。100 万个元素只需 20 次比较,这就是 的含义。
// lower_bound:第一个 >= x 的下标;不存在返回 n —— 左闭右开写法
int lower_bound(const int* a, int n, int x) {
    int lo = 0, hi = n;                  // 不变量:答案永远落在 [lo, hi]
    while (lo < hi) {
        int mid = lo + (hi - lo) / 2;    // 写成 lo+(hi-lo)/2 防止溢出
        if (a[mid] < x)
            lo = mid + 1;                // mid 及其左侧全被排除
        else
            hi = mid;                    // mid 可能正是答案,必须保留
    }
    return lo;
}
三个工程细节值得刻进肌肉记忆:
mid = lo + (hi - lo) / 2而非(lo+hi)/2——后者在大数组上会整数溢出,这是 JDK 标准库里潜伏多年才被公开修复的真实 bug(Joshua Bloch 2006 年撰文致歉);- 区间约定全程一致——上面用左闭右开
[lo, hi);若中途混入闭区间写法,立刻死循环或漏判; - 循环不变量先行——动笔前先用一句话说清”lo、hi 之间永远装着什么”,一切边界争议自动消解。LeetCode 34(查找元素首末位置)就是跑两遍
lower_bound型二分的直接应用。
二分不止于查值。“二分答案”把任何具有单调性的判定问题(能否在 T 天内完成?最小可行容量是多少?)整体转化为二分搜索,是后期最重要的算法思想之一。
前缀和与差分:空间换时间的两端
如果数组不变而区间查询频繁,就把查询成本预支给预处理:
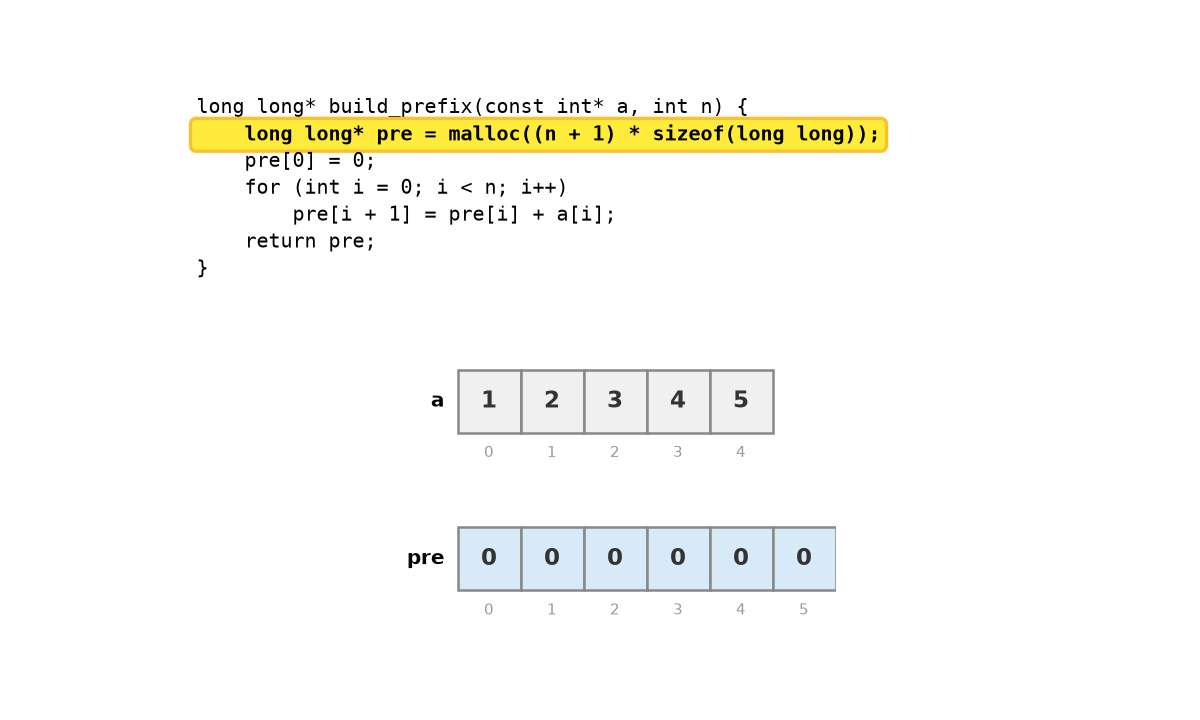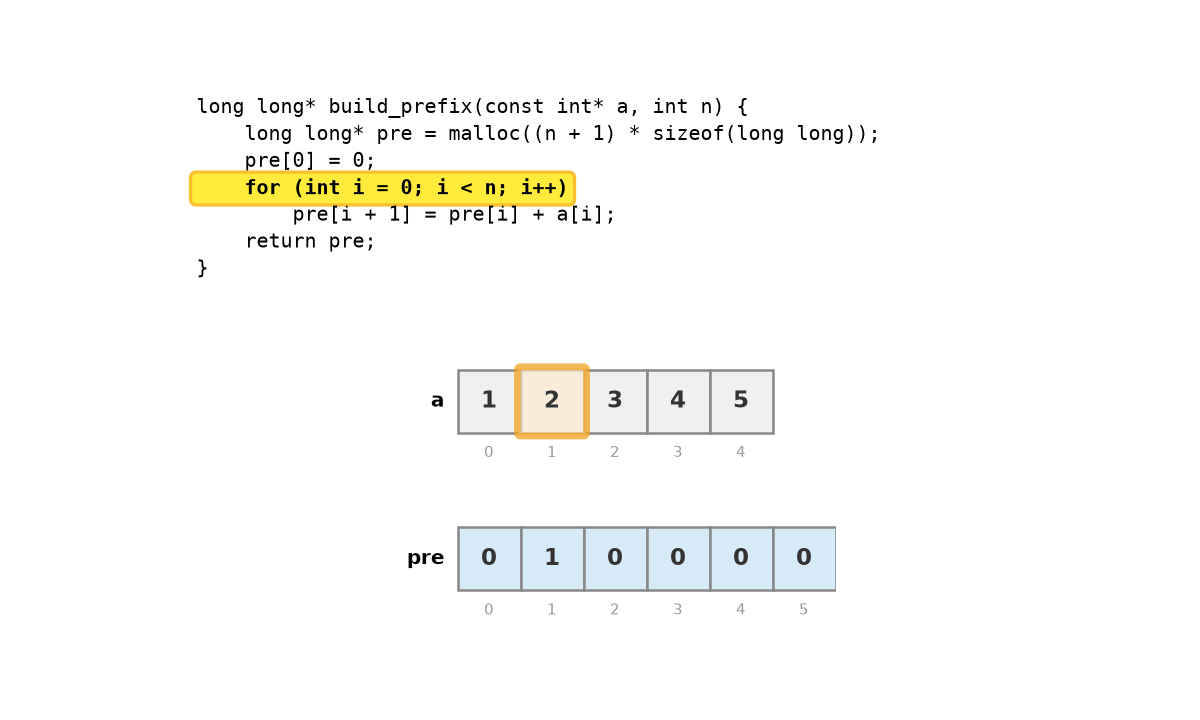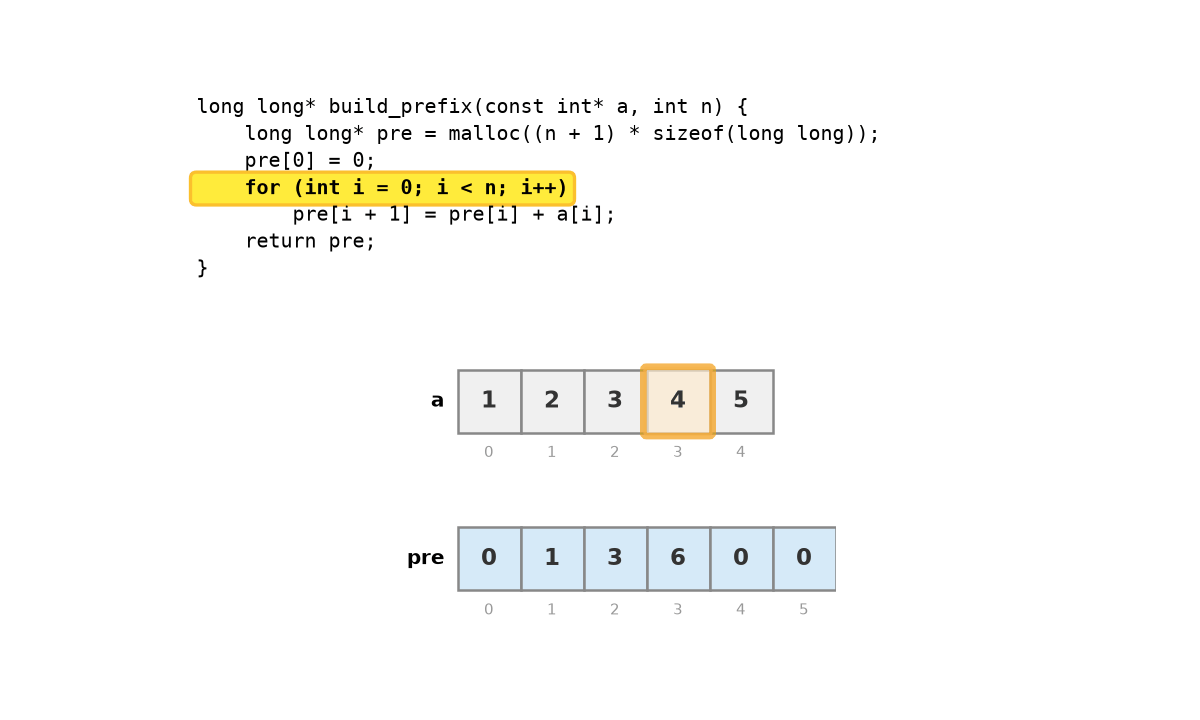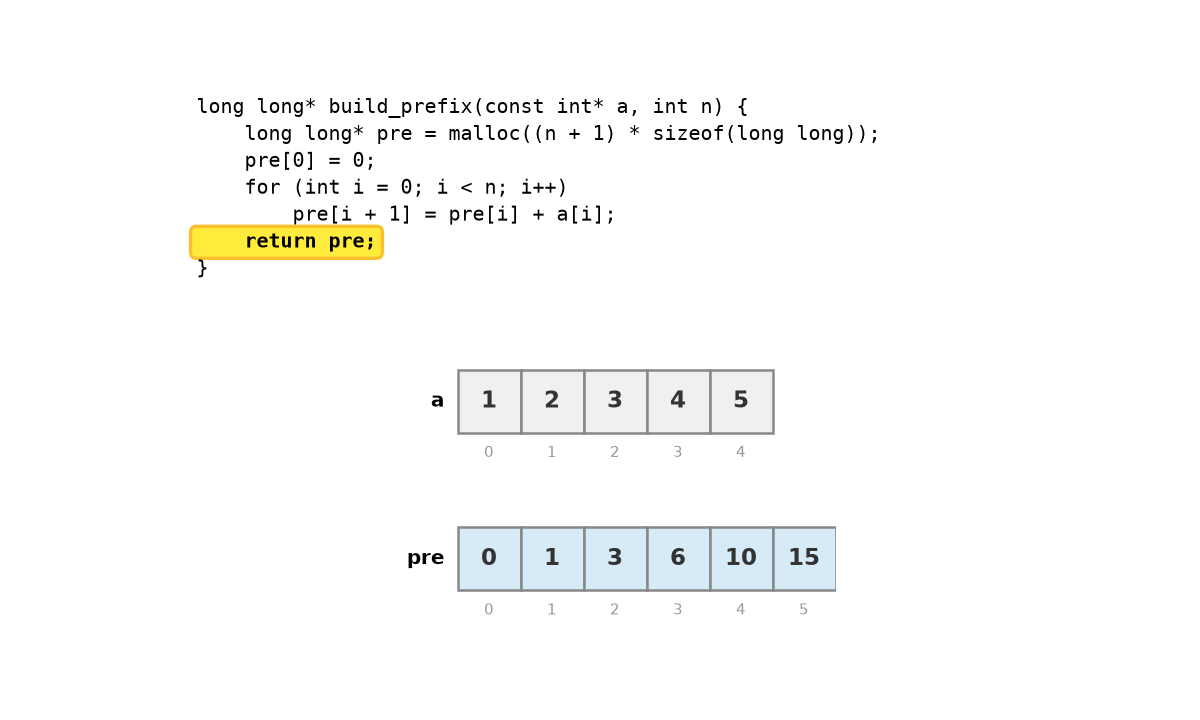
// 前缀和:构建 O(n),之后任意区间和查询 O(1)
long long* build_prefix(const int* a, int n) {
    long long* pre = malloc((n + 1) * sizeof(long long));
    pre[0] = 0;
    for (int i = 0; i < n; i++) pre[i + 1] = pre[i] + a[i];
    return pre;                          // [l, r] 的和 = pre[r+1] - pre[l]
}
反过来,如果区间修改频繁而单点读取稀少,用对偶的差分数组 diff[i] = a[i] - a[i-1]。给区间 整体加 只需碰两个端点:
diff[l]     += v;    // 从 l 开始,增量生效
diff[r + 1] -= v;    // 到 r 之后终止
// 所有修改完成后做一遍前缀和还原,每个单点值即正确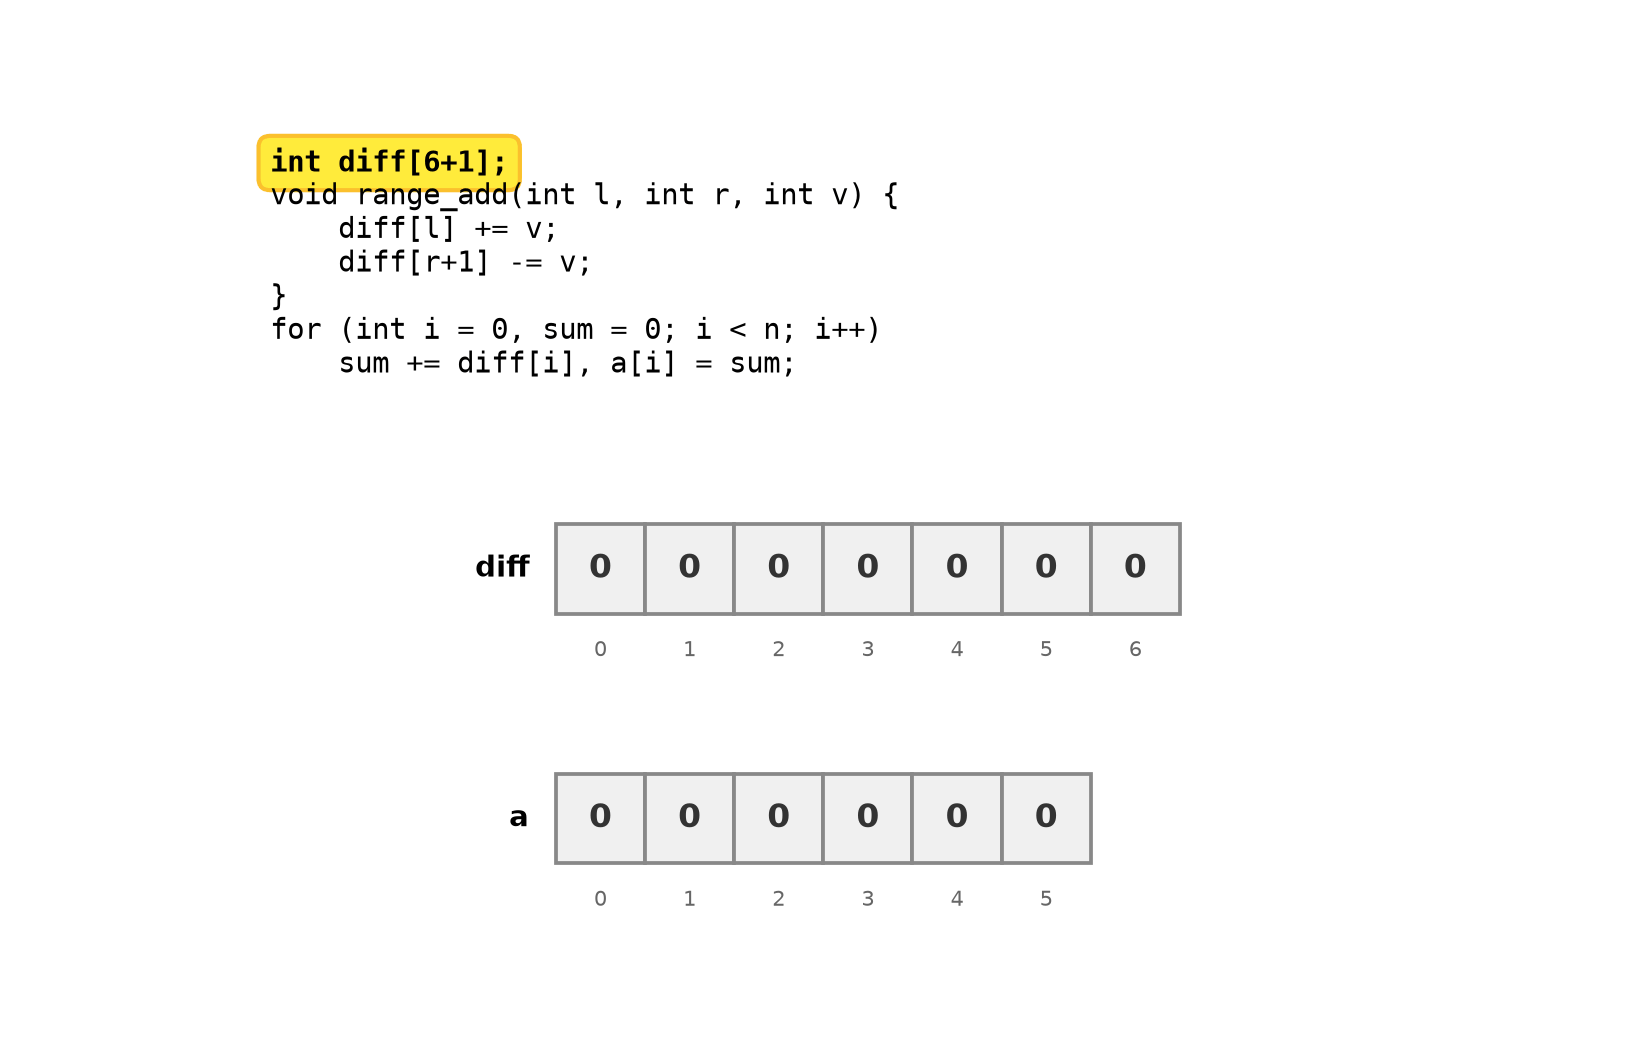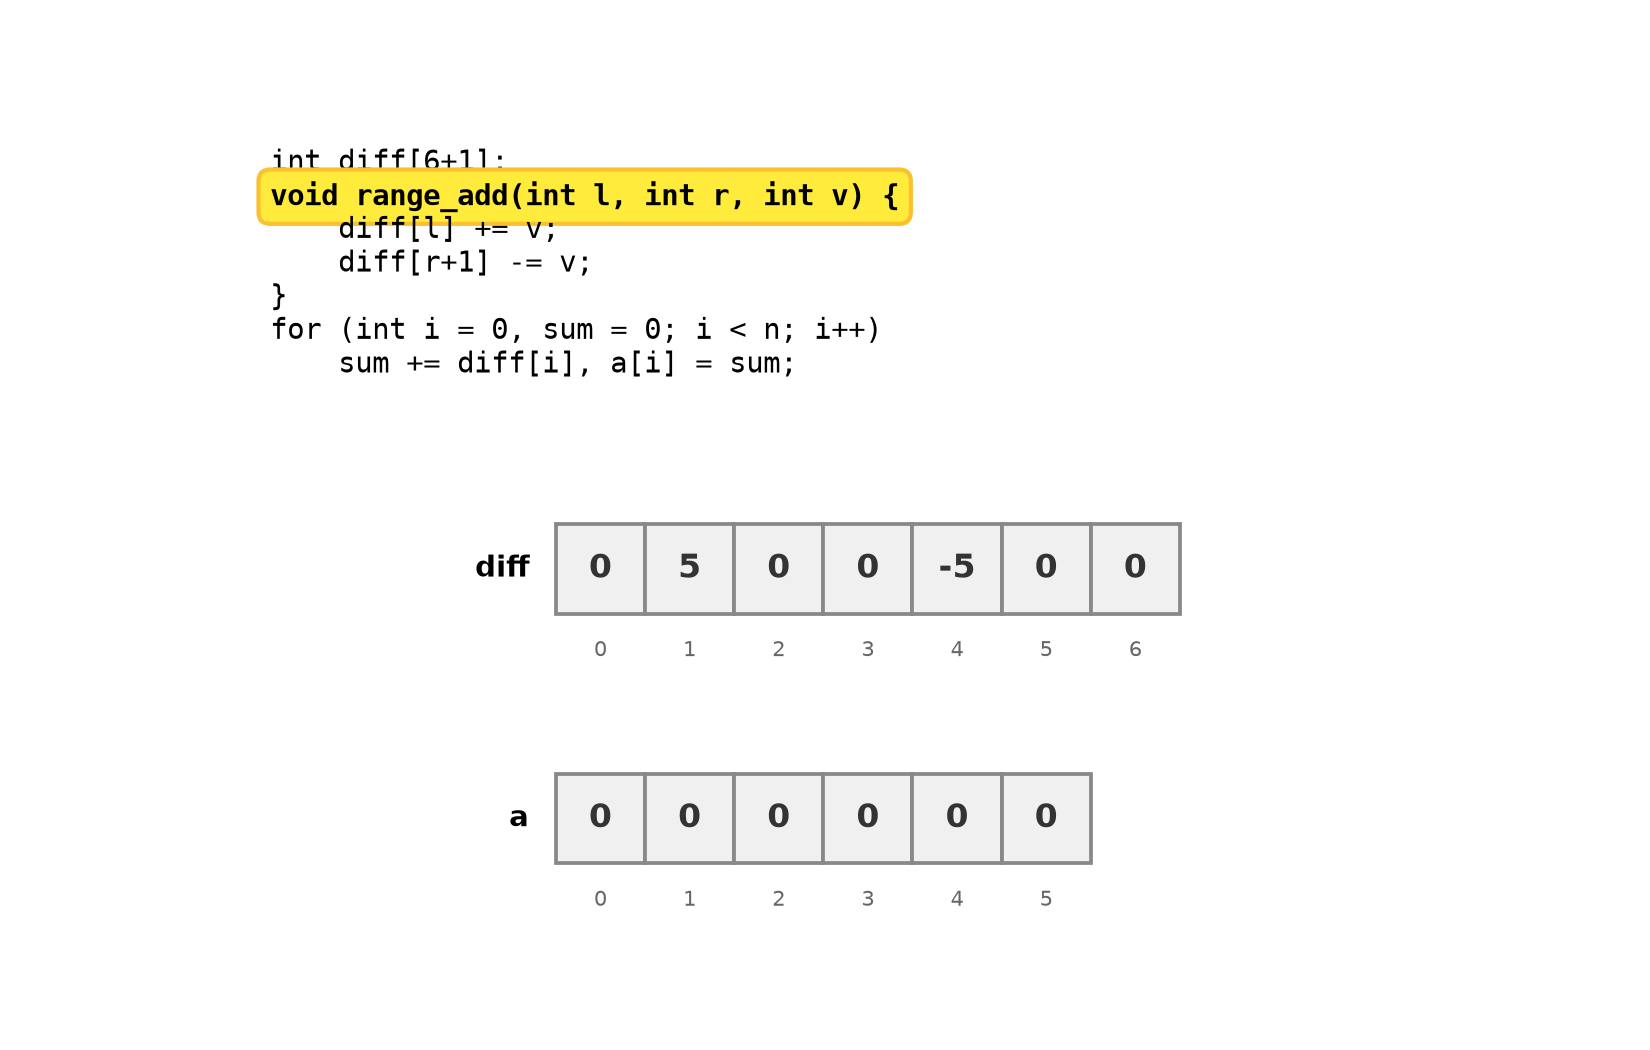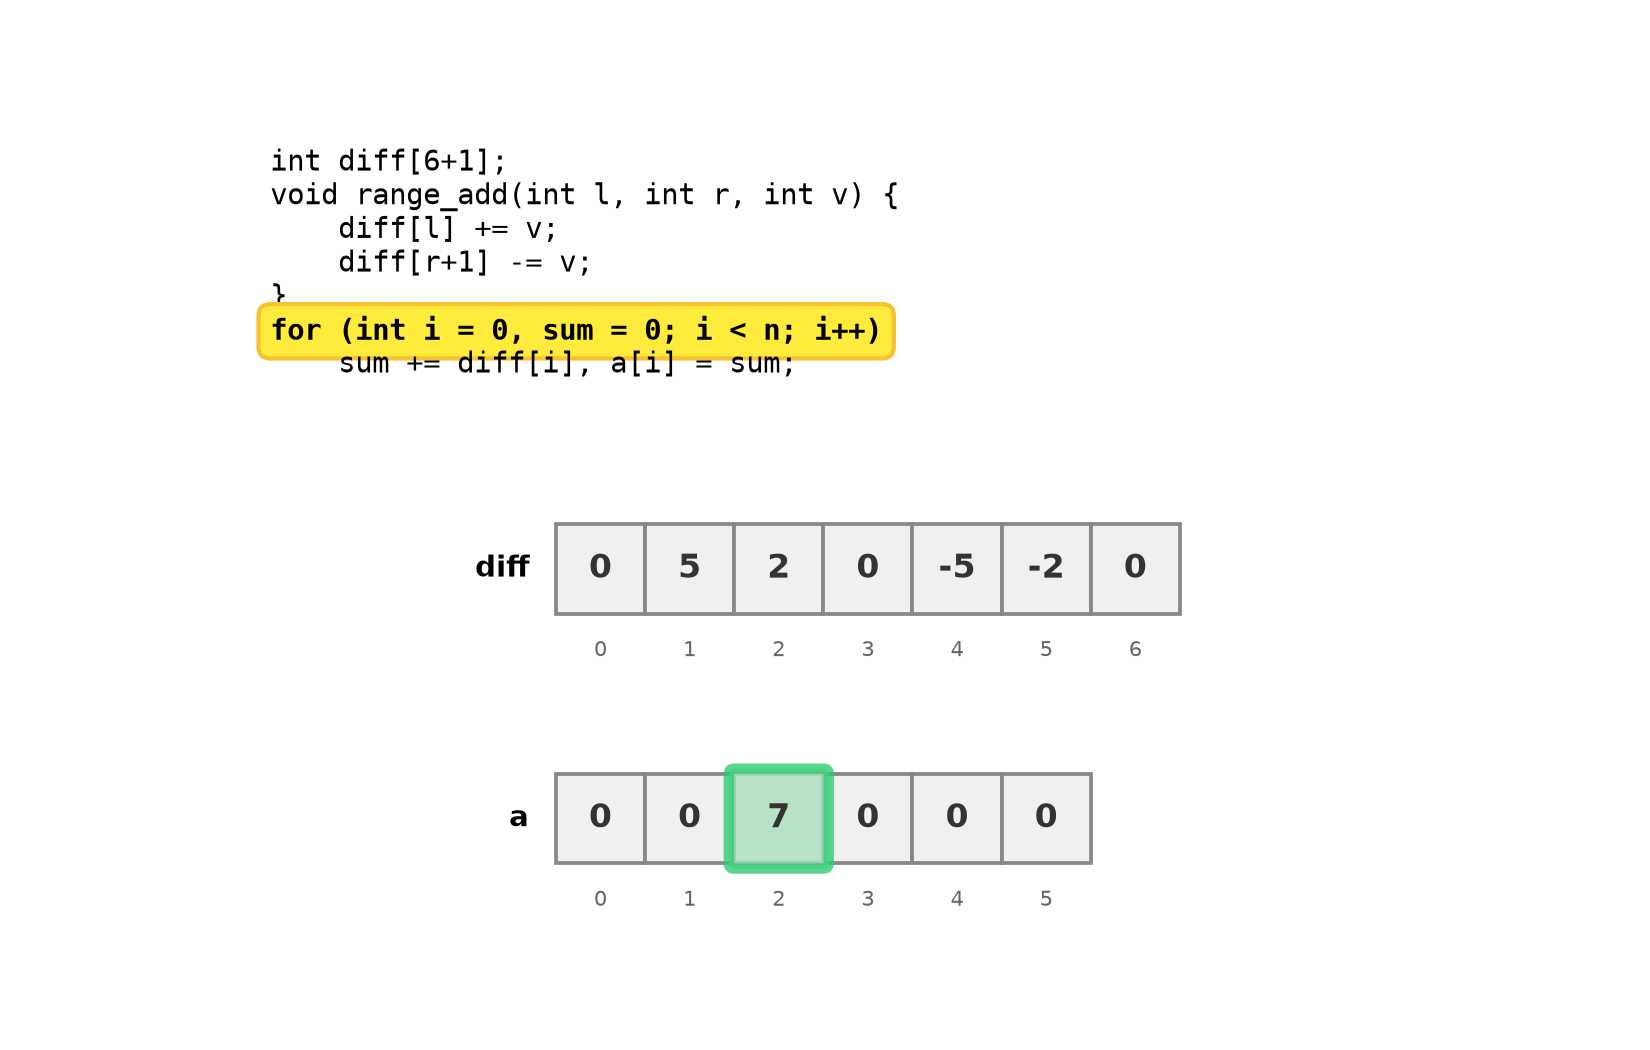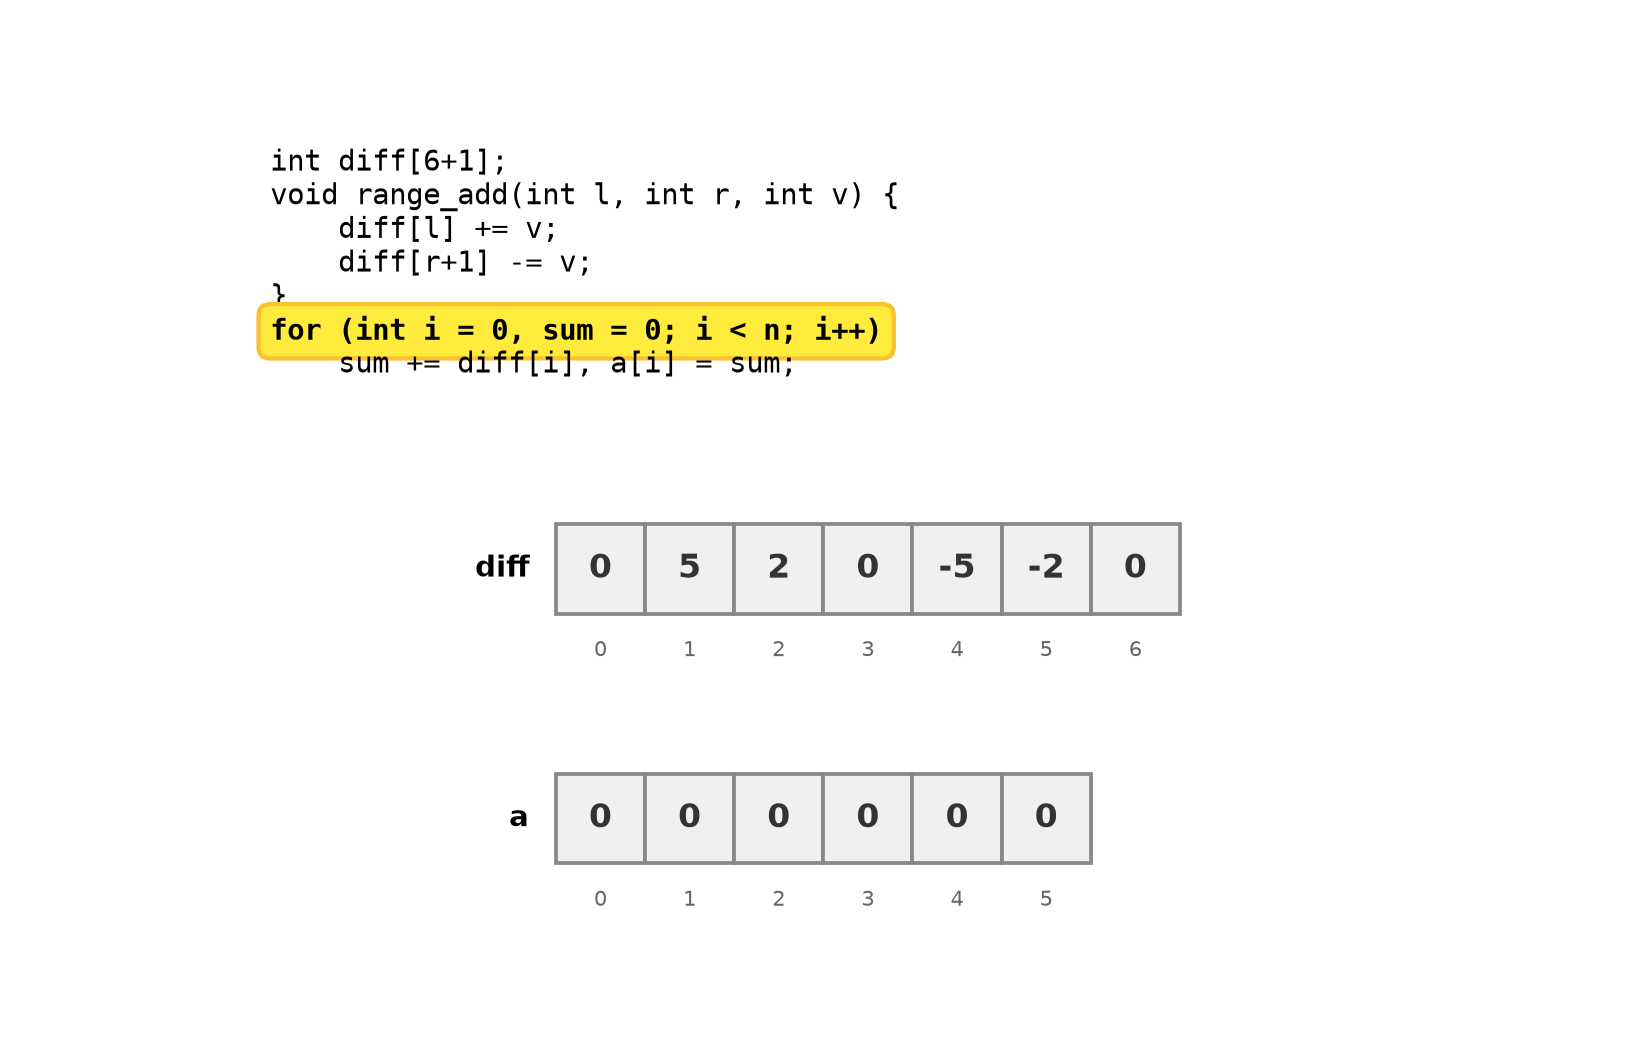
次区间修改的成本从 降到 。前缀和向高维推广是二维积分图,向动态化推广就是 树状数组与 线段树——它们让”边修改边查区间信息”维持在 。
五种套路的共同本质
| 套路 | 消耗的前提性质 | 复杂度跃升 |
|---|---|---|
| 对撞双指针 | 数值有序(可排序) | |
| 快慢指针 | 问题可归约为保留/丢弃判定 | 且原地 |
| 滑动窗口 | 指标随窗口伸缩单调 | |
| 二分查找 | 下标空间具有单调性 | |
| 前缀和 / 差分 | 数据静态(或修改可延迟) | 区间操作 |
它们的共同前提都是数组的两条硬件属性—— 随机访问让任意跳跃免费,连续内存让”区间”成为廉价的一等公民。同样的套路搬到链表上大多失效或退化,原因正在于此。
数组作为其他数据结构的底层存储
数组是大量高级数据结构的实现载体——不是”可以”用数组实现,而是”在实践中必然”用数组实现以获得 cache 友好的内存布局:
| 数据结构 | 底层用数组的方式 | 对应章节 |
|---|---|---|
| 堆(Heap) | 完全二叉树映射到一维数组,parent(i) = (i-1)/2,left(i) = 2i+1 | J_堆_Heap |
| 循环队列 | 数组 + 模运算,用 (head+1) % cap 绕回 | H_队列_Queue |
| 哈希表(开放寻址) | 数组存储键值对,探测时线性/二次扫描 | O_哈希表_HashTable |
| 线段树 | 大小为 4n 的数组,tree[i] 保存区间信息 | R_线段树_SegmentTree |
| 树状数组 | 长度为 n+1 的数组,利用 lowbit(i) = i & -i 定位管辖区间 | S_树状数组_BIT |
堆是最经典的例子——逻辑上是一棵完全二叉树,但在存储层面只是一个数组。父子关系不靠指针而靠下标公式,每一步跳转就是一条 lea 指令。详见 堆 — 数组存储。
实现
带边界检查的静态数组
#include <stdlib.h>

typedef struct {
 int* data;
 size_t length;
} StaticArray;

void sa_init(StaticArray* a, size_t n) {
 a->data = malloc(n * sizeof(int));
 a->length = n;
}

void sa_destroy(StaticArray* a) {
 free(a->data);
 a->data = NULL;
 a->length = 0;
}

int sa_get(const StaticArray* a, size_t index, int* out) {
 if (index >= a->length) return -1; // 拒绝越界
 *out = a->data[index]; // 寻址: data + index * sizeof(int)
 return 0;
}

int sa_set(StaticArray* a, size_t index, int value) {
 if (index >= a->length) return -1;
 a->data[index] = value;
 return 0;
}
连续二维数组(平坦数组)
在 C 语言中,用一维数组手动计算下标索引,是实现真连续二维数组的最通用方式——工作在所有 C/C++ 版本,且保证缓存最优:
#include <stdlib.h>

typedef struct {
 int* data; // 平坦数组,大小为 rows * cols
 size_t rows;
 size_t cols;
} Matrix2D;

void mat_init(Matrix2D* m, size_t rows, size_t cols) {
 m->data = malloc(rows * cols * sizeof(int));
 m->rows = rows;
 m->cols = cols;
}

void mat_destroy(Matrix2D* m) {
 free(m->data);
 m->data = NULL;
}

// 下标映射: addr(i, j) = base + (i * cols + j) * sizeof(int)
int mat_get(const Matrix2D* m, size_t i, size_t j, int* out) {
 if (i >= m->rows || j >= m->cols) return -1;
 *out = m->data[i * m->cols + j];
 return 0;
}

int mat_set(Matrix2D* m, size_t i, size_t j, int value) {
 if (i >= m->rows || j >= m->cols) return -1;
 m->data[i * m->cols + j] = value;
 return 0;
}
这种平坦数组方式在科学计算库(如 BLAS、LAPACK、NumPy 底层)中是标准做法——一整块 malloc 加上手动下标计算,同时获得内存连续性、缓存友好性和分配/释放的简洁性。
动态数组的扩容实现(含均摊 O(1) 的数学证明)见 容器章节。
二分查找完整版(含边界处理)
实际工程中很少只找”等于 target 的位置”——更常见的是找边界:第一个 ≥ target、第一个 > target、最后一个 == target。以下是左闭右开 [lo, hi) 写法的完整工具集:
#include <stddef.h>

// 标准二分:返回 target 的下标,不存在返回 -1
int bsearch_eq(const int* a, int n, int target) {
    int lo = 0, hi = n;
    while (lo < hi) {
        int mid = lo + (hi - lo) / 2;
        if (a[mid] < target)      lo = mid + 1;
        else if (a[mid] > target) hi = mid;
        else                      return mid;    // 找到
    }
    return -1;
}

// lower_bound:第一个 >= target 的位置;全部小于则返回 n
int bsearch_lower(const int* a, int n, int target) {
    int lo = 0, hi = n;
    while (lo < hi) {
        int mid = lo + (hi - lo) / 2;
        if (a[mid] < target) lo = mid + 1;
        else                 hi = mid;
    }
    return lo;
}

// upper_bound:第一个 > target 的位置;全部 ≤ target 则返回 n
int bsearch_upper(const int* a, int n, int target) {
    int lo = 0, hi = n;
    while (lo < hi) {
        int mid = lo + (hi - lo) / 2;
        if (a[mid] <= target) lo = mid + 1;
        else                  hi = mid;
    }
    return lo;
}

// 第一个 == target 的位置;不存在返回 -1
int bsearch_first(const int* a, int n, int target) {
    int pos = bsearch_lower(a, n, target);
    return (pos < n && a[pos] == target) ? pos : -1;
}

// 最后一个 == target 的位置;不存在返回 -1
int bsearch_last(const int* a, int n, int target) {
    int pos = bsearch_upper(a, n, target) - 1;
    return (pos >= 0 && a[pos] == target) ? pos : -1;
}

// target 出现次数;不存在返回 0
int bsearch_count(const int* a, int n, int target) {
    int lo = bsearch_lower(a, n, target);
    int hi = bsearch_upper(a, n, target);
    return hi - lo;      // [lo, hi) 内全是 target
}六个函数共享同一个循环不变量:[0, lo) 全部 < target(或 ≤ target),[hi, n) 全部 ≥ target(或 > target)。唯一的区别在 if 条件的 < vs <=——这一个字符的差异决定了边界落在哪一侧。LeetCode 34(查找元素首末位置)跑两遍 bsearch_lower + bsearch_upper 即可;LeetCode 35(搜索插入位置)直接返回 bsearch_lower 的结果。
各语言标准库对比
| 语言 | 静态数组 | 动态数组 | 说明 |
|---|---|---|---|
| C | int arr[10] | malloc + realloc | 无内置动态数组,需手动管理 |
| C++ | std::array<int, 10> | std::vector<int> | vector 保证连续存储 |
| Java | int[] arr = new int[10] | ArrayList<Integer> | 固定数组大小,扩容通过 List |
| Python | array('i') 或 [0]*10 | list | Python list 本质是动态指针数组(并非纯 int 数组) |
| Rust | [i32; 10] | Vec<i32> | 静态数组大小编译时确定 |
| Go | [10]int | []int(slice) | slice 是底层数组的视图+长度+容量 |
Go Slice:动态数组视图的最小完整模型
Go 的 []int 值得单独一提,因为它是”数组视图”的最小完整模型——一个 slice 在底层只是三元组:
type slice struct {
    ptr *int  // 指向底层数组某一段的开头
    len int   // 可见元素个数
    cap int   // 从 ptr 到底层数组末尾的剩余容量
}
s[a:b] 切片不拷贝数据,只是构造新的三元组共享同一段内存。这带来两个经典陷阱:
- 别名效应:两个 slice 共享底层数组时,通过其中一个写入,会从另一个里”凭空”显现;
- append 的隐式换底:cap 不足时
append分配新数组并整体迁移,此后的写入不再与旧 slice 共享——同一个变量在 append 前后行为悄然改变。
理解了 slice 就理解了”动态数组 = 视图 + 扩容协议”的全部要点:Rust 的 &[T] 是同款视图语义;Python 的列表切片则相反(返回拷贝而非视图),对比着学印象最深。
应用场景
- 排序与查找的载体:八大排序的操作对象就是数组(I_排序_八大排序_Sorting),二分查找、前缀和更是直接以有序/静态数组为前提——本章”经典算法”节是它们的地基
- 查找表(Lookup Table):用下标做 O(1) 映射——CRC 校验表、三角函数近似、Unicode 属性表、预计算常量
- I/O 缓冲区:操作系统用大数组作为内核态↔用户态的 DMA 缓冲区,网卡驱动程序用环形缓冲区数组存储待发送/待接收的数据包描述符
- GPU 缓冲区对象:VBO(顶点缓冲对象,vertex buffer object)存储顶点位置/颜色/法线,以数组形式连续排列以便 GPU SIMD 单元并行处理
- 稀疏结构的稠密载体:CSR 稀疏矩阵的三个数组(values / col_index / row_ptr),堆的完全二叉树数组表示
- B 树/数据库页:B 树节点本身就是固定大小的数组(一个节点内按 key 排序的数组),对应磁盘上的 4KB / 8KB 数据页
练习
| 题号 | 题目 | 难度 | 知识点 |
|---|---|---|---|
| 26 | 删除有序数组中的重复项 | 入门 | 原地修改、快慢指针 |
| 27 | 移除元素 | 入门 | 原地修改、快慢指针 |
| 283 | 移动零 | 入门 | 双指针 + 原地修改 |
| 88 | 合并两个有序数组 | 入门 | 逆向双指针 |
| 704 | 二分查找 | 入门 | 二分模板 |
| 303 | 区域和检索 - 数组不可变 | 入门 | 前缀和 |
| 34 | 在排序数组中查找元素的第一个和最后一个位置 | 中等 | 二分边界(lower_bound 变体) |
| 209 | 长度最小的子数组 | 中等 | 可变滑动窗口 |
| 167 | 两数之和 II - 输入有序数组 | 中等 | 对撞双指针 |
| 15 | 三数之和 | 中等 | 排序 + 对撞双指针 |
| 1109 | 航班预订统计 | 中等 | 差分数组 |
| 153 | 寻找旋转排序数组中的最小值 | 中等 | 二分变体(与 34 对比边界写法) |
| 54 | 螺旋矩阵 | 中等 | 行列边界收缩 |
| 42 | 接雨水 | 困难 | 双指针 / 前缀最大值 |
核心推演清单
以下三题为标准范围典型题型——合上答案先自己算,再对照解析。
题 1(二维数组地址计算):数组 (int,4 字节),首地址 2000,按列优先存储,求 的地址;若改为行优先,地址又是多少?
列优先时, 前面有完整的 3 列(每列 共 9 个元素)加本列上方的 4 个:
行优先则是 → 。两种布局都算一遍正是本题的要点——行列数不同时,两种优先级的偏移量没有对称关系。
题 2(对称矩阵压缩):10 阶对称矩阵按下三角(含对角线)行优先存入 ,求 存放的下标 。
,属于上三角元素,取其对称元 :
陷阱提醒:直接套 是错的——那个公式只在 时成立。
题 3(三对角矩阵压缩):6 阶三对角矩阵带状压入 ,求 的下标与压缩后的总元素个数。
属于带内:;总个数 。
若题目问的是 (),答案是”带外零元不占存储、无下标”——这是第二个常见陷阱。
动手实验
| 编号 | 题目 | 说明 |
|---|---|---|
| E1 | 行优先 vs 列优先遍历耗时对比 | 分配一个 10000×10000 的 int 矩阵,分别按行优先和列优先遍历并计算所有元素的总和。用 clock_gettime(CLOCK_MONOTONIC) 计时,用 perf stat -e cache-references,cache-misses 统计缓存行为差异 |
| E2 | 大数组首次访问的缺页分布 | 分配一个 512MB 的 int 数组(malloc),计时 memset 全部字节为 0 的耗时。再用 perf stat -e page-faults 统计实际缺页次数,与理论值 次缺页对比。第二次 memset 看看缺页次数是否归零 |
| E3 | 缓存块大小探测 | 编写程序在不同步长(stride = 1, 2, 4, 8, 16, 32, 64, 128)下遍历数组并计时。用曲线图分析:步长 ≤ 16(即 64 字节以内)时性能几乎不变(同一条 cache line),步长 > 16 后每次访问的耗时骤然上升。结合 L1/L2/L3 大小解释性能阶跃 |
| E4 | 真二维数组 vs 指针数组 | 分别用平坦数组(int* data = malloc(rows*cols*sizeof(int)))和指针数组(int** rows = malloc(rows*sizeof(int*)))实现矩阵乘法 ,尺寸为 。计时比较并解释差距来源(cache miss 率 × 间接寻址开销) |