建议先阅读: 线性表与顺序表 — 建立线性表 ADT 与两种存储实现的全局观;容器概览 — 理解连续存储 vs 节点存储的本质分歧。
本章正文按考纲和通用教材的口径讲实现;标注【延伸】的小节(数学视角、深入底层)属于拓展内容,只准备考研或期末的同学可以先跳过,第二遍再回来看。
本章结构:从零理解(指针 / 头结点)→ 原理 → 深入底层 → 实现 → 高频考点(含真题)→ 扩展 → 各语言 → 应用 → 练习 → 动手实验。新手建议从「从零理解链表」顺序读;复习可直接跳到「高频考点」。
从零理解链表
为什么需要链表
数组有一个致命缺陷:大小固定。声明 int arr[100] 后,要么浪费 90 个空间,要么第 101 个数据放不下。即使使用动态数组(realloc),扩容时需要复制整个数组到新地址,代价是 。
链表解决了这个问题:每个节点独立分配,需要多少就加多少,不需要时就删除。代价是失去了按下标随机访问的能力——鱼和熊掌不可兼得。
什么是指针
在 C 语言中,变量存储在内存的某个地址上。指针就是存储地址的变量。
int x = 42;       // x 存储在地址 0x7fff5a3b,值为 42
int* p = &x; // p 存储了 x 的地址,即 p 指向 x| 概念 | 类比 | 说明 |
|---|---|---|
| 变量 | 房间 | 存储数据的内存空间 |
| 地址 | 房间号 | 内存中每个字节的唯一编号 |
| 指针 | 纸条上写的房间号 | 存储地址的变量,通过它能找到对应的房间 |
为什么链表节点需要指针
链表节点散落在堆内存的不同位置(不像数组那样连续存放)。要找到下一个节点,就必须知道它的地址。指针就是”通往下一个节点的地图”。
| 节点 | 物理地址 | data | next 指向 |
|---|---|---|---|
| A | 0x1000 | 1 | 0x3000(节点 B) |
| B | 0x3000 | 2 | 0x2000(节点 C) |
| C | 0x2000 | 3 | NULL |
注意:节点在内存中的物理地址是 0x1000 → 0x3000 → 0x2000,不是连续的!这就是链表与数组的根本区别。
为什么新节点的 next 是 NULL
当你创建一个新节点时,它还不属于任何链表。此时它的 next 指针没有意义的目标,所以设为 NULL 表示”没有后继”:
SNode* new_node = malloc(sizeof(SNode));
new_node->data = 42;
new_node->next = NULL;   // 还没链接到任何链表,先标记为"无后继"
NULL 是一个特殊值(通常为 0),表示”这个指针不指向任何有效内存”。链表尾节点的 next 也是 NULL,表示”后面没有节点了”。
头指针:链表的入口
整条链表只需要一个入口——头指针 head。通过 head 可以找到第一个节点,通过第一个节点的 next 可以找到第二个节点,以此类推。
SNode* head = NULL; // 空链表:head 指向 NULL空链表的 head == NULL,就像一个空的电话本——里面没有任何条目。
创建链表的时候,头指针必须初始化为空,如果不初始化会被分配随机垃圾值,在链表的结构里,头指针为空意味着这是一个空表,如果不为空,代表链表里至少有一个节点,如果不初始化,那么程序会误认链表不为空,去访问那个垃圾值,导致程序崩溃
带头节点
有些链表会额外增加一个头节点,也叫虚拟节点,
这个时候头指针指向头节点,它不为空
空链表的时候 head->[dummy|NULL]
这个时候头指针也不为空,所以头节点的next是NULL
当带头节点的时候,判断空链表看的是head->next == NULL
而不是head == NULL
下面简单展示不带头结点和带头结点创建链表的代码主要区别
Lnode *init(){
	Lnode *head=(Lnode*)malloc(sizeof(Lnode));
	head->next=NULL;
	return head;             //这是带头结点的
}

Lnode *init(){
	return NULL;               //这是不带头结点的
}

//在使用的时候直接这样用:
Lnode *head=init();
可以直观看到,在创建链表的时候,带头结点会优先创建一个节点,并分配节点指向空指针。
而不带头结点则直接返回空指针。意味不创建任何节点。
不带头结点的初始化如果要创建指针要动态分配内存,使用malloc函数,实际上,无论是否带有头结点,在后续增加节点都要动态分配内存。
-----------------------这里选读吧,算是多种用法延伸---------------------------------
当然,写法不止这一种,讲一下偏向逻辑方向的初始化理解,满足条件的才广义上都可以称之为初始化。
在Lnode * head的时候定义了一个头指针,此时头指针没有初始化,是一个野指针。
可以直接对其赋值head=NULL;使其为空
也就是这样的操作:
Lnode *head=NULL;创建了一个指向链表的指针,并设定指针为空。换句话说,就是创建了一个链表,带有头指针,但是这个链表没有任何节点。是一个完全的空链表,但是有头指针。
我们创建了一个链表的头指针,虽然这个链表里面什么节点都没有,但是有头指针存在,意味着我们创建了这样一个链表,且头指针为空,意味着我们初始化了。
所以这个是满足初始化操作的,且同时创建链表了。
因此,只要满足,创建链表的头指针,并对其初始化,就算是一种链表的创建,且初始化。
那么我们就可以用二级指针的形式来创建不带头结点的链表,并初始化:
void init(Lnode**head){
  *head=NULL;
}

Lnode *head;
init(&head);
解释:假设有一个头指针也就是Lnode* head,
在函数里Lnode** head是指向指针的指针。在函数体内,head就是这个Lnode** 的类型,指向Lnode* 指针的指针类型。而* head是解引用操作,也就是* head,其实就是一个一级指针。所以
整个二级指针翻译过来就是,设定头指针指向NULL
还是Lnode * head=NULL的意思。
在带有头结点的初始化里,可以对不带头结点的方式进行延续,也就是,创建头指针,创建节点,头指针指向节点,节点指向空。
在逻辑上满足要素,有头指针,头指针指向东西,也满足带头结点的定义,有节点,节点为空,被头指针所指向。
Lnode *head;
Lnode*L=(Lnode*)malloc(sizeof(Lnode));
head=L;
L->next=NULL;
在一般初始化操作里,大多习惯讲头指针和头结点捆绑在一起,直接用一个head,head本身被头指针所指,且自身是头结点。
将创建头指针,在堆上分配内存创建节点,头指针指向节点三个步骤合为一体
比如:
Lnode* head=(Lnode*)malloc(sizeof(Lnode)); //该步骤将三个步骤合为一体
head->next=NULL;满足下面定义,头指针不为空,头结点下一位为空。头指针的值就是头结点的地址
head!=NULL;
head->next=NULL;
所以我们依然可以用二级指针来实现链表初始化:
int InitWithHead(Lnode **head) {
    *head = (Lnode*)malloc(sizeof(Lnode));
    if (*head == NULL) {
        return -1;
    }
    (*head)->next = NULL;
    return 0;
}

//使用:
Lnode *head;
InitWithHead(&head);
和不带头结点的二级指针初始化是一样的,中间多带了一个使用malloc()函数从堆上分配地址。也就是创建节点。
--------------------------------------------------------------------------------------------------------------
带不带头结点效果和使用上的区别主要集中在边界操作上:
比如空表判断:
带头结点判断head->next是否为空
不带头节点判断head是否为空
在头插,删除第一个节点的时候:
带头结点操作统一,不需要修改头指针
不带头结点的需要修改头指针,返回新的头指针
这里额外说一下,不带头节点可以,但是不带头指针的链表很难实现,基本不行
讲一下带头结点和不带头结点进行头插的区别:
1带头结点:
因为带头结点了,head(头指针)与开始的虚拟节点绑定,该虚拟节点和头结点始终位于链表第一位。因此进行头插的意思就是在头节点后面插入一个新的节点。所以操作相对容易理解:
设定新节点指向头结点下一位(假设下一位名字叫作下一位节点),再设定头结点指向该节点,做到链表由
头结点->下一位节点变为头结点->新节点->下一位节点从而实现插入
//假设s是新的节点,就是要插入的节点。head是头节点
s->next=head->next;
head->next=s;
2不带头节点:
在没有头节点的情况下,头指针head是一个独立的指针,作为链表上的检查员,会移动变化。不会一直在第一位,头指针在正规情况下是在第一位的,也就是说在情况结束的时候会在第一位,在中途创建中会移动,会指向其他,会随着被指向对象的移动而移动。那么要想实现头插入,则需要经过一个绕弯子:
让新节点指向头指针,因为头指针是指向的变化前第一位(称呼为旧一位)所以经过定向,新节点会指向旧一位,在将头指针绑定在新节点上,使其变成新一位。
如:
一开始:     引入新节点:                重新绑定头指针:

   head              head              head
    |                   |                |
  旧一位      新节点-> 旧一位             新节点->旧一位
代码如下:
s->next=head;
head=s;
ps:有些同学点出不理解为什么是head=s而不是head->next=s。这里解释一下:
头指针不是节点,头指针等于什么那就说明头指针在谁身上,假如是head->next那么其实是头指针目前该节点(就是旧一位)的下一位。head->next=s,就等于旧一位的下一位等于新节点,这就造成了一个链表有环的现象,这通常是一个BUG,不是正常意义下的循环链表
关于带不带头节点的头删
也就是删除第一个节点。
有了上面的例子,相信有些人可以逆向理解出来头删的区别了。
带头节点的直接指定头结点重新指向下一位,删除引入的新节点。
而不带头节点的则需要让头指针指向下一位,然后删除第一位。
但是需要注意的是,在执行删除的时候,一般使用free()等操作,释放空间,删除指针,所以需要定义指针。比如你要删除一个指针,你就需要创建一个指针p=它, 然后free(p)
代码如下:
p=head->next;         //这是带头节点的
head->next=p->next;             //p->next其实是p->next->next也就是旧一位
free(p);

p=head;                //这是不带头节点的
head=head->next;       //头指针指向自身的下一位,也就是自进一位。和顺序表不一样,不能直接++
free(p)
除此之外,尾删,尾插完全一样,带不带头结点只影响开头的情况。
一些关于链表的表示还有名词解释
比如: head->[10|NULL] 这里head表示头指针,里面存的是节点地址,->是指向的意思,
[10|NULL]表示一个节点,[]方框内表示一块节点占据内存(也可以直接说是节点空间)
|中间的竖线,左边是数据域,内容是10,右边是指针域,指针是NULL
数据域存储实际的数据值,指针域存储下一个节点在内存中的地址
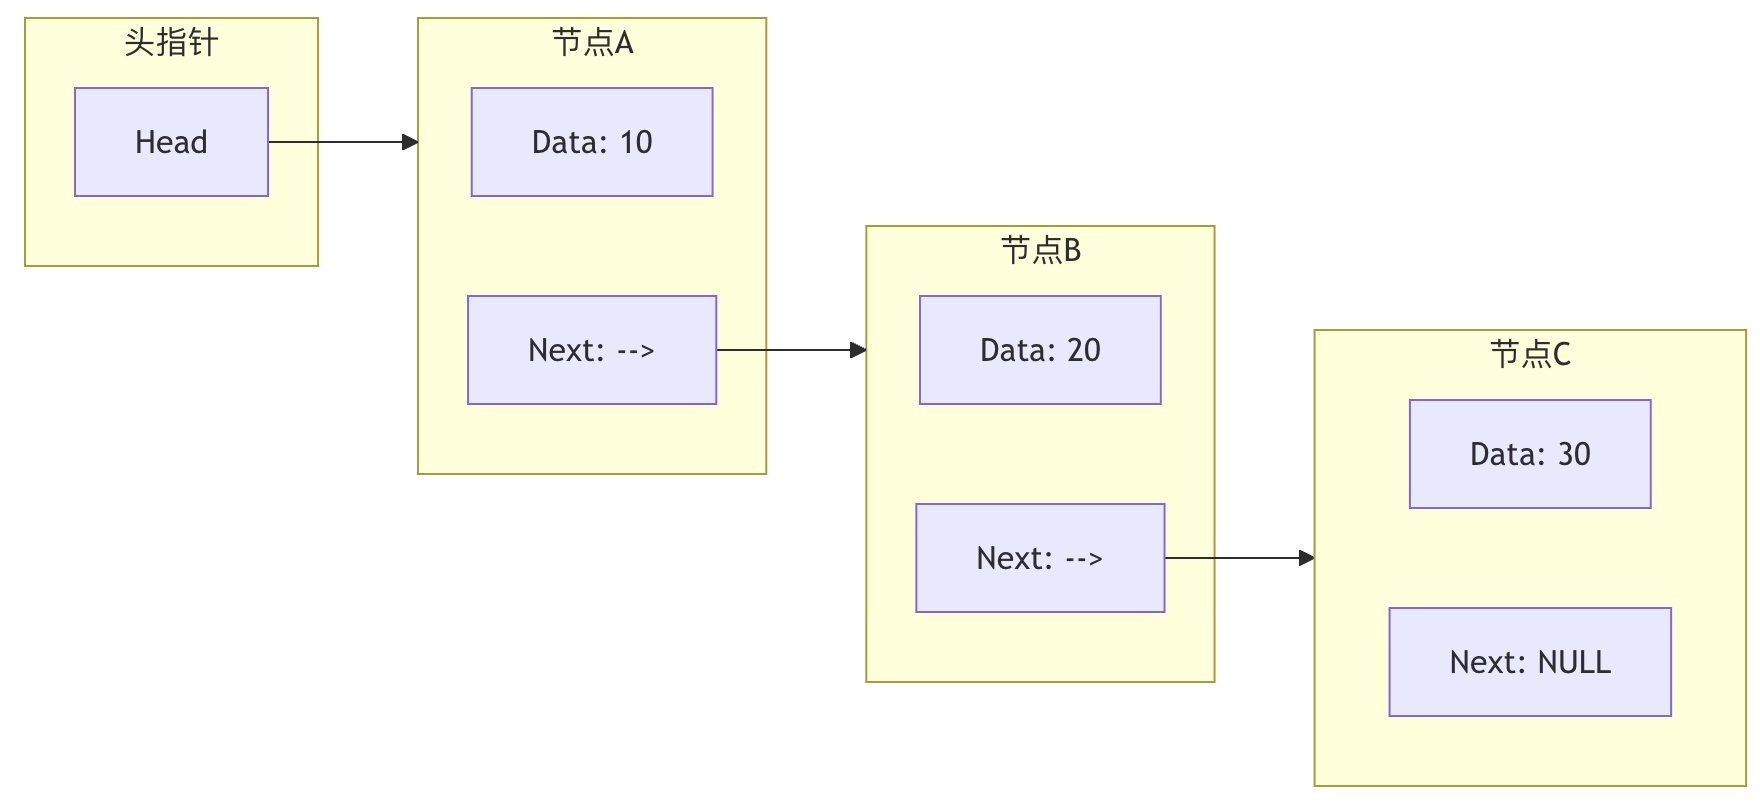
实际上画图可以如上图所示,head->[data|next]是对上图的抽象化演示
在设置多个节点的时候,可以这样表示:head -> [10|* ] -> [20|* ] -> [30|NULL]
头指针入口放在第一位,最终节点的下一位指针必须是NULL
最小实现:单向链表
这是没有头节点的,感兴趣可以尝试一下带头结点的单向链表实现。
节点定义
typedef struct SNode {
    int data;            /* 数据域:存放结点的值 */
    struct SNode* next;  /* 指针域:存放下一个结点的地址;尾结点为 NULL */
} SNode;链接存储的存储空间分为两部分:数据域存放结点的值,指针域存放结点之间的关系。单链表每个结点额外带一个指针,存储密度小于 1;顺序表只存数据,存储密度为 1。
为什么 next 的类型是 struct SNode*? 因为在结构体定义内部,编译器还不知道 SNode 这个名字(它还没定义完),所以必须用 struct SNode* 完整写法。
创建节点
SNode* create_node(int value) {
    SNode* node = malloc(sizeof(SNode));  // 在堆上分配一个节点大小的内存
    node->data = value;                   // 设置数据
    node->next = NULL;                    // 新节点还没链接,先设为 NULL
    return node;
}
为什么用 malloc? 栈上的变量在函数返回时自动销毁。链表需要长期存活,所以必须在堆上分配。注意 malloc 有可能失败返回 NULL,实际工程里紧接着要做判空;这里的示例为了简短省略了它,但这是健壮性的一个典型检查点。
插入节点
void insert_after(Node* p,int x){
  Node* s = malloc(sizeof(Node)); //直接插入节点还是要创建节点,因此要分配内存
  s->data=x;         //设置数据
  s->next=p->next;  //因为链表只知道后位节点,因此只能将该节点的后位节点设置为要插入的那个节点的后位
  p->next=s;      //再将原先被插入位置的节点后位节点改为指向插入位置
}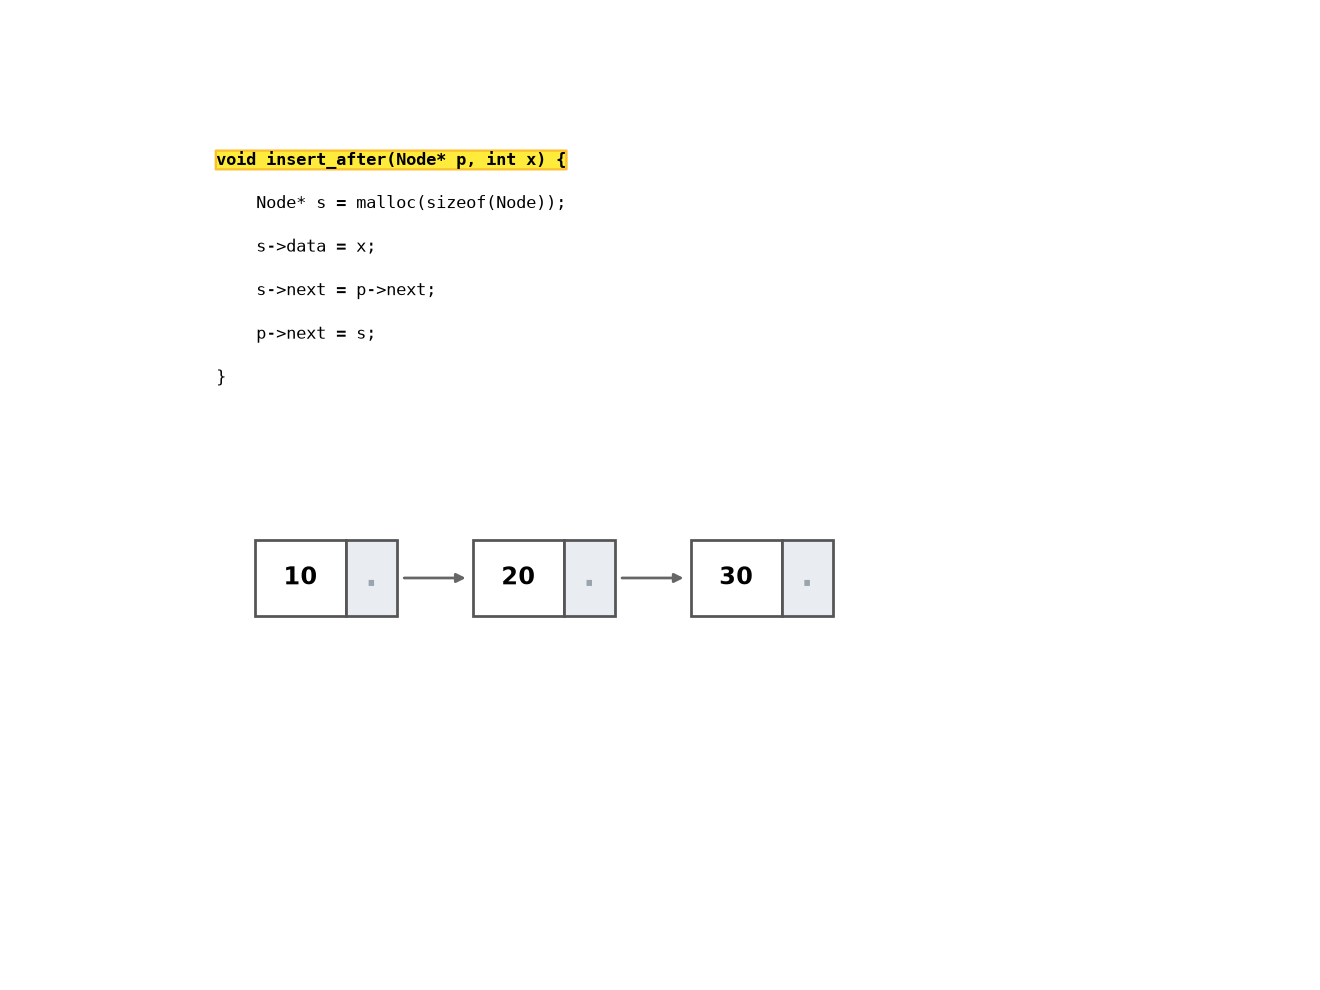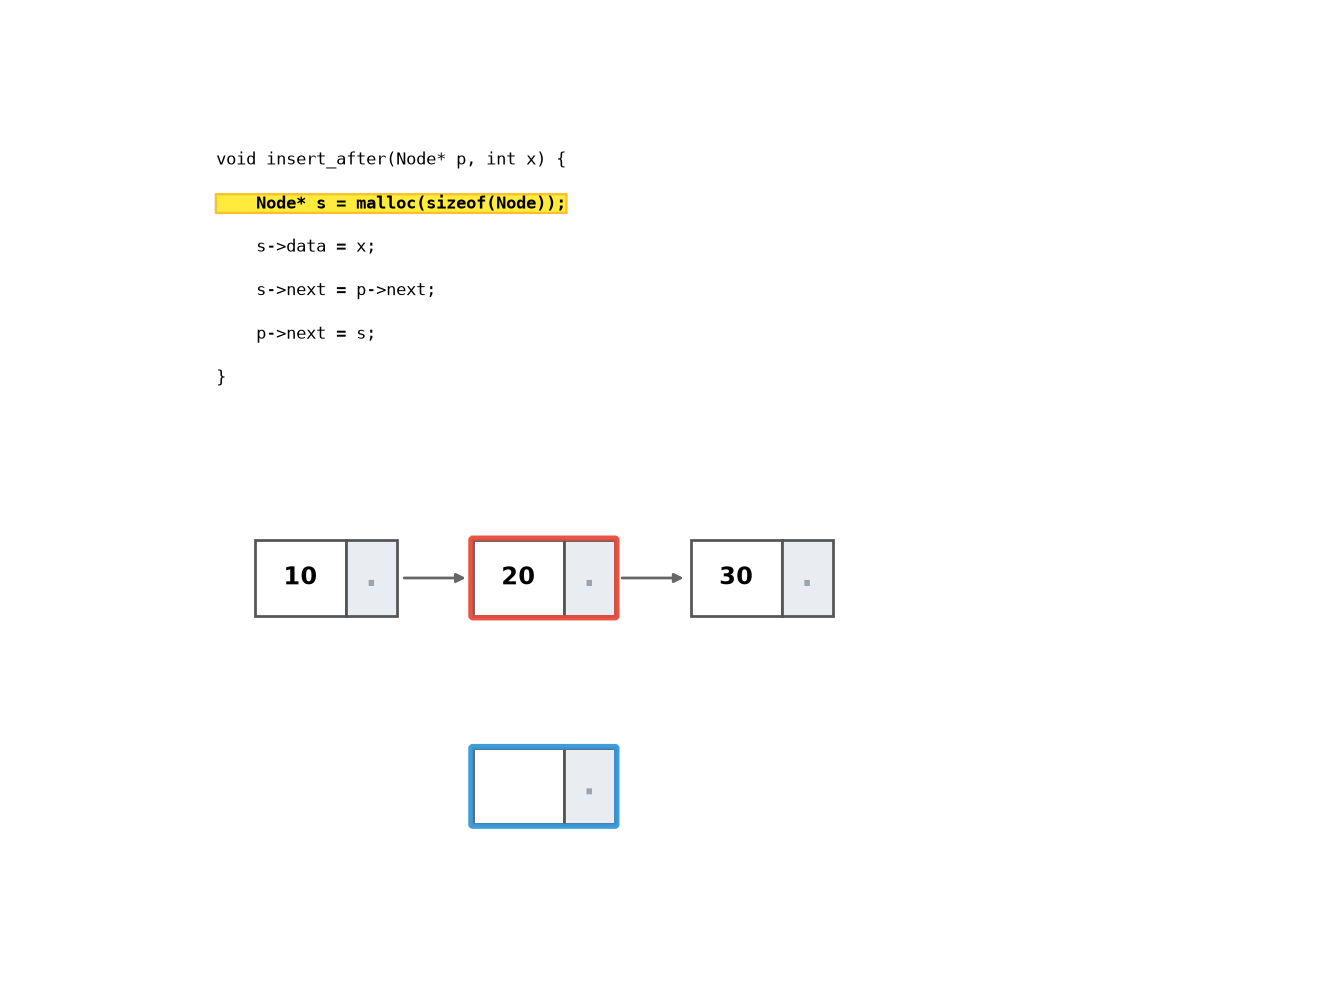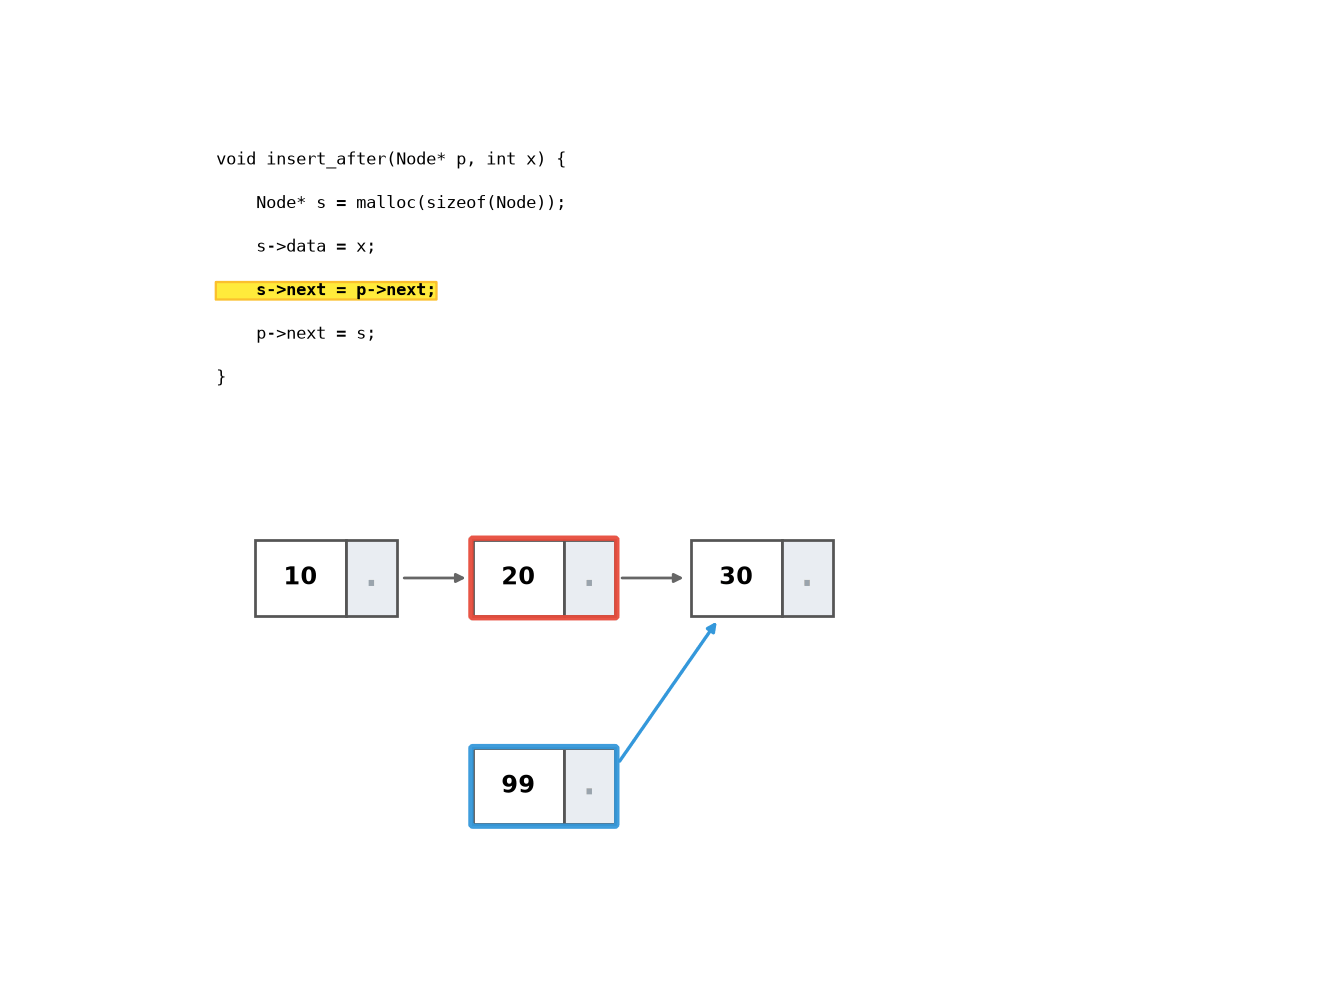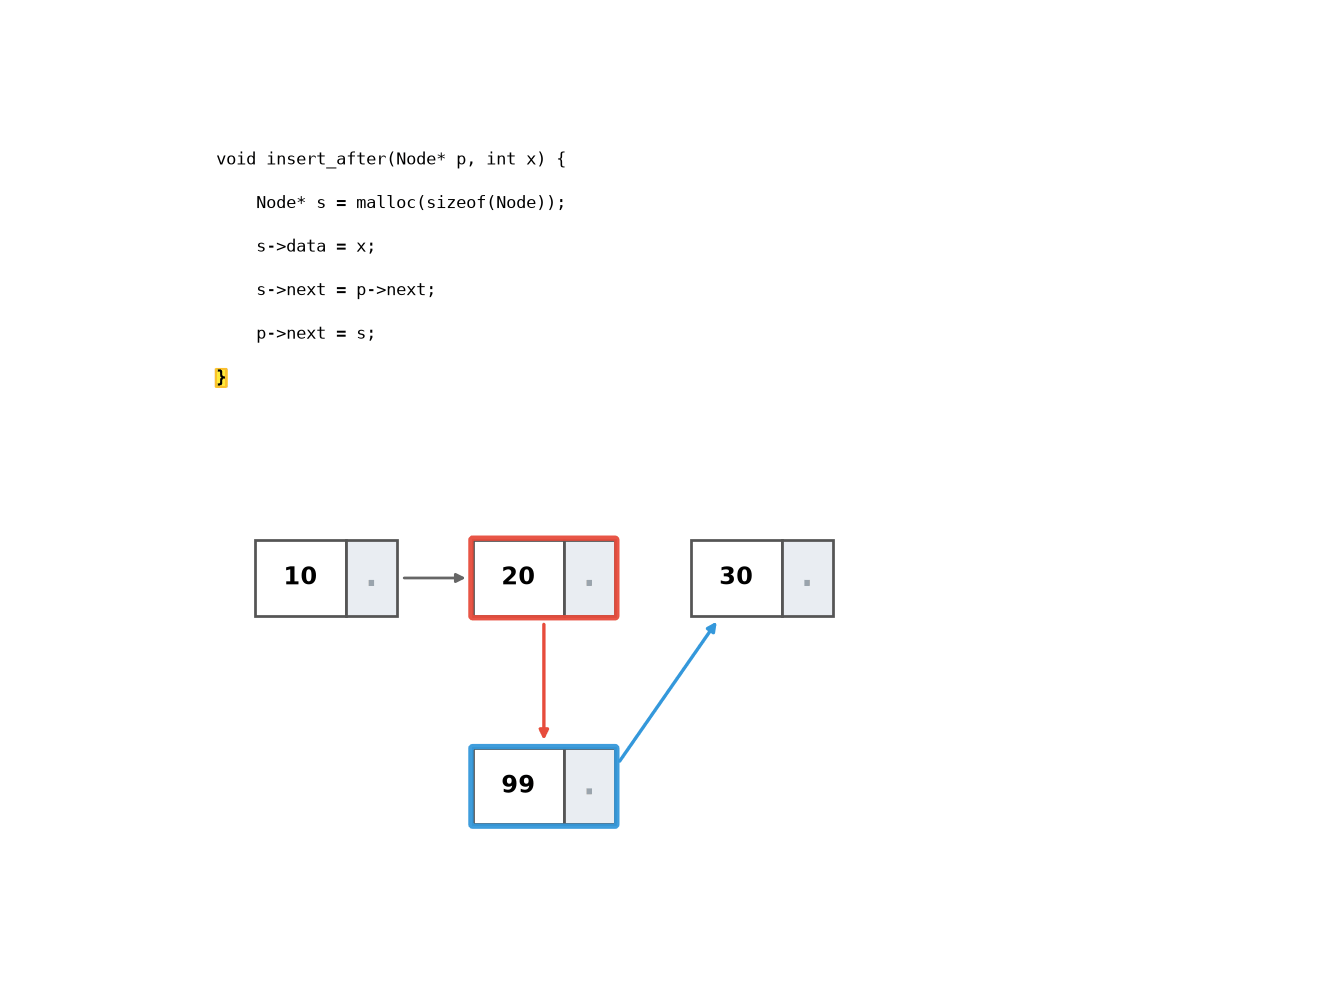
如图所示,你会看见,先创建一个节点,先让新节点指向原先的顺序指向的后一位节点,然后再将前一位节点指向新节点。
在节点 p 之后插入新节点 new:
void insert_after(SNode* p, SNode* new) {
    new->next = p->next;   // ① 新节点先指向 p 的后继
    p->next = new;          // ② p 再指向新节点
}
为什么顺序不能反? 如果先写 p->next = new,那 p 原来的后继地址就丢失了(new->next 还没指向它),链表就断了。
graph LR
    A["p"] -->|p->next| C["C"]
    A -->|"① new->next = p->next"| B["new"]
    B -->|"② p->next = new"| C
核心版本只改两条指针,前提是”p 一定存在,而且插入点不是表头”:
void insert_core(Node *p, int x) {
    Node *s = newNode(x);        //newNode()是创建节点

    并分配数据的函数
    s->next = p->next;
    p->next = s;
}
它处理不了”插到表头之前”——表头没有前驱结点,没法只靠 p->next 改到 head 本身。正规实现用二级指针接收头指针,把这种情况单独处理:
Status insert_at(Node **head, int i, int x) {
    if (i < 1) return ERROR;
    if (i == 1) {                 /* 插到表头:改的是头指针本身 */
        Node *s = newNode(x);
        s->next = *head;
        *head = s;
        return OK;
    }
    Node *p = *head;
    for (int k = 1; k < i - 1 && p != NULL; k++)
        p = p->next;              /* 找到第 i-1 个结点 */
    if (p == NULL) return ERROR;  /* i 超出表长 */
    Node *s = newNode(x);
    s->next = p->next;
    p->next = s;
    return OK;
}补充的部分解决了两个边界:i == 1 时改的是头指针,只能用 **head;p == NULL 说明位置超出表长,直接报错,避免解引用空指针。
删除节点
删除节点 p 之后的节点:
void delete_after(SNode* p) {
    SNode* victim = p->next;      // ① 先记住要删除的节点
    if (victim != NULL) {
        p->next = victim->next;   // ② p 跳过 victim,直接指向 victim 的后继
        free(victim);              // ③ 释放 victim 的内存
    }
}
为什么要先记住 victim? 因为 free(victim) 之后,victim 指向的内存已经无效。如果先 free 再读 victim->next,就是访问已释放的内存(use-after-free),属于未定义行为。
核心版本假设”待删结点一定存在,且删的不是表头”:
void delete_core(Node *p) {
    Node *q = p->next;
    p->next = q->next;
    free(q);
}
它删的是 p 的后继;碰到”要删表头”就无能为力——表头没有前驱。正规实现改成按值删除,把表头和找不到两种情况都处理掉:
Status delete_value(Node **head, int x) {
    Node *prev = NULL, *cur = *head;
    while (cur != NULL && cur->data != x) {
        prev = cur;
        cur = cur->next;
    }
    if (cur == NULL) return ERROR;        /* 目标不存在 */
    if (prev == NULL) *head = cur->next;  /* 删的是首元结点 */
    else prev->next = cur->next;
    free(cur);
    return OK;
}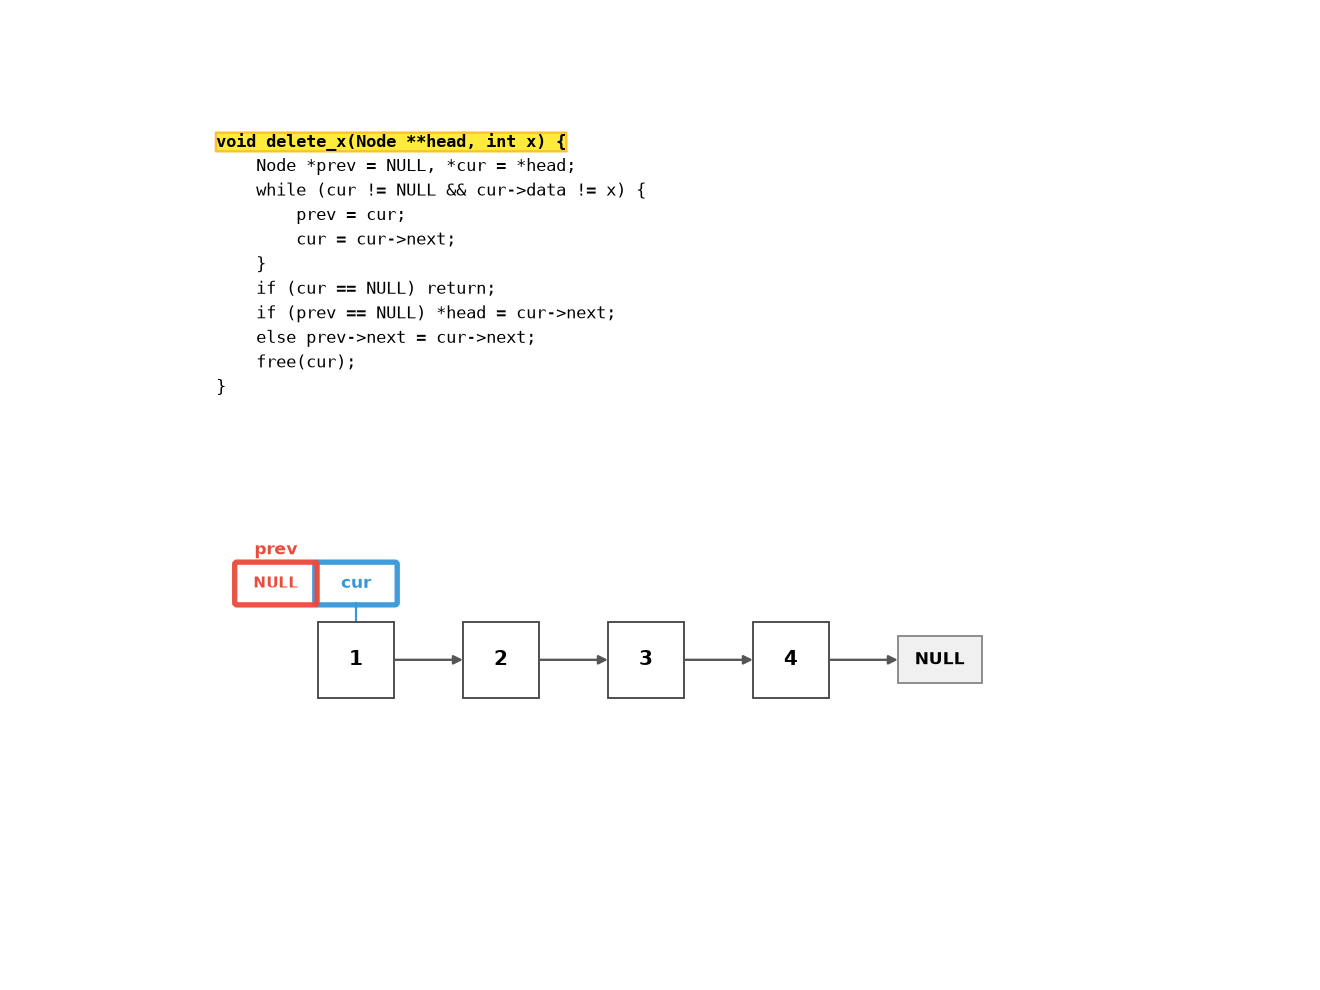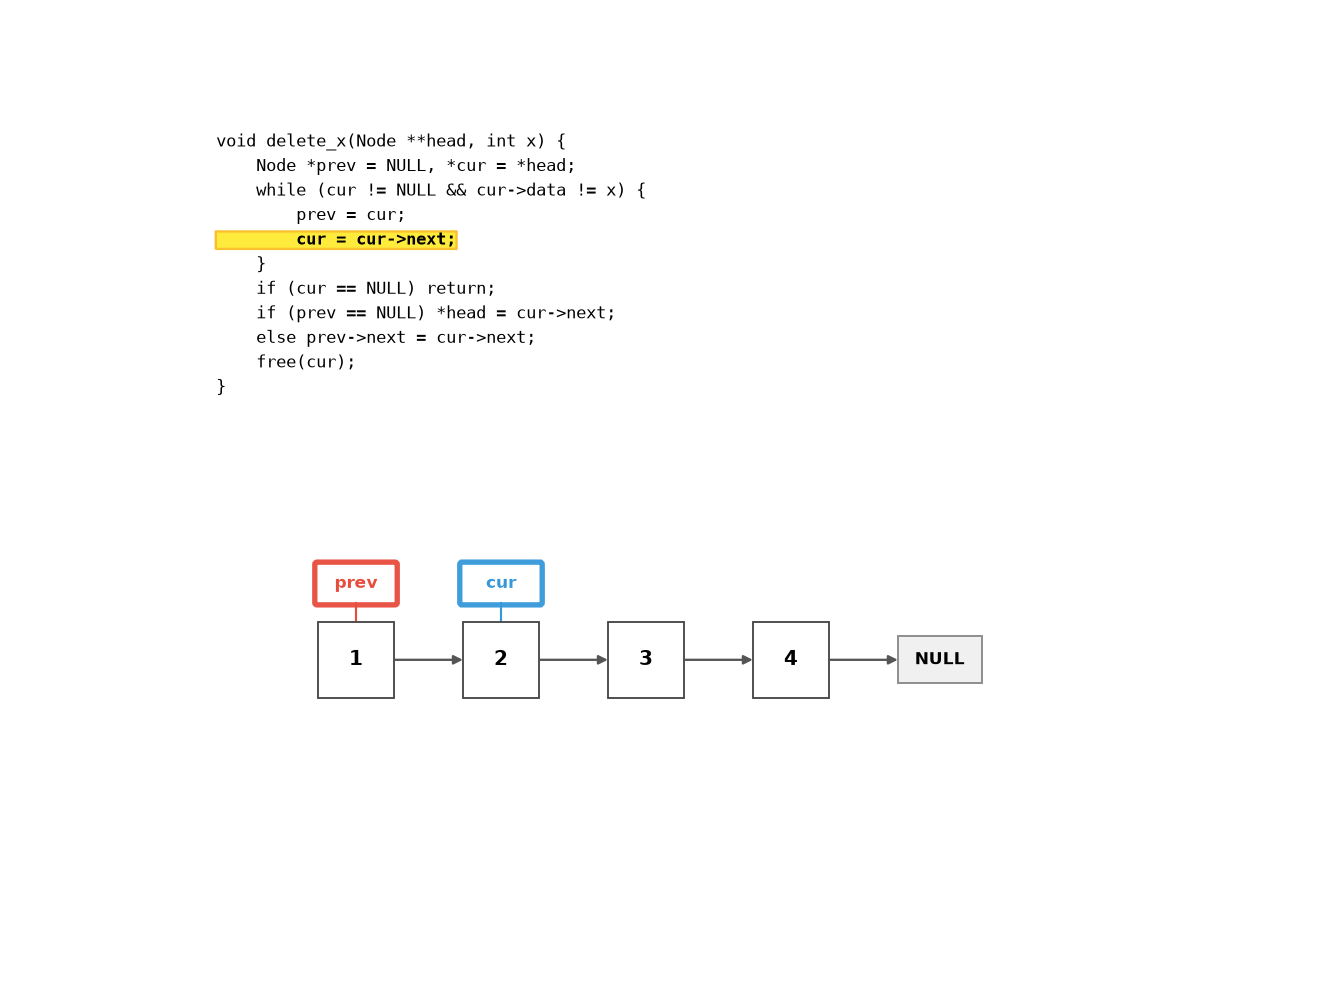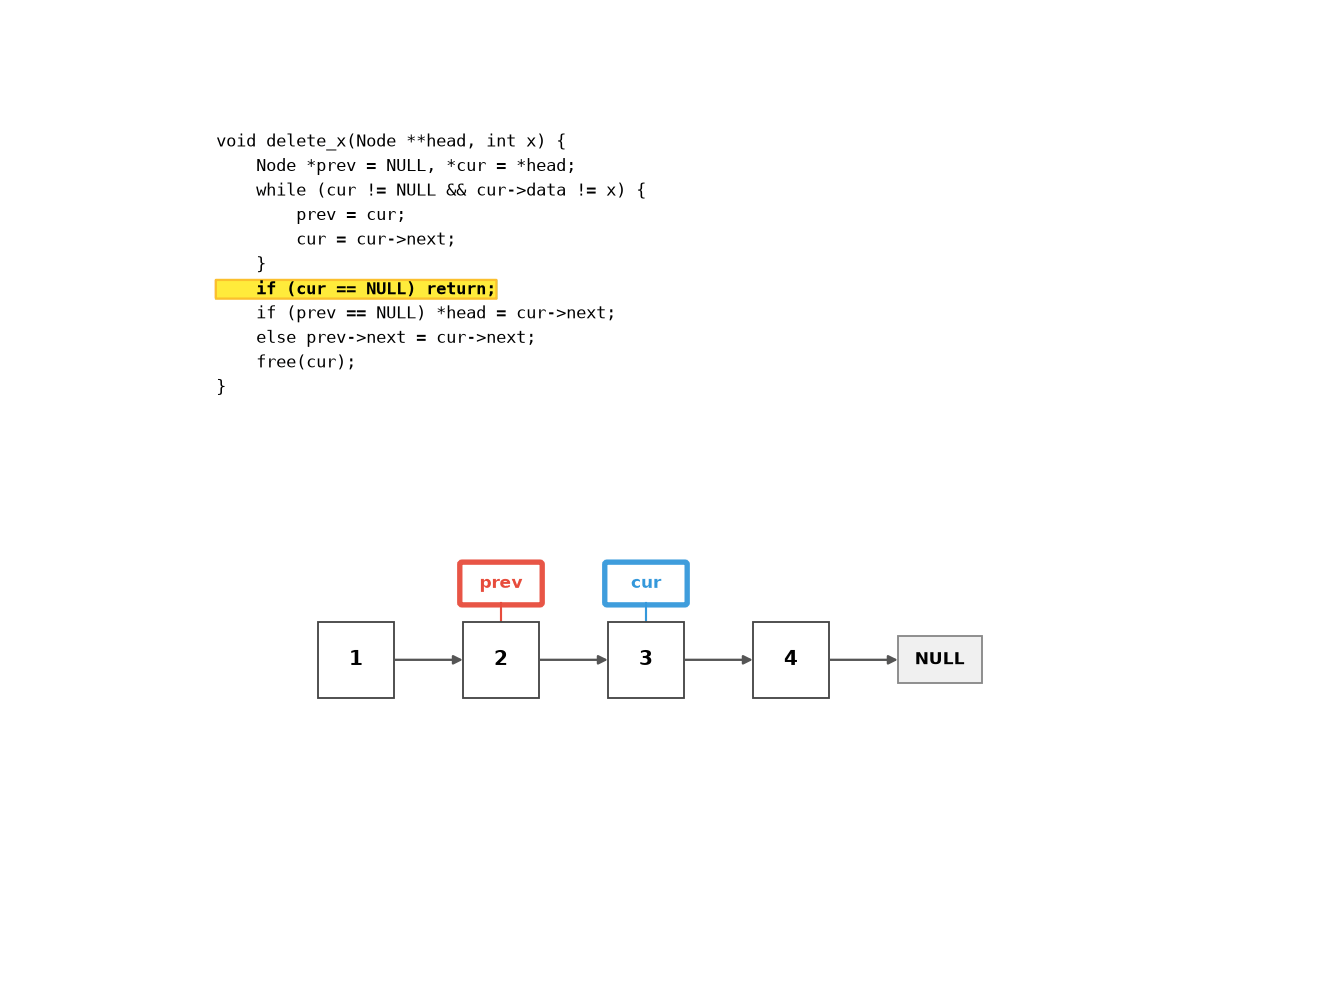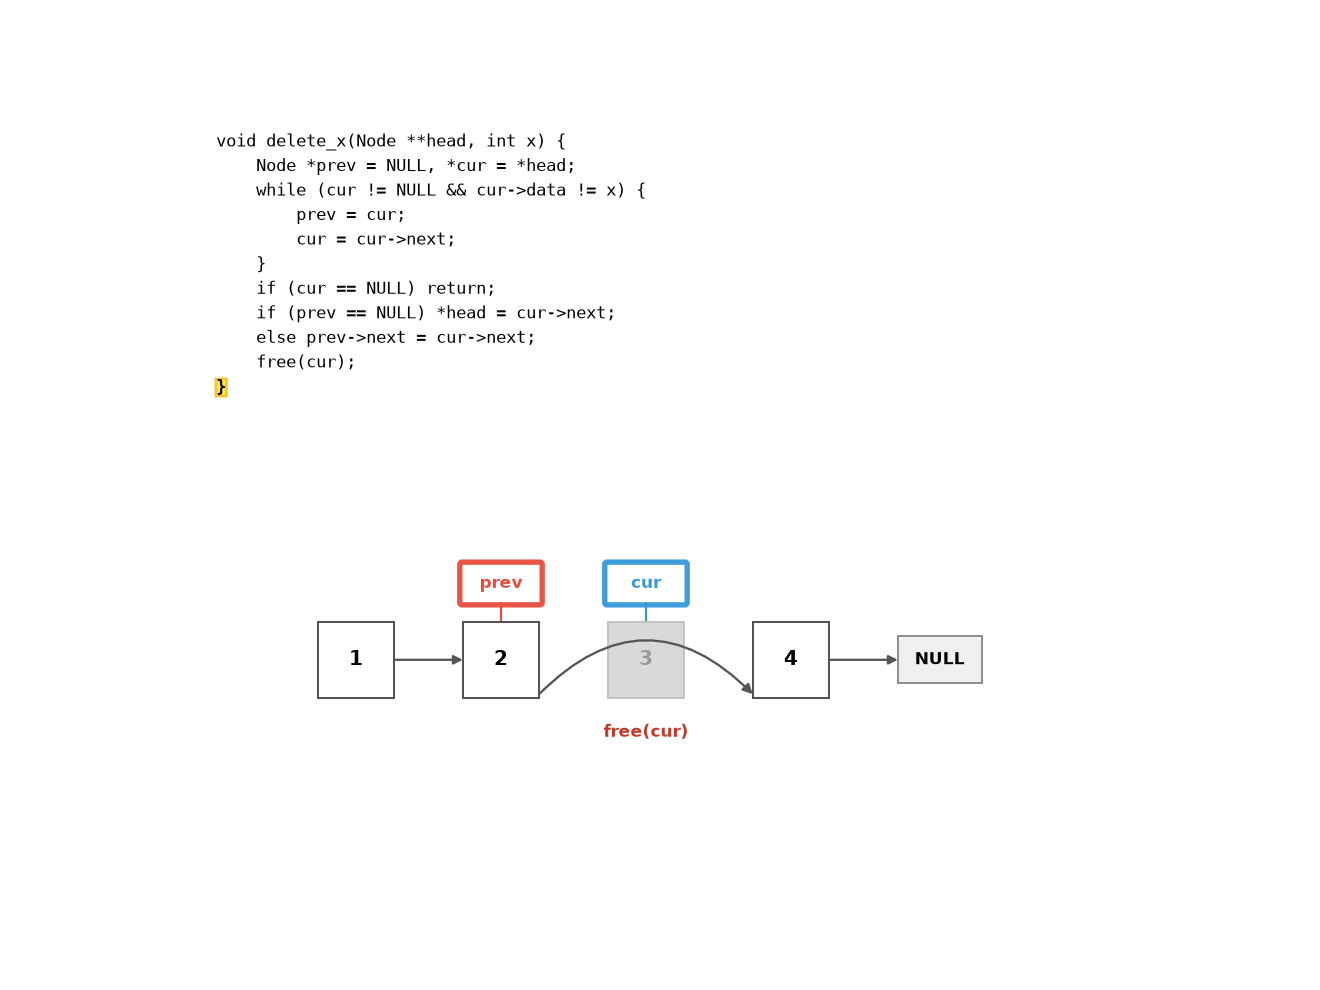
补充的部分:用 prev 记住前驱,才能让前驱”跳过”被删结点;用 **head 处理删表头;找不到目标时返回 ERROR,而不是继续往下走导致崩溃。
遍历链表
void print_list(SNode* head) {
    SNode* cur = head;           // 从头开始
    while (cur != NULL) {        // 直到 NULL(链表末尾)
        printf("%d -> ", cur->data);
        cur = cur->next;         // 移动到下一个节点
    }
    printf("NULL\n");
}核心版本就是一层 while,把”访问动作”直接写在循环里:
void traverse_core(SNode *head) {
    for (SNode *p = head; p != NULL; p = p->next)
        printf("%d ", p->data);
}
它的问题和顺序表一样:访问方式和遍历过程绑死,换成求和、统计、写文件就要重抄一遍。正规实现把”做什么”抽成函数指针:
void traverse(SNode *head, void (*visit)(int)) {
    for (SNode *p = head; p != NULL; p = p->next)
        visit(p->data);
}

/* 调用示例 */
void print_elem(int x) { printf("%d ", x); }
traverse(head, print_elem);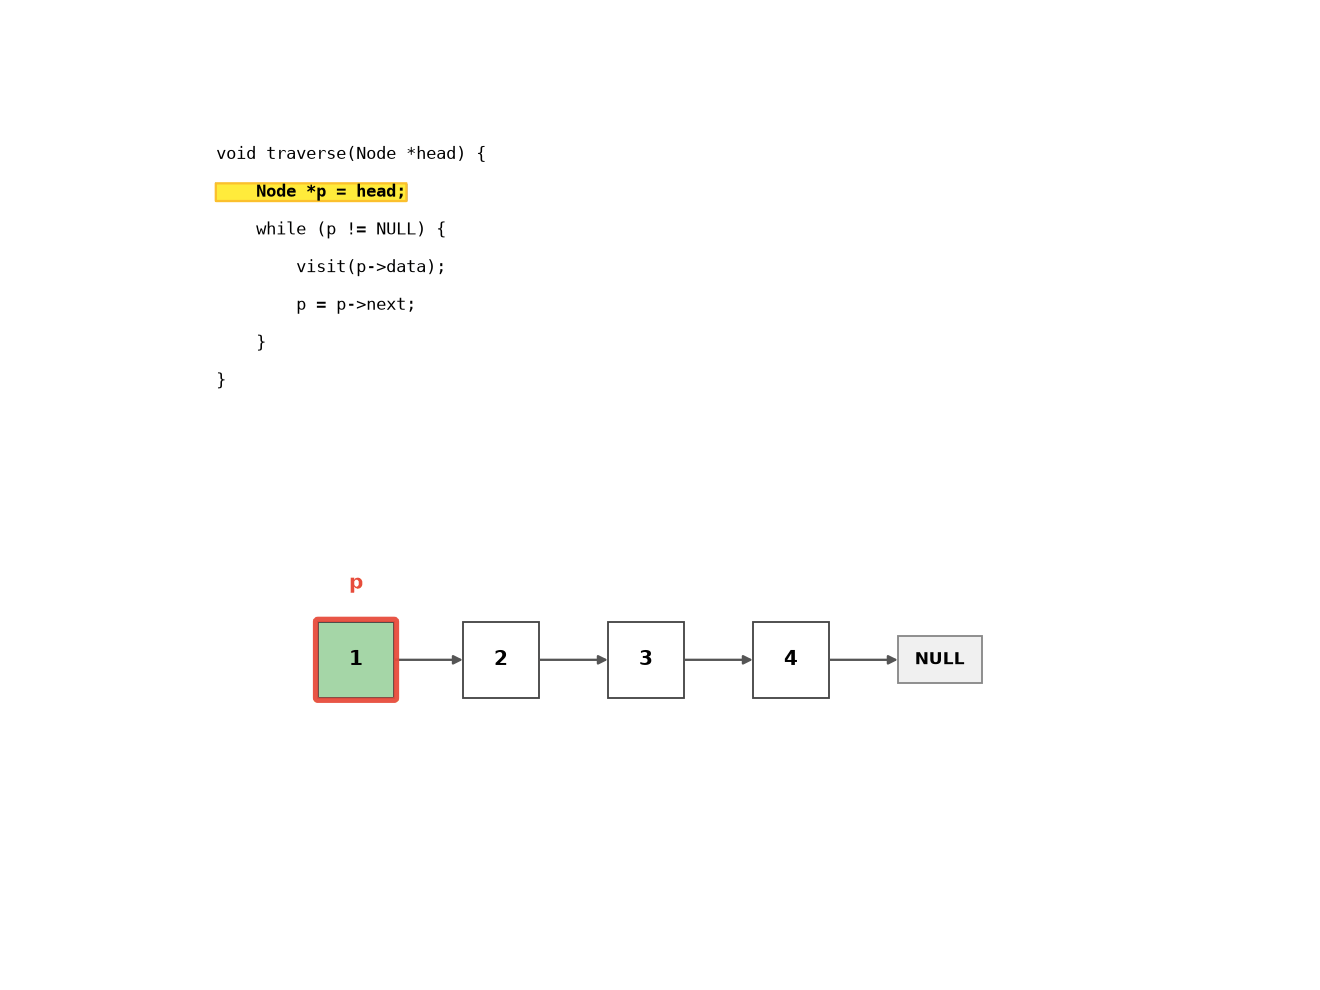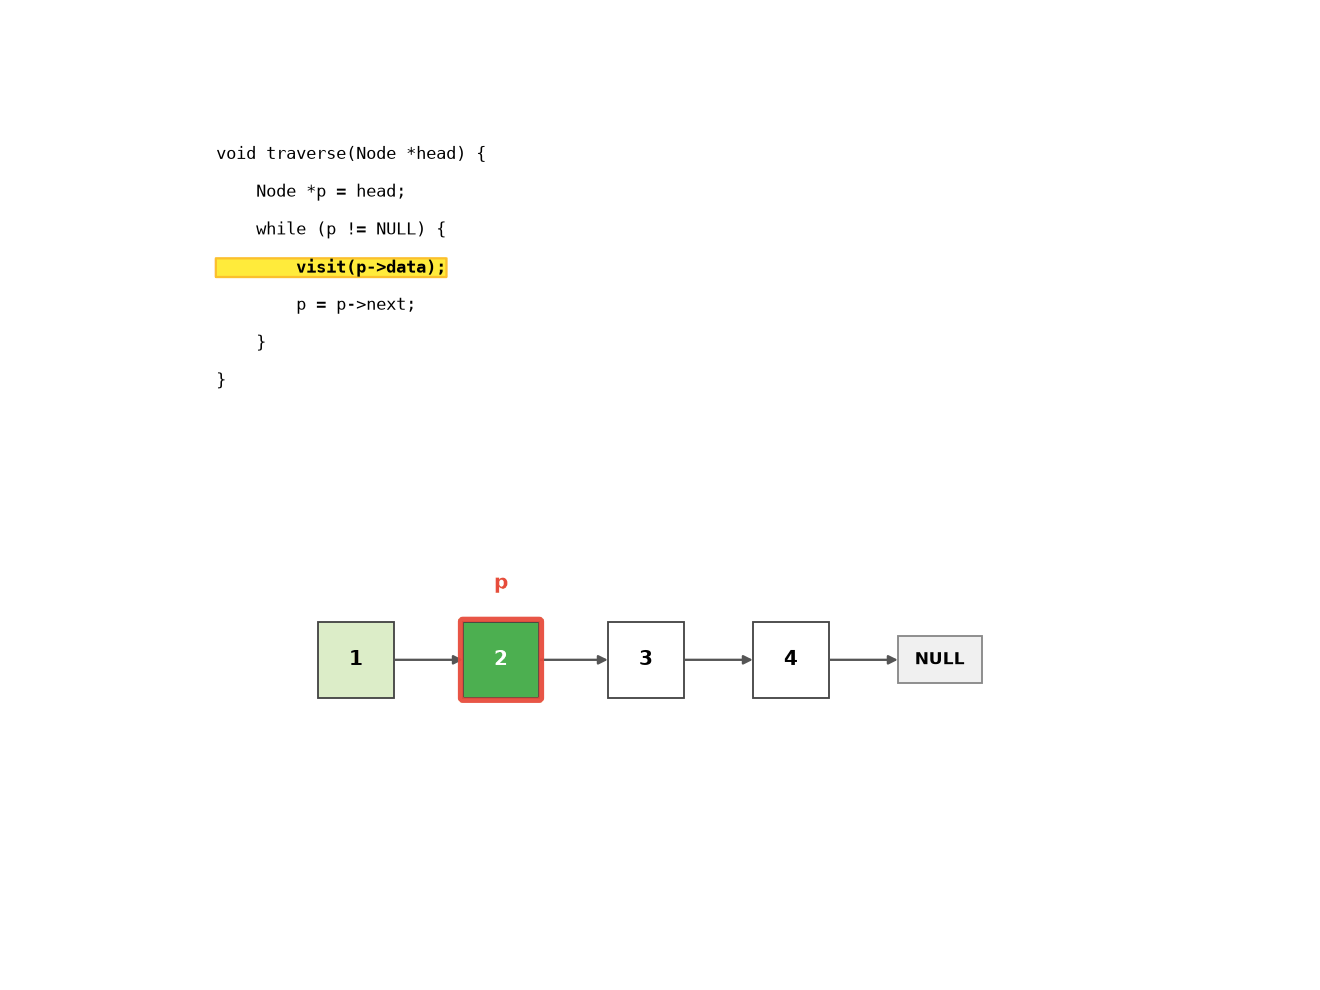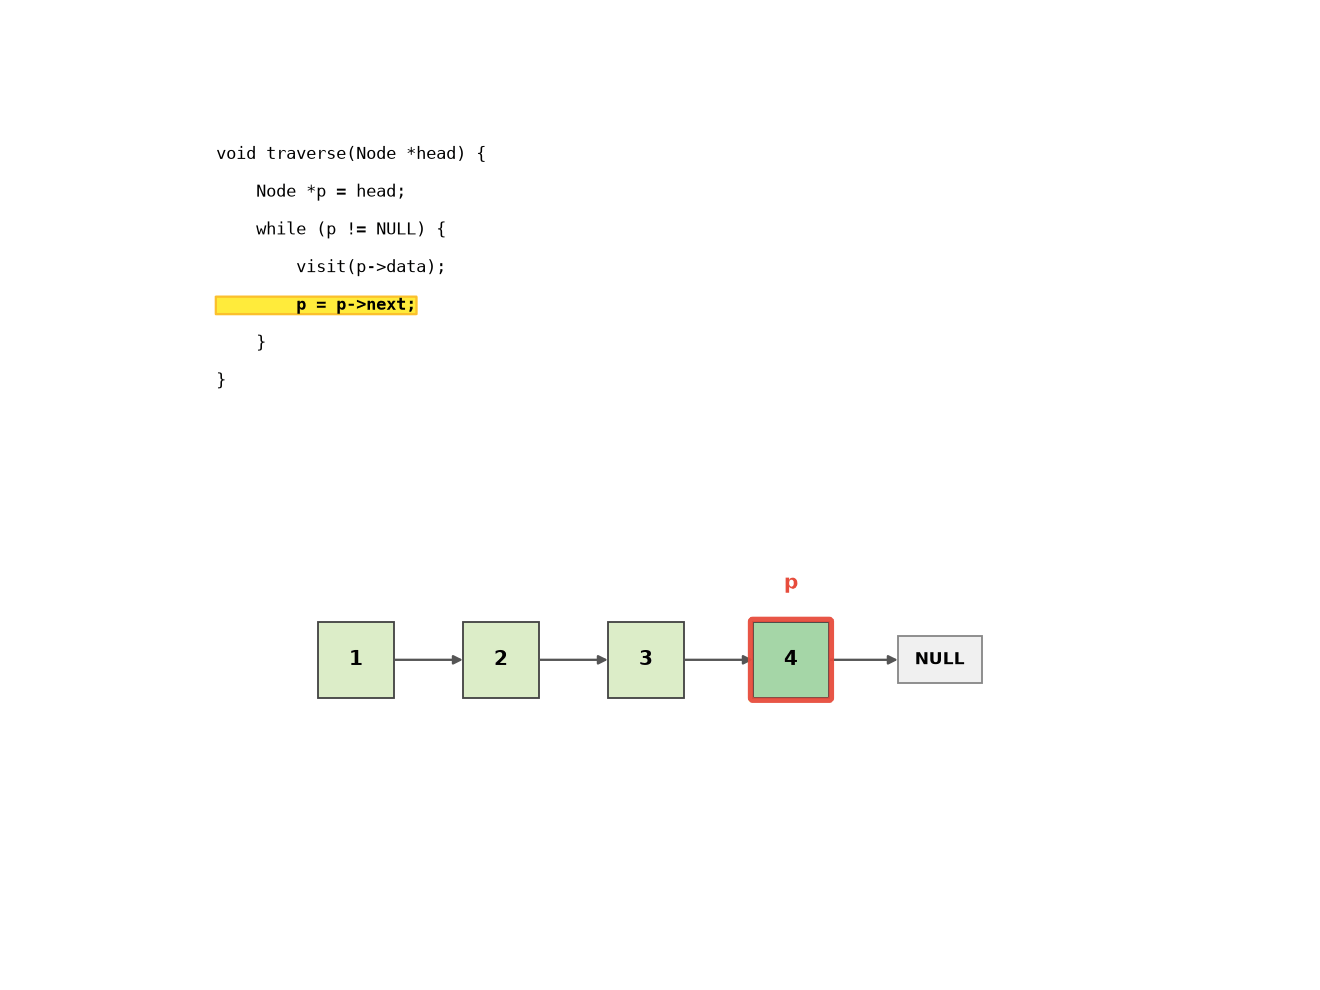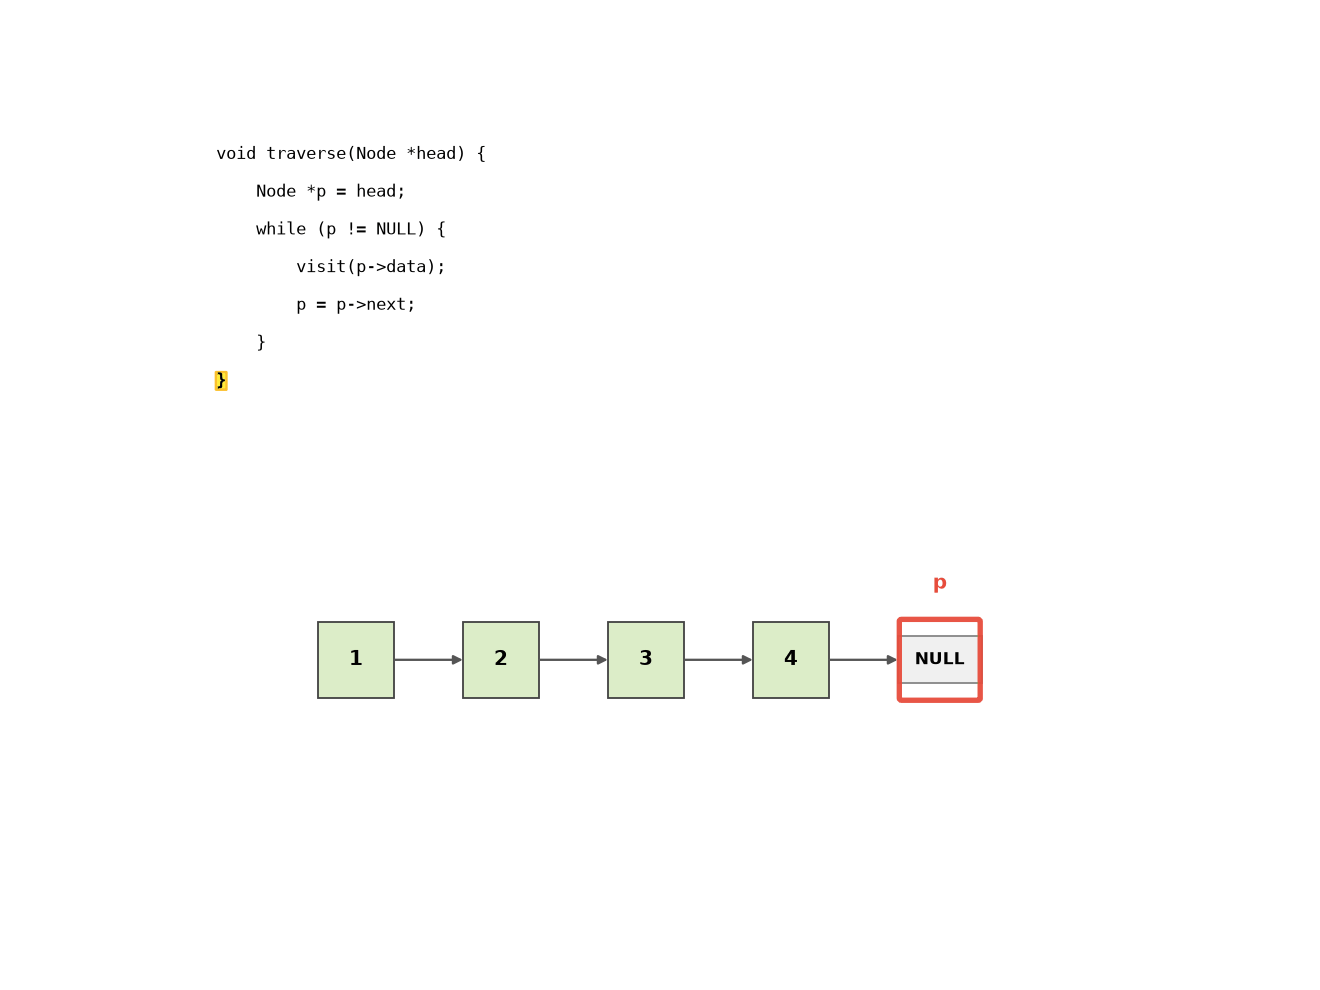
补充的函数指针让同一份遍历代码可以打印、求和、找最大值;遍历是 ,但不能在 visit 里删除结点,否则当前指针立刻失效。
完整示例:构建链表并遍历
#include <stdio.h>
#include <stdlib.h>

typedef struct SNode {
    int data;
    struct SNode* next;
} SNode;

SNode* create_node(int value) {
    SNode* node = malloc(sizeof(SNode));
    node->data = value;
    node->next = NULL;
    return node;
}

void insert_after(SNode* p, SNode* new) {
    new->next = p->next;
    p->next = new;
}

void delete_after(SNode* p) {
    SNode* victim = p->next;
    if (victim != NULL) {
        p->next = victim->next;
        free(victim);
    }
}

void print_list(SNode* head) {
    SNode* cur = head;
    while (cur != NULL) {
        printf("%d -> ", cur->data);
        cur = cur->next;
    }
    printf("NULL\n");
}

int main() {
    // 创建三个节点: 1 -> 2 -> 3 -> NULL
    SNode* head = create_node(1);
    insert_after(head, create_node(2));
    insert_after(head->next, create_node(3));

    print_list(head);           // 输出: 1 -> 2 -> 3 -> NULL

    delete_after(head);         // 删除节点 2
    print_list(head);           // 输出: 1 -> 3 -> NULL

    // 释放剩余节点
    delete_after(head);
    free(head);
    return 0;
}
按位查找与按值查找
按位查找(第 k 个结点,k 从 1 起算):链表不能像顺序表那样”算地址”,只能从头一格一格走。
SNode* get_node(SNode* head, int k) {
    SNode* cur = head;
    int i = 1;
    while (cur != NULL && i < k) {
        cur = cur->next;
        i++;
    }
    return cur;          /* 越界时返回 NULL */
}
为什么这样写:循环条件是”没走到头且还没数到 k”,返回的 cur 要么是第 k 个结点,要么是 NULL(表长不足)。时间复杂度 ,最坏 ——这是链表相对顺序表最大的劣势。
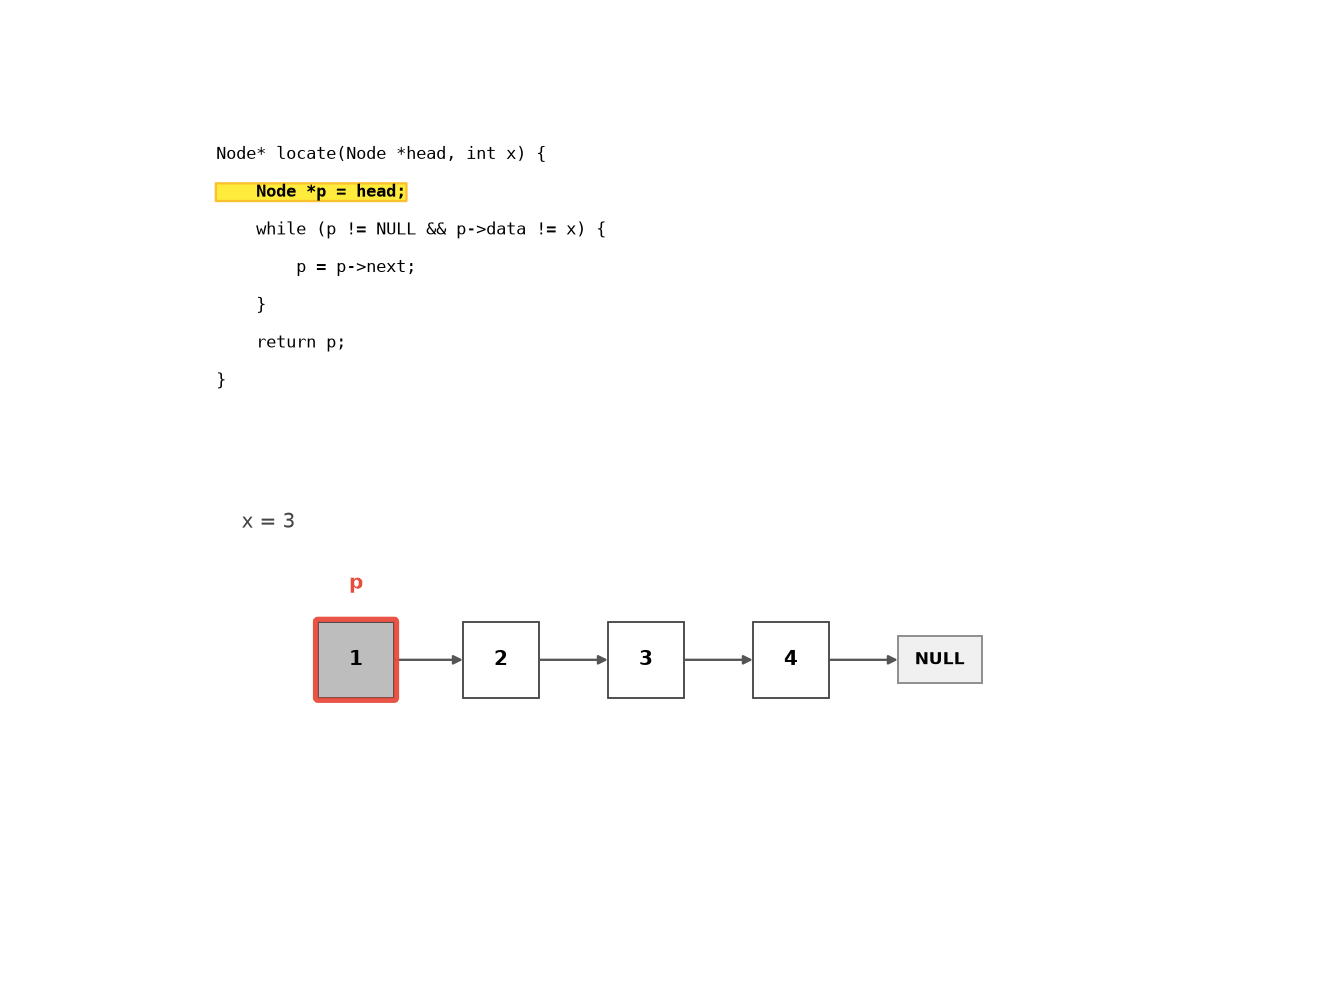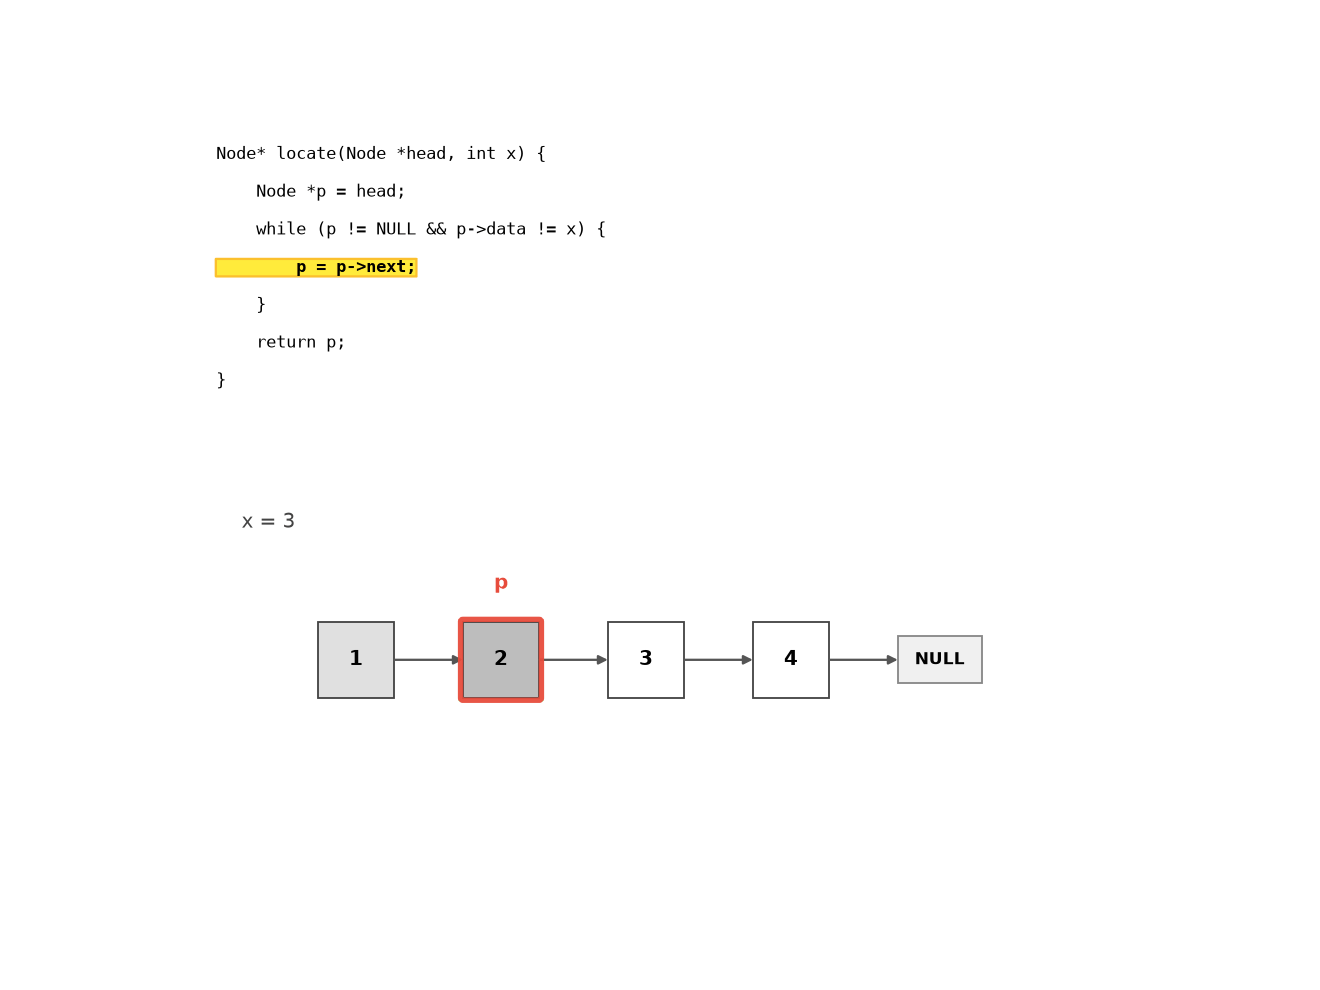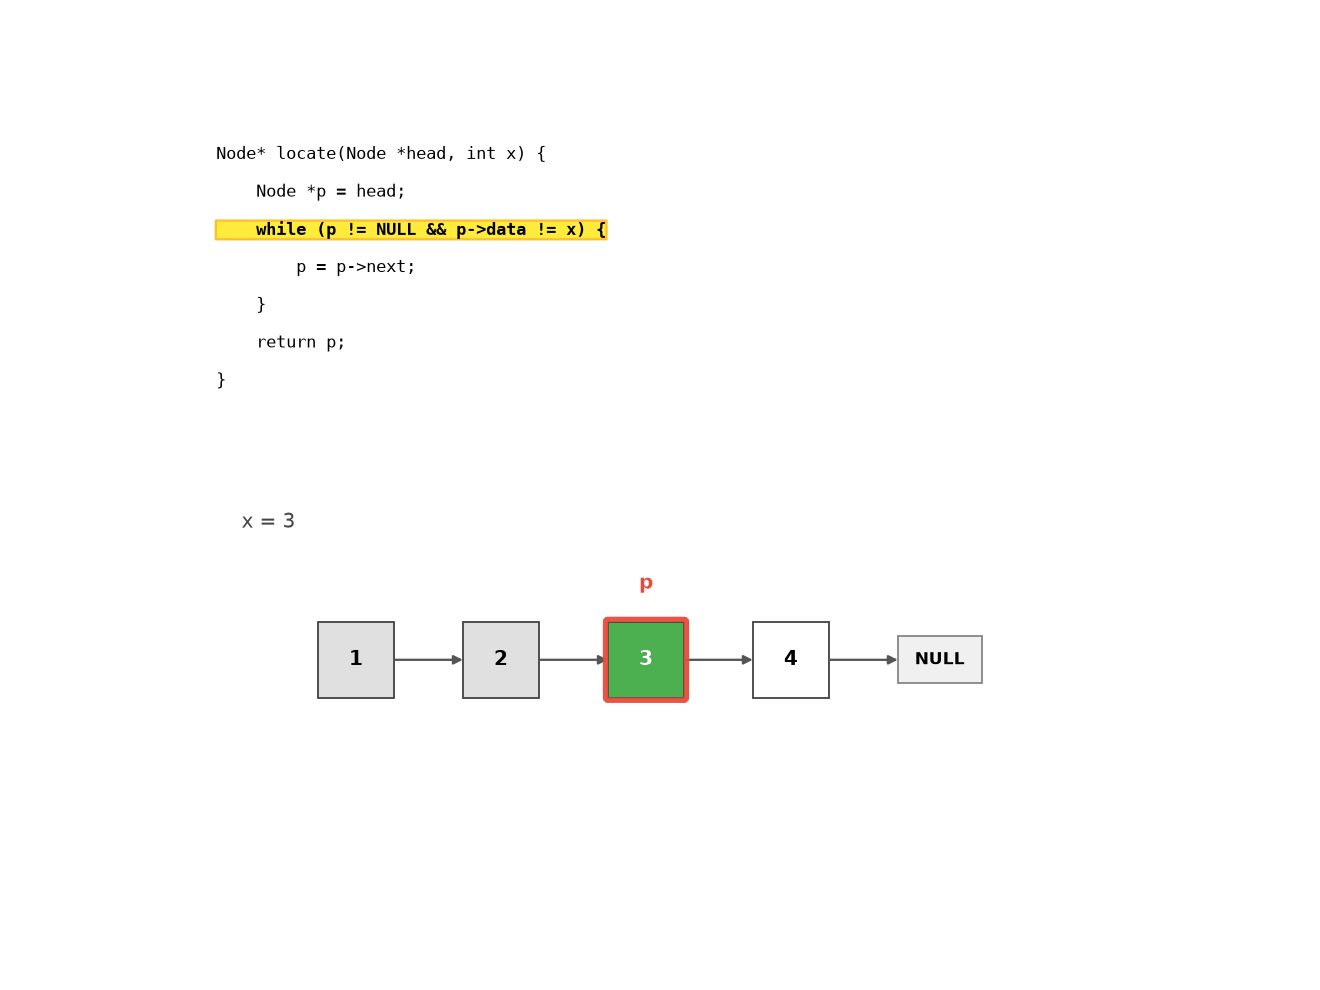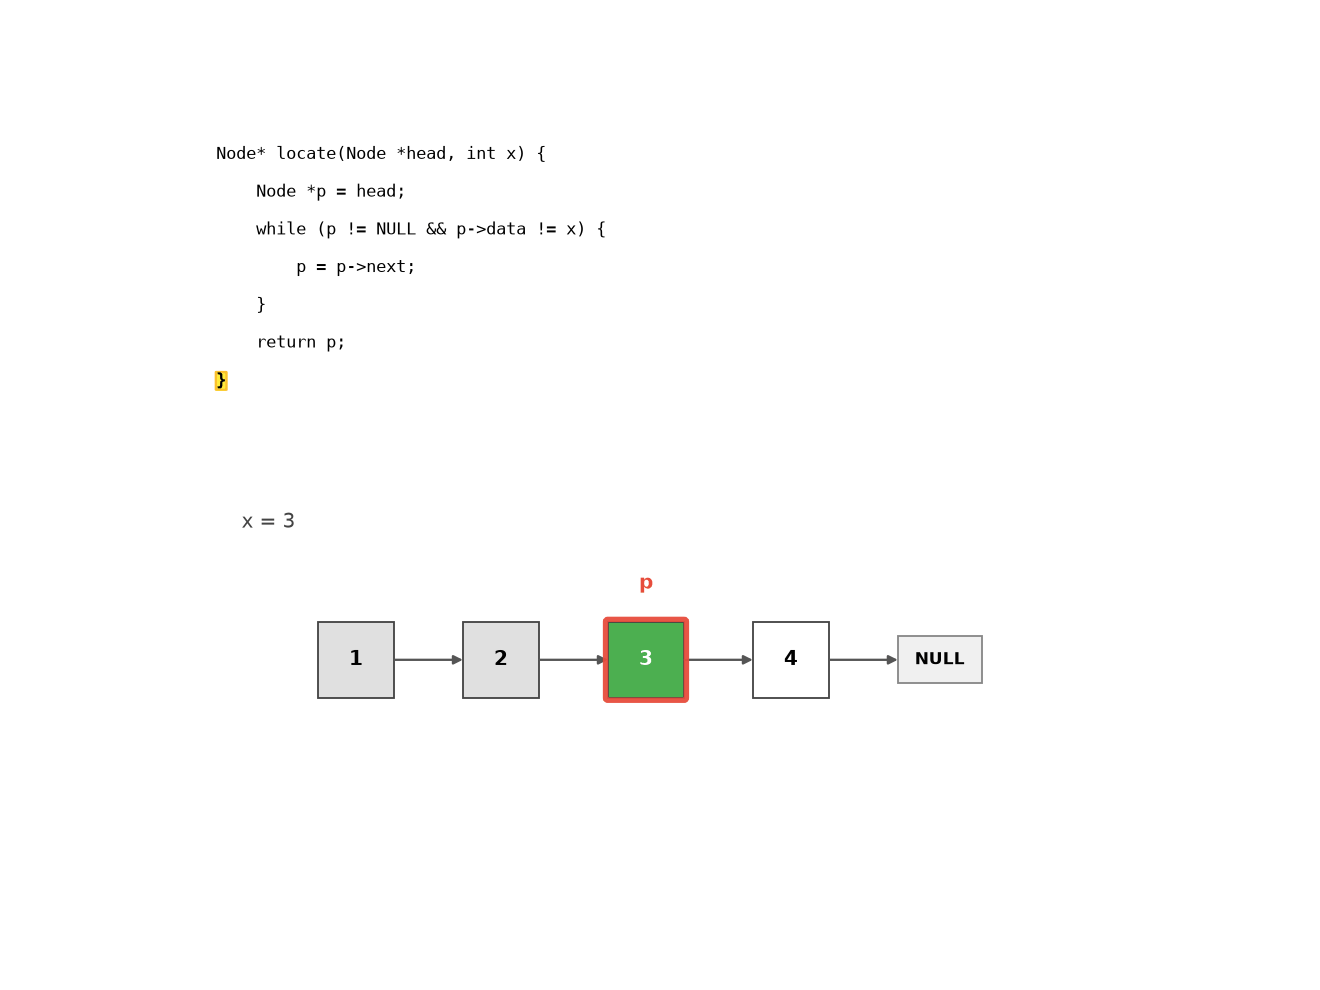
按值查找(返回第一个值为 x 的结点):
SNode* locate_node(SNode* head, int x) {
    SNode* cur = head;
    while (cur != NULL && cur->data != x)
        cur = cur->next;
    return cur;          /* 找不到返回 NULL */
}
为什么返回结点指针而不是位序:链表的插入、删除都要用到”结点地址”,返回指针调用者可以直接接着操作;如果只需要判断存在性,检查是否为 NULL 即可。等概率下查找成功的平均比较次数同样是 。
正规实现还可以把”怎么判断相等”交给调用者,这样结构体元素也能用同一份查找代码:
SNode* locate(SNode *head, int x, int (*eq)(int, int)) {
    for (SNode *p = head; p != NULL; p = p->next)
        if (eq(p->data, x)) return p;
    return NULL;
}
修改结点
int set_node(SNode* head, int k, int value) {
    SNode* p = get_node(head, k);
    if (p == NULL) return -1;    /* 第 k 个不存在 */
    p->data = value;
    return 0;
}
修改本身是 ,但要先花 找到结点——“操作本身快”和”整个操作快”是两回事,这是链表题里最容易搞混的地方。
销毁整条链表
void destroy_list(SNode** head) {
    SNode* cur = *head;
    while (cur != NULL) {
        SNode* nxt = cur->next;   /* 先记住下一个 */
        free(cur);                /* 再释放当前 */
        cur = nxt;
    }
    *head = NULL;                 /* 头指针置空,防止悬空 */
}
为什么参数是 SNode**:函数里要把头指针改成 NULL,C 按值传递改不了调用者的变量,必须传”头指针的地址”。释放顺序必须是”先存 next,再 free 当前”——和删除结点时先记住 victim 是同一个道理。
头插与尾插:两种建表方式
SNode* push_front(SNode* head, int value) {   /* 头插 */
    SNode* node = create_node(value);
    node->next = head;
    return node;                              /* 返回新的头指针 */
}

SNode* push_back(SNode* head, int value) {    /* 尾插(无尾指针,O(n)) */
    SNode* node = create_node(value);
    if (head == NULL) return node;
    SNode* cur = head;
    while (cur->next != NULL) cur = cur->next;
    cur->next = node;
    return head;
}
两种方式的选择:
- 头插:,但得到的是输入顺序的逆序。给一个序列建链表时,头插天然适合造逆序;
- 尾插:不破坏顺序,但每次都要走到表尾,;建整条表就是 。改进办法是额外维护一个尾指针,每次插入 。
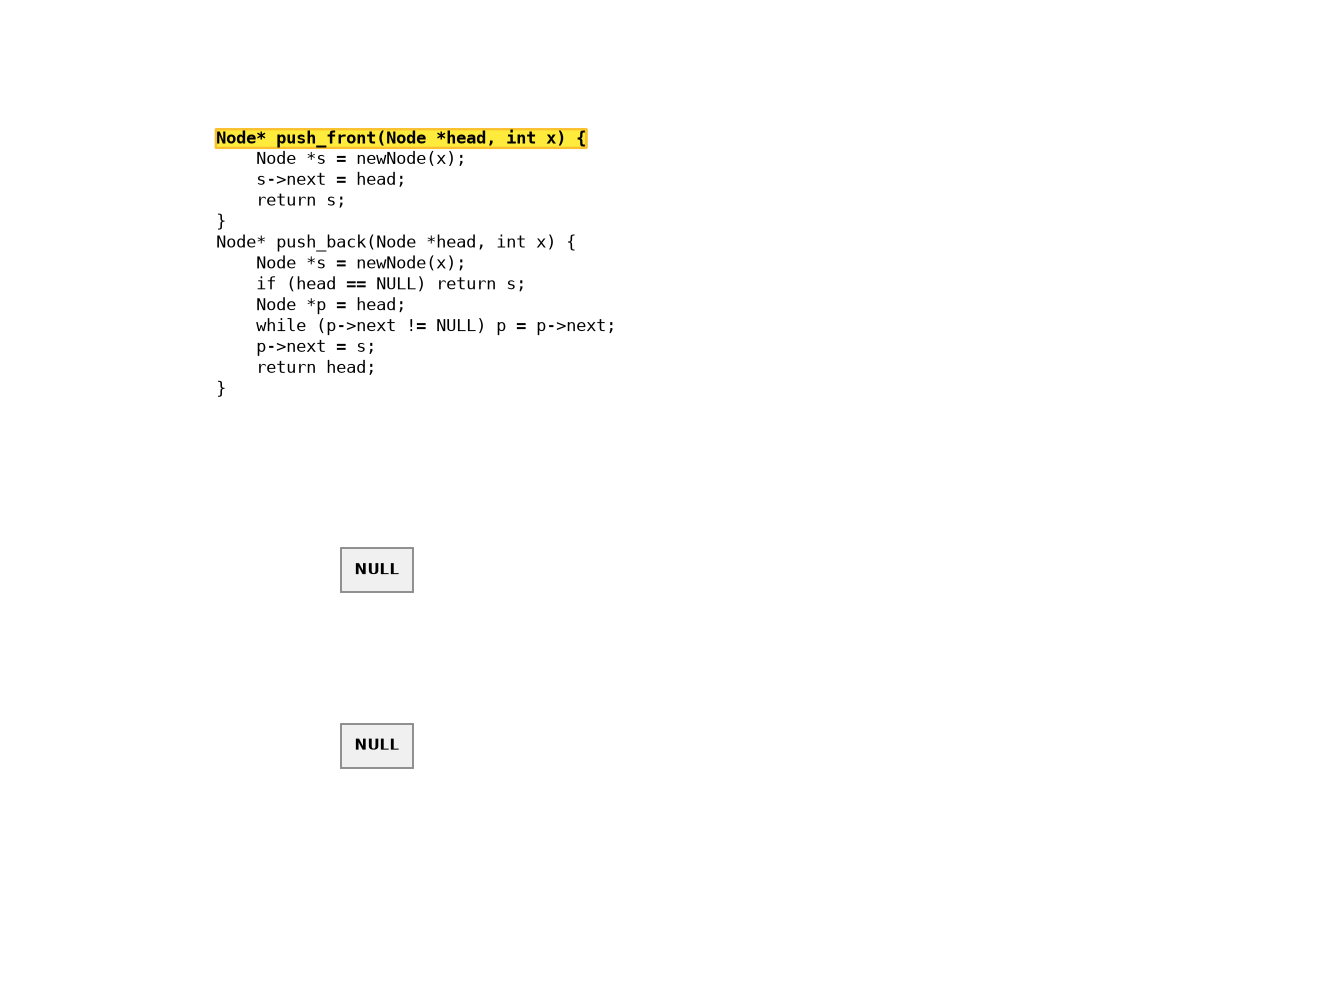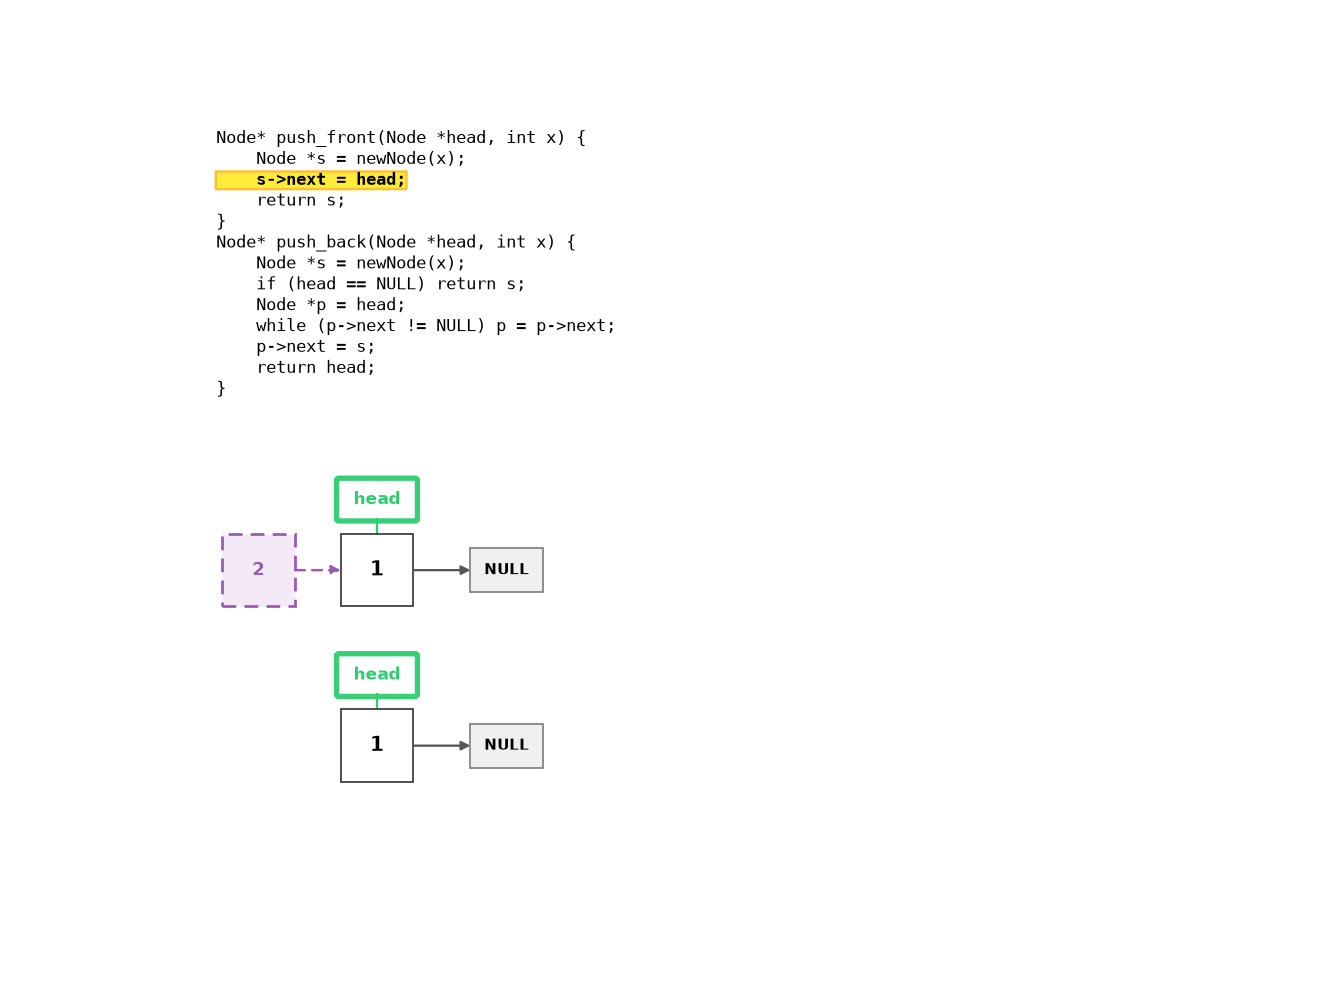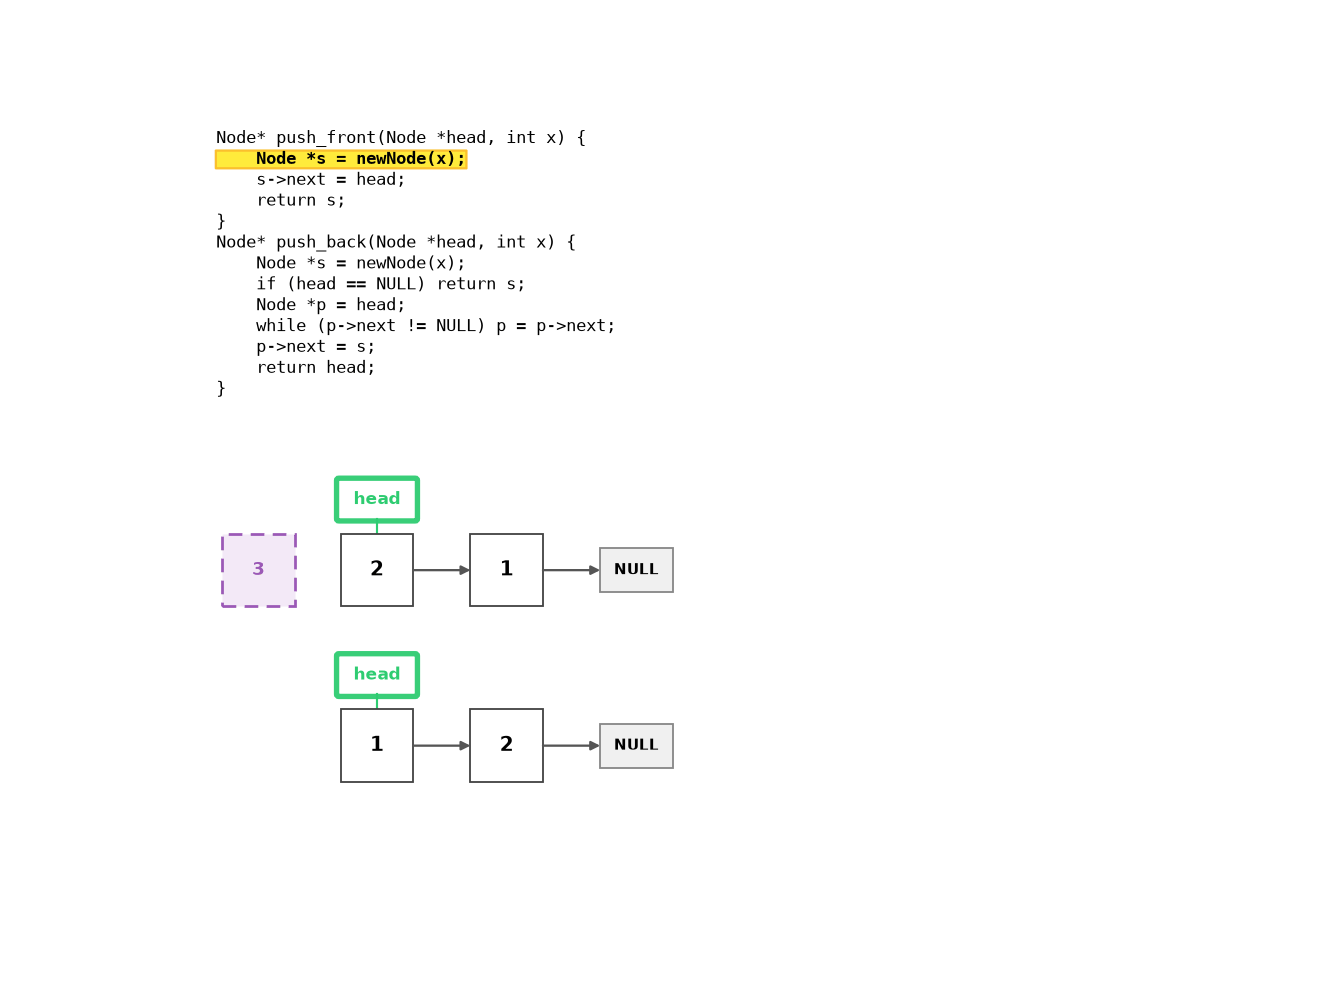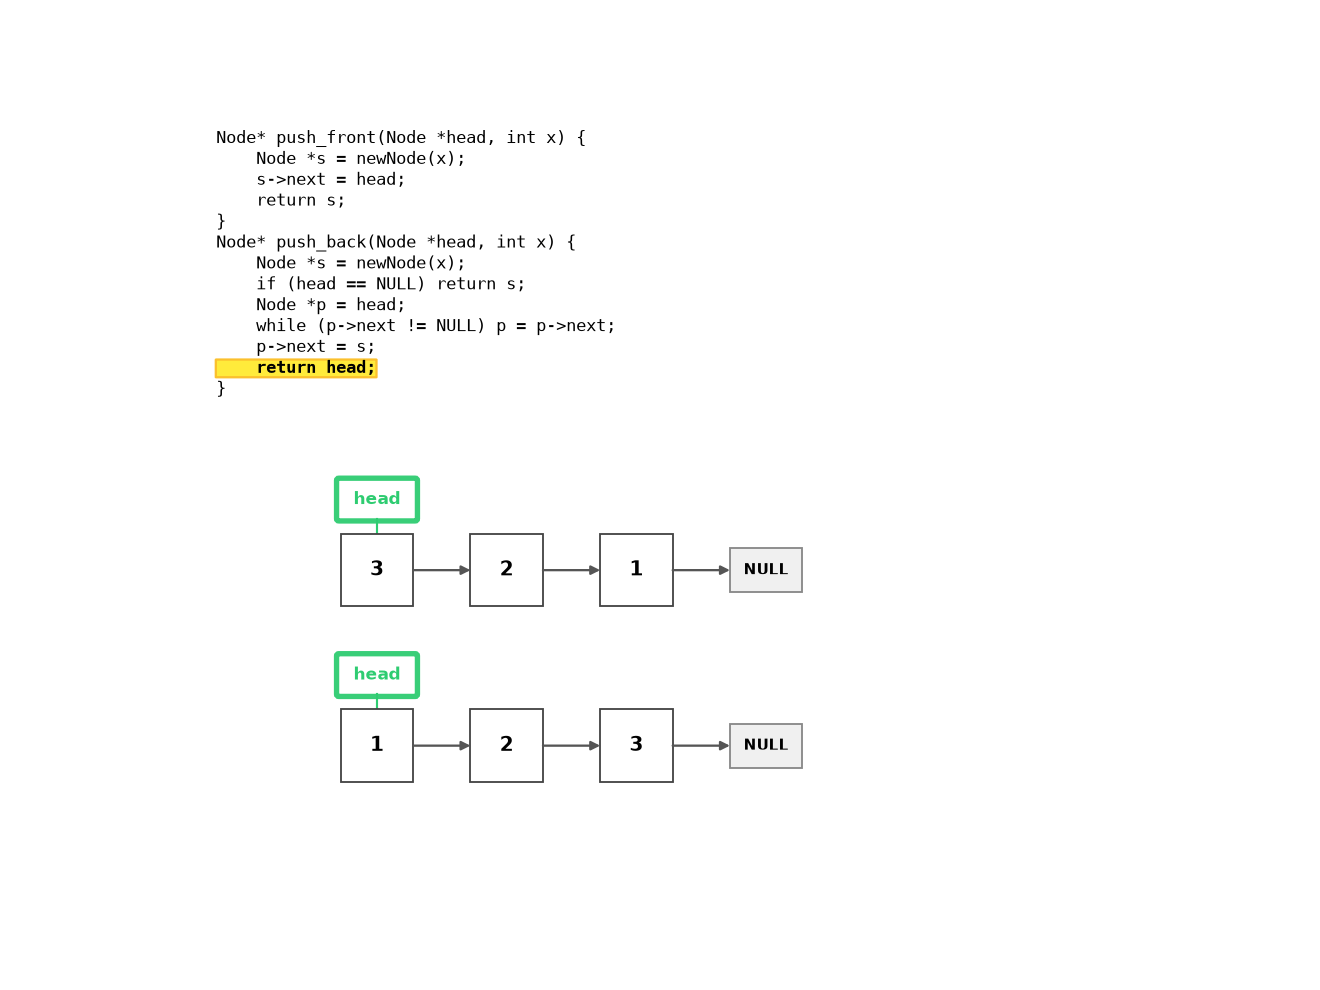
图中上半部分是头插、下半部分是尾插,依次插入 1、2、3。区别不只是”插在哪边”:
| 维度 | 头插 | 尾插 |
|---|---|---|
| 插入代价 | 无尾指针 ,有尾指针 | |
| 最终顺序 | 与输入相反(3→2→1) | 与输入相同(1→2→3) |
| 代码关键 | s->next = head; head = s; | 走到 p->next == NULL 再挂上 |
| 典型用途 | 造逆序、尾插不便时 | 按输入顺序建表 |
注意事项
写链表代码,出错的地方往往不是算法,而是下面这些细节:
malloc之后先判空再使用:内存不足时直接写node->data会崩溃;free之后不要再访问,也不要把指针留着不置NULL(悬空指针与重复释放都是未定义行为);- 删除首元结点要修改头指针:函数内改不了调用者的
head,要么返回新头指针,要么用SNode**,要么干脆带头结点; malloc(sizeof(SNode))而不是写死字节数,结构体改字段时这里不用动;- 结构体自引用必须写
struct SNode*:typedef的名字在结构体内部还不可见; - 函数参数里的
head是指针的值传递:函数内写head = head->next只改局部变量,不影响调用者。
原理
三种基本形态
| 单向链表 | 双向链表 | 循环链表 | |
|---|---|---|---|
| 每个节点指针数 | 1 | 2 | 1 或 2 |
| 遍历方向 | 仅正向 | 正向 + 反向 | 正向(或双向) |
| 尾部操作 | 需遍历 O(n) | O(1),tail 指针直达 | 视形态而定(见下表) |
| 删除节点(已知节点) | 需前驱 O(n) | O(1),通过 prev 找到前驱 | 同双向或单向 |
graph LR
 subgraph "单向链表"
 direction LR
 SL0["[head]"] --> SL1["data | next●"] --> SL2["data | next●"] --> SL3["data | next●"] --> SLN["NULL"]
 end
 subgraph "双向链表"
 direction LR
 DL0["[head]"] <-->|"prev●|●next"| DL1["data"] <-->|"prev●|●next"| DL2["data"] <-->|"prev●|●next"| DL3["data"]
 end
 subgraph "循环链表"
 direction LR
 CL0["[head]"] --> CL1["data | next●"] --> CL2["data | next●"] --> CL3["data | next●"] --> CL0
 end
双向链表的两个指针赋予了对称性——可以从任意节点向两个方向遍历。Linux 内核大量使用双向循环链表(struct list_head),正是因为这种对称性允许在不知道”容器头部”的情况下执行节点删除和拼接。
数学视角:链表的归纳定义【延伸】
抛开指针与内存,链表在数学上是一个递归定义的序列:
- 空链表是链表;
- 若 是链表、 是一个数据元素,则 也是链表(把 接到 前面)。
这与 Lisp 的 cons、函数式语言中的 List 完全同构:cons(x, rest) 对应”新建结点并让 next 指向 rest”。由此得到一组自然对应:
| 数学操作 | 链表操作 | C 代码 |
|---|---|---|
| 判空 | 判断是否为空 | head == NULL(带头结点时 head->next == NULL) |
| 取头 | 取首元结点 | head->data |
| 取尾 | 取后继子表 | head->next |
| 构造 | 头插一个结点 | new->next = head; head = new; |
“递归定义 + 头插构造”正是函数式语言里链表的写法;迭代版(循环 + 指针)只是它的等价实现。“反转、合并、删除、复制”等所有链表操作,本质上都是对这个递归结构的一次遍历或重构——这也是链表题几乎都能用递归解决的原因。
操作的数学精确分析
设链表长度为 ,理解每个操作的精确代价需要区分三种场景:
1. 查找第 个元素:
时间复杂度 。每次 cur = cur->next 是一个指针追踪(pointer chase)——CPU 必须先完成当前节点的加载,才能知道下一个节点的地址。这个过程无法被流水线或分支预测隐藏。
2. 插入(已知位置 p):
单向链表:两条赋值指令。
new->next = p->next;
p->next = new;
时间复杂度 ,但前提是已持有 p 的地址。如果只知道”插到第 个位置之后”,需要先 找到位置。
双向链表:四条赋值(同时更新前后节点的指针)。
new->prev = p;
new->next = p->next;
p->next->prev = new;
p->next = new;
在 CPU 指令层,这 4 条赋值是独立的 store 操作,彼此之间没有数据依赖——现代 CPU 的 store buffer 可以将它们合并后批量写入 L1 缓存。但如果 p->next 与 new 位于不同的 cache line,就涉及两条 cache line 的 ownership 获取。
3. 删除(已知节点 cur):
双向链表的删除是真正的 (不需要前驱指针):
cur->prev->next = cur->next;
cur->next->prev = cur->prev;
free(cur);
单向链表删除一个已知节点 ,除非该节点就是 head(此时 )。这个不对称性是双向链表多付出的一个指针(多 8 字节)的核心收益。
4. 创建有序单链表( 个结点):
每插入一个结点,都要从头查找插入位置:第 次插入平均需要 次比较,总代价为
所以创建一个含 个结点的有序单链表,时间复杂度是 。对比:元素已有序时,用头插或尾插创建只需 。
数组 VS 链表:不是 O(n) vs O(1)【延伸·底层视角】
这一节从硬件缓存的角度对比两者,考纲内的复杂度对比表见 顺序表 5.1。
教科书通常用操作复杂度表来对比数组和链表。但这个视角遗漏了最重要的因素:硬件行为。
| 操作 | 数组 | 链表 | 实际差距 |
|---|---|---|---|
| 随机访问第 k 个 | 数组 ~1ns(L1 hit),链表 ~100ns * k(每次 node deref 可能是 miss) | ||
| 头部插入 | 数组需移动所有元素,链表只需改 head | ||
| 中间插入(已知位置) | 数组移动 n-k 个元素,链表改 2 条指针 | ||
| 顺序遍历 | 数组 ~0.03s/1千万(cache 全命中),链表 ~3s/1千万(cache miss) |
graph TD
 subgraph "数组遍历 — cache 行为"
 direction LR
 ARR0["arr[0]"] --> ARR1["arr[1]"] --> ARR2["arr[2]"] --> ARR3["arr[3]"] --> ARR4["arr[4]"]
 end
 subgraph "链表遍历 — cache 行为"
 direction LR
 LL0["node 0<br/>heap addr 0x55a1"] -.->|"next ptr"| LL1["node 1<br/>heap addr 0x7f3c"]
 LL1 -.->|"next ptr (cache miss)"| LL2["node 2<br/>heap addr 0x4b90"]
 LL2 -.->|"next ptr (cache miss)"| LL3["node 3<br/>heap addr 0x91e2"]
 end
数组的遍历开销:一次 arr[0] 的 cache miss(加载一条 cache line),后续 15 次访问 arr[1..15] 全部命中 L1。
链表的遍历开销:每个 node->next 是一次指针追踪。由于每个节点在堆上独立分配(malloc 每次返回的地址不可预测),相邻节点大概率不在同一条 cache line 内。即使 malloc 恰巧分配了相邻地址(如从空闲链表的相邻 chunk 切割),缓存预取器(cache prefetcher)也无法识别”下一个地址”——因为下一个地址存储在 node->next 字段中,必须先用当前节点的地址加载 next 字段后才能知道。
存储密度
存储密度 = 数据本身占用的空间 / 结点占用的总空间:
顺序表每个单元只存数据,存储密度为 1;单链表每个结点还要存一个指针,存储密度小于 1。仅看结点结构(不含 malloc 元数据),int 数据 + 8 字节指针的存储密度为 ——数据越小、指针越”贵”,密度越低。
内存碎片与 malloc 元数据开销【延伸·底层】
这一小节面向想理解”链表为什么费内存”的读者,考纲不要求。
每个链表节点的 malloc 调用不仅分配用户请求的字节,还附带 glibc malloc 的 chunk 元数据:
flowchart LR
    subgraph chunk["一个 malloc chunk(约 32 字节)"]
        M["元数据 16B<br/>prev_size 8B + size/flags 8B"] --> D["用户可见 16B<br/>data 4B + next 8B + padding 4B"]
    end
    D --> N["下一个 chunk ..."]
| 区域 | 大小 | 内容 |
|---|---|---|
| malloc chunk 元数据 | 16B | prev_size(8B) + size/flags(8B) |
| 用户可见空间 | 16B | data(4B) + next(8B) + padding(4B) |
对于一个存储 int 的单向链表节点(用户请求 sizeof(SNode) = 16 字节),malloc 实际消耗约 32 字节。有效载荷效率 = 数据大小 / 总内存 = 4B / 32B = 12.5%。换句话说,一万个 int 元素的链表实际占用约 320KB,而等量的数组仅需 40KB。
此外,长期运行的链表经过多次插入和删除后,节点散布在堆的各处,形成内存碎片——空闲内存在总量上足够但无法合并为连续大块。当后续需要分配大数组时,即使总空闲内存远大于请求量,malloc 仍可能失败。
深入底层【延伸】
硬件层面的指针追踪(Pointer Chasing)
链表遍历的性能瓶颈来自指针追踪(pointer chasing)。从 CPU 的角度看,遍历链表是这样的串行流水线:
1. 加载 node 的地址 (在 rax 中)
2. 读 [rax + 8] → 获取 node->next 的值
3. 读 [rax + 0] → 获取 node->data 的值 (如果需要)
4. 将 node->next 的值放入 rax,跳回步骤 1
步骤 2 和步骤 4 之间存在 RAW(Read After Write)数据依赖——CPU 无法在知道 node->next 的值之前开始下一次迭代的加载。这是不可流水化的串行依赖链(serial dependency chain)。
相比之下,数组遍历中,arr[i+1] 的地址可以直接从 arr[i] 的地址推算(只是加上 sizeof(T)),不需要加载任何指针。CPU 的预取器(prefetcher)可以提前几轮循环就将未来的 cache line 拉入缓存。
内存级并行(Memory-Level Parallelism, MLP):现代 CPU 支持同时处理多个未完成的 cache miss。但在链表中,MLP 无法发挥作用——因为每次迭代依赖上一次迭代的结果,CPU 必须等待每个 node->next 加载完成后才能发起下一个加载。与之相反,数组遍历中 CPU 可以同时预取 arr[i+1], arr[i+2], arr[i+3] 等多条 cache line。
sequenceDiagram
 participant CPU as CPU (LSU)
 participant L1 as L1 Cache
 participant L2 as L2 Cache
 participant DRAM as 主存 (DRAM)

 CPU->>L1: 读 node0->next
 L1-->>CPU: MISS (node0 不在 L1)
 CPU->>L2: 读 node0->next
 L2-->>CPU: MISS (node0 不在 L2)
 CPU->>DRAM: 读 node0->next (~100ns)
 DRAM-->>CPU: 返回 node1 的地址
 Note over CPU: 拿到 node1 地址后<br/>才能发起下一次访问
 CPU->>L1: 读 node1->next
 L1-->>CPU: MISS
 Note over CPU,DRAM: 又是 ~100ns 延迟...
这个串行依赖链意味着:无论 CPU 有多快,链表遍历的速度受限于 DRAM 延迟(~100ns)乘以节点数。10 万个节点约需 10ms——而等量的数组遍历约需 30μs,差距约 300 倍。
展开链表(Unrolled Linked List)
展开链表是缓存友好性和链表灵活性的折中:每个节点不再只存一个元素,而是存一个小数组(如 8-16 个元素)。遍历一个节点(一次 cache miss)可连续访问节点内的多个元素(缓存命中),等价于将链表的”逐元素 miss”降为”每 8 个元素一次 miss”。
graph LR
 subgraph "展开链表 (展开因子=4)"
 direction LR
 N0["node 0<br/>arr[0..3] | next●"] --> N1["node 1<br/>arr[0..3] | next●"] --> N2["node 2<br/>arr[0..2] | next●"] --> NUL["NULL"]
 end
在 C++ 中,std::deque 使用了类似的思想——分块连续存储(block-based contiguous storage),但 deque 的块由中央控制结构管理,与展开链表的手动指针链接不同。详见 容器章节。
静态链表(数组模拟链表)
静态链表用数组存储结点,用游标(数组下标)代替指针来串联结点:
#define MAXSIZE 100
typedef struct {
    int data;
    int next;          /* 游标:下一个结点的下标,0 表示空 */
} SLinkList[MAXSIZE];- 每个”结点”占据数组的一个位置,
next存放的是下一个结点的下标而不是内存地址; - 插入/删除只修改游标,不移动元素,逻辑与链式链表一致;
- 需要预先确定最大结点数(静态分配);被删除的结点通常挂到”备用链表”上供后续复用;
- 典型用途:不支持指针的语言、嵌入式等需要预分配内存的场景;插入/删除只改游标。
| 对比 | 单链表 | 静态链表 |
|---|---|---|
| ”指针”形式 | 内存地址 | 数组下标(游标) |
| 容量 | 动态申请 | 预先固定 |
| 插入/删除 | 改指针 | 改游标 |
| 每个结点的额外开销 | 一个指针 | 一个游标(通常是 int) |
游标插入怎么推导:数组里结点 i 的物理后一个位置是 i+1,但它的逻辑后继由游标 next[i] 决定——这两者没有任何关系。所以插入时要改的是游标,不是物理位置。在 i 之后插入新结点 s:
next[s] = next[i];   /* ① 让新结点接住 i 原来的逻辑后继 */
next[i] = s;         /* ② 再让 i 指向新结点 */
它和链式写法 s->next = p->next; p->next = s; 一模一样,只是把”指针”换成了”数组下标”。删除同理:next[i] = next[next[i]];,然后把被删结点的下标挂回备用链表(用 next[0] 串起空闲结点,供后续插入复用)。考题常给一张”数据 + 游标”的表,让你写出插入/删除后游标字段的变化序列——抓住”逻辑后继看游标、不看相邻下标”这一句即可。
XOR 链表(异或链表,XOR Linked List)
XOR 链表是一种仅使用一个指针字段存储双向链表中两个指针信息的技巧——利用异或运算()的可逆性:
正向遍历时,已知 prev 和 node.link,则 next = prev ^ node.link。反向遍历同理。每个节点少存一个指针(节省 8 字节),但代价是遍历时必须保留前一个节点的地址,且无法仅导航到”下一个”——必须同时持有当前节点和其前驱。
XOR 链表几乎从未在通用库中使用,主要原因:在 64 位系统上,把指针值当作整数做异或运算违反了类型安全,且在 GC 环境中移动节点会破坏异或一致性。但它的思想——用代数运算压缩信息——在有限内存的嵌入式系统中偶有应用。
侵入式链表(Intrusive Linked List)
Linux 内核不使用”节点包含数据”的链表,而使用侵入式链表——链表指针嵌入在节点结构体内部。
// Linux 内核风格 (定义在 <linux/list.h>)
struct list_head {
 struct list_head *prev, *next;
};

struct my_struct {
 int data;
 struct list_head list; // 嵌入的链节点,而非包含
};
graph LR subgraph "侵入式链表" direction LR HEAD["list_head<br/>head"] --> D1["my_struct<br/>{data=1, list}"] --> D2["my_struct<br/>{data=2, list}"] --> HEAD end
侵入式链表的优势:
- 零额外分配:
list_head是结构体的字段,不需要单独的malloc给链节点 - 通用性:同一套
list_add、list_del函数操作任何嵌入list_head的结构体(通过container_of宏从list_head*逆向获取外覆结构体指针) - 一个对象可在多个链表中:嵌入多个
list_head字段即可
代价是使用者必须理解 container_of 的偏移量技巧,且链表操作不直接返回数据指针(需手动 container_of)。
链表与安全:use-after-free 和 double-free
链表删除操作是 C 语言中悬垂指针(dangling pointer)的重灾区:
// 危险的删除——释放后未断开链接
void dangerous_delete(DNode* cur) {
 cur->prev->next = cur->next; // 先改链表
 cur->next->prev = cur->prev;
 free(cur); // 释放内存
 // 此时 cur 是悬垂指针,但链表中的其他节点可能不再引用它
}

// 更危险的场景——
DNode* victim = list->head;
list->head = victim->next;
free(victim);
// ... 稍后 ...
victim->data = 42; // use-after-free! 写入已释放的内存
在链表操作中,释放节点前必须确保:(a) 已从链表中断开(所有指向它的指针已修改),(b) 不保留悬垂指针,(c) 不重复释放(double-free)。侵入式链表将内存管理交给外覆对象的创建者,在一定程度上避免了这个问题——链表操作不负责 free,只负责断开链接。
实现
单向链表(带大小缓存和尾部指针)
#include <stdlib.h>

typedef struct SNode {
 int data;
 struct SNode* next;
} SNode;

typedef struct {
 SNode* head;
 SNode* tail; // O(1) 尾部插入
 size_t size;
} SinglyLinkedList;

void sll_init(SinglyLinkedList* list) {
 list->head = list->tail = NULL;
 list->size = 0;
}

void sll_destroy(SinglyLinkedList* list) {
 while (list->head) {
 SNode* tmp = list->head;
 list->head = list->head->next;
 free(tmp);
 }
 list->tail = NULL;
 list->size = 0;
}

int sll_push_front(SinglyLinkedList* list, int value) {
 SNode* node = malloc(sizeof(SNode));
 if (!node) return -1;
 node->data = value;
 node->next = list->head;
 list->head = node;
 if (!list->tail) list->tail = node; // 首个元素,tail 也指向它
 list->size++;
 return 0;
}

int sll_push_back(SinglyLinkedList* list, int value) {
 SNode* node = malloc(sizeof(SNode));
 if (!node) return -1;
 node->data = value;
 node->next = NULL;
 if (list->tail) {
 list->tail->next = node;
 list->tail = node;
 } else {
 list->head = list->tail = node; // 空链表的首个元素
 }
 list->size++;
 return 0;
}

int sll_pop_front(SinglyLinkedList* list) {
 if (!list->head) return -1;
 SNode* tmp = list->head;
 list->head = list->head->next;
 if (!list->head) list->tail = NULL; // 链表变空,tail 也置 NULL
 free(tmp);
 list->size--;
 return 0;
}

// 原地反转(迭代)
void sll_reverse(SinglyLinkedList* list) {
 SNode *prev = NULL, *cur = list->head;
 list->tail = list->head; // 原 head 变新 tail
 while (cur) {
 SNode* nxt = cur->next;
 cur->next = prev;
 prev = cur;
 cur = nxt;
 }
 list->head = prev;
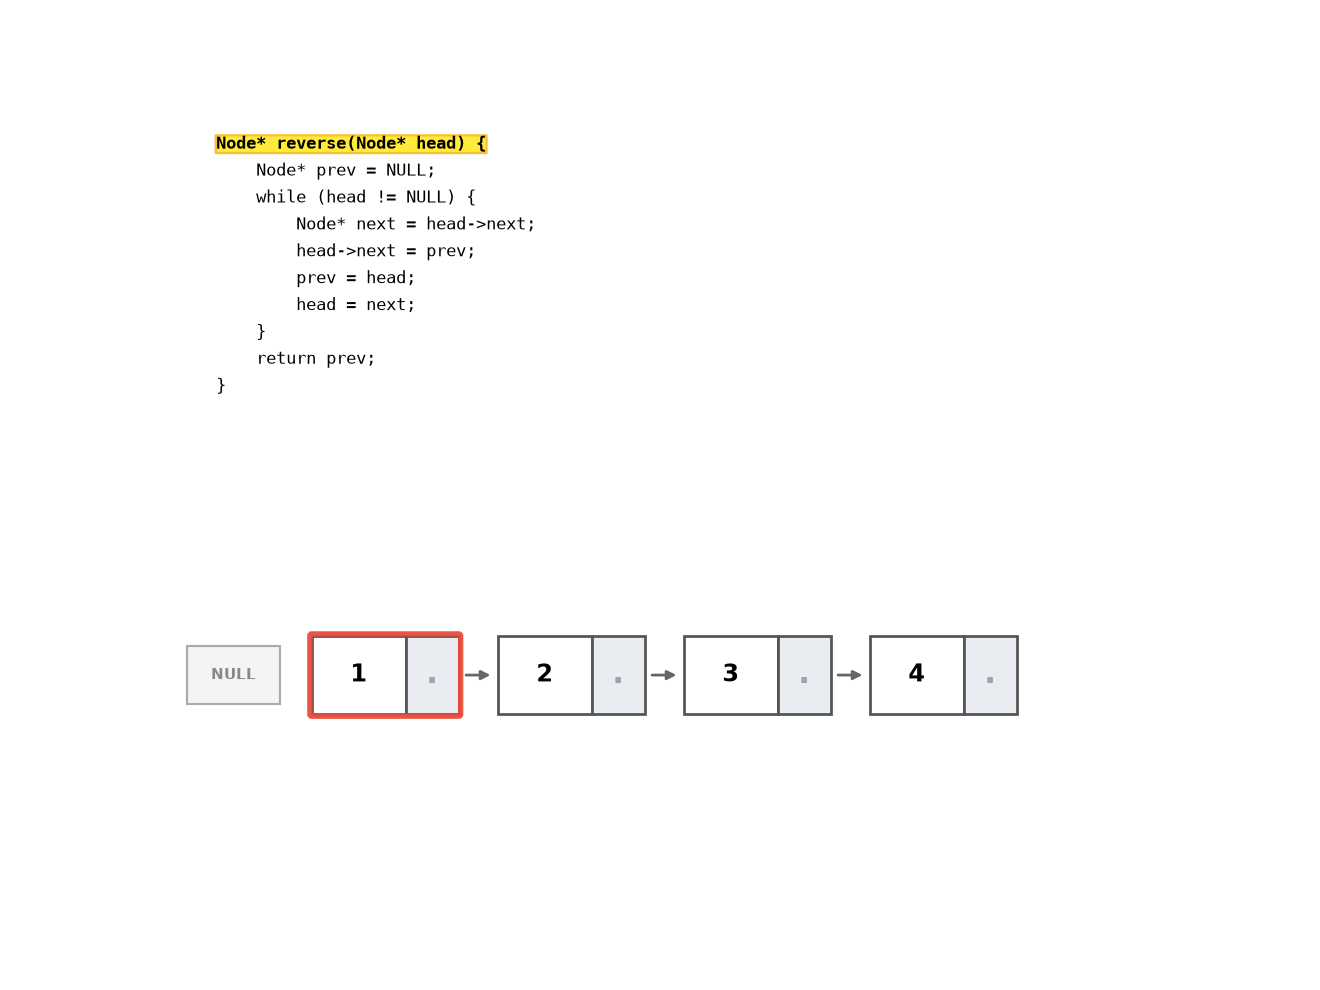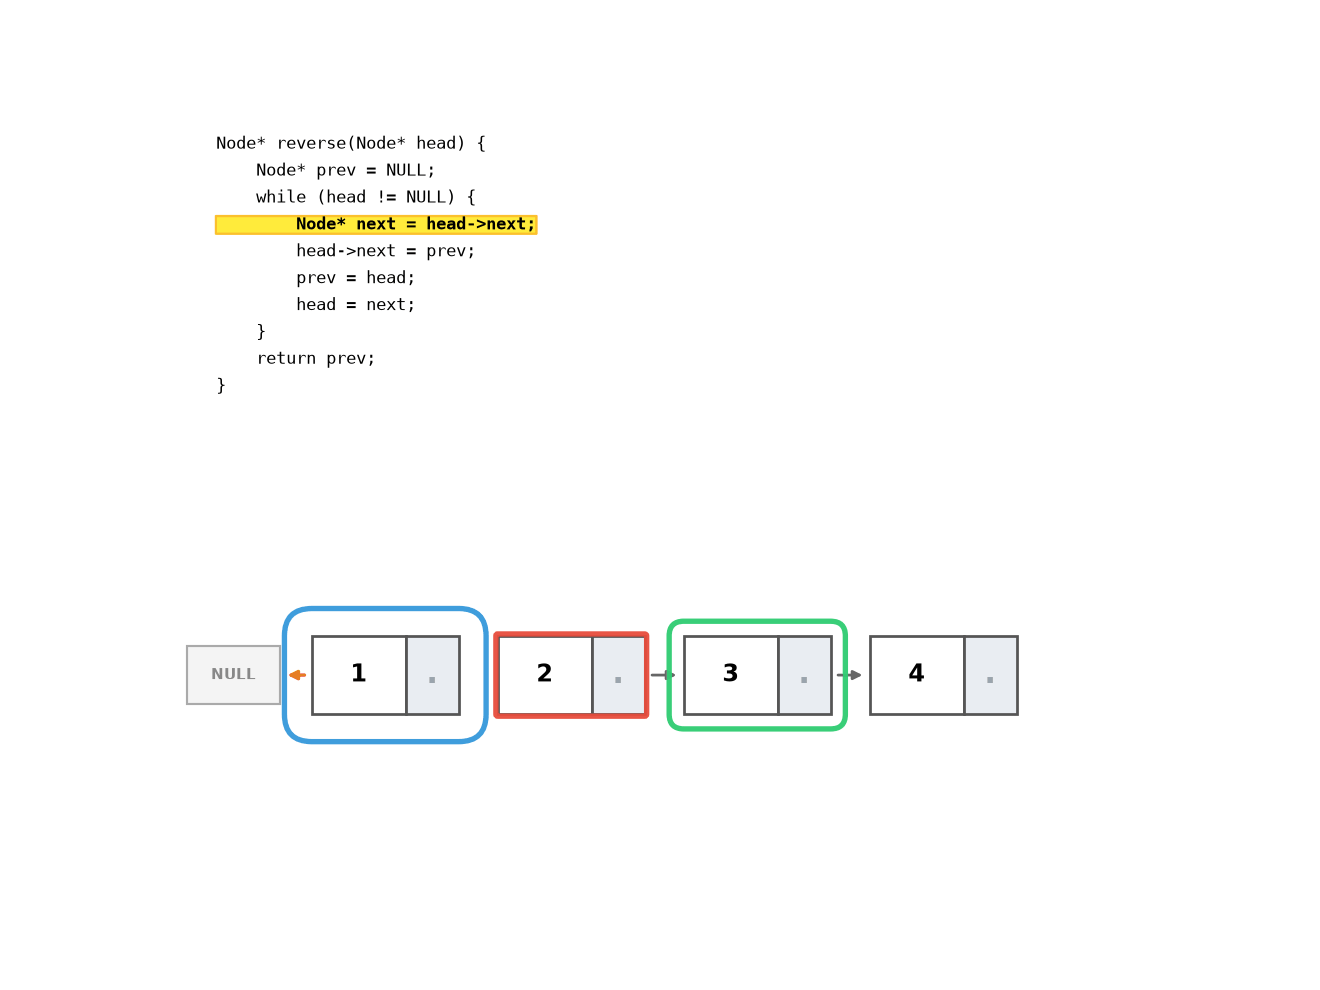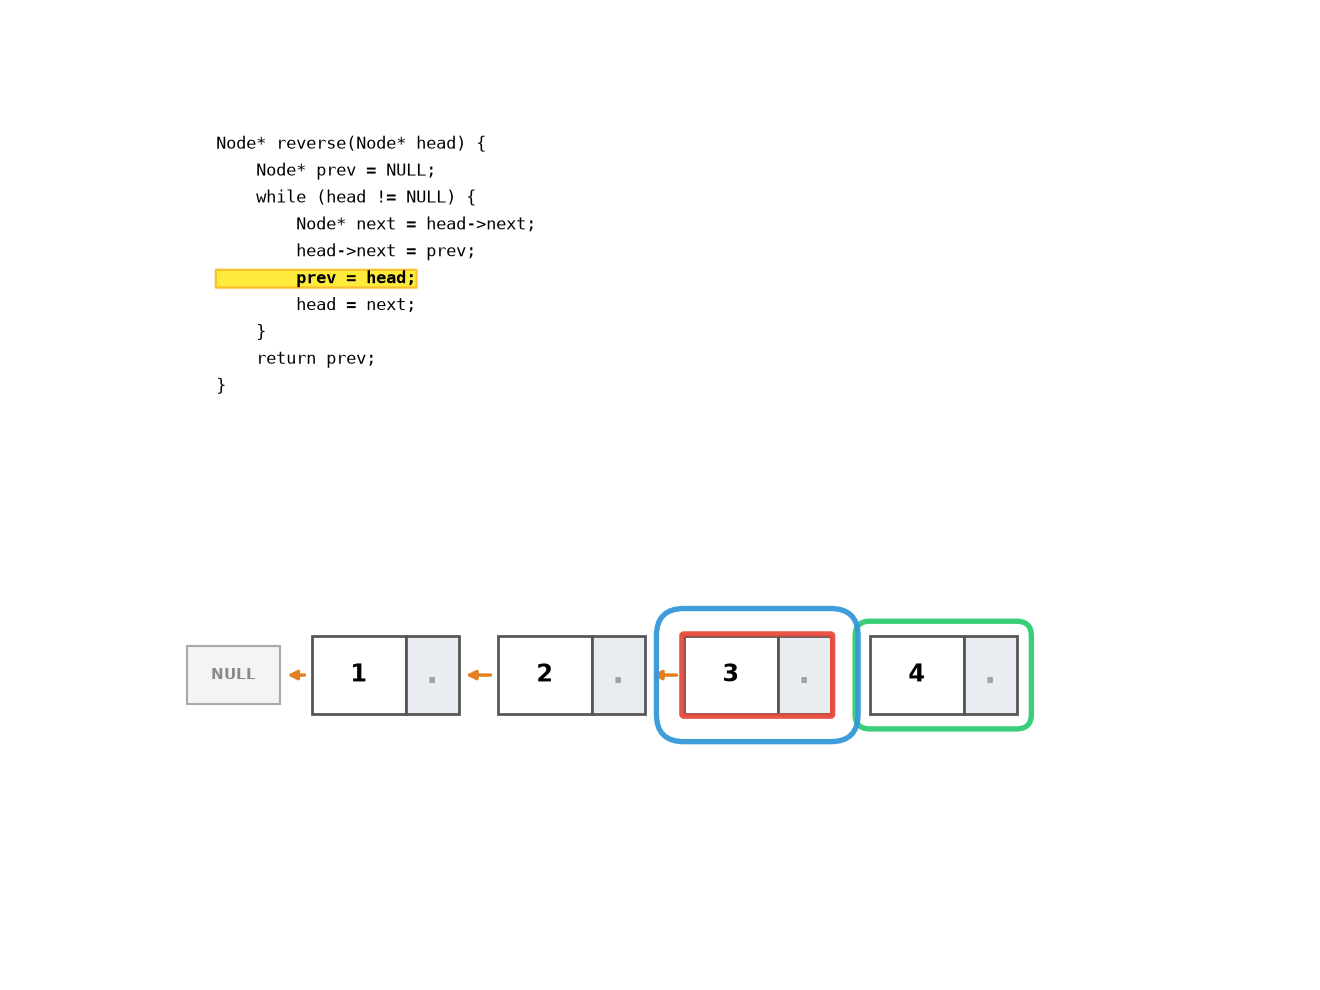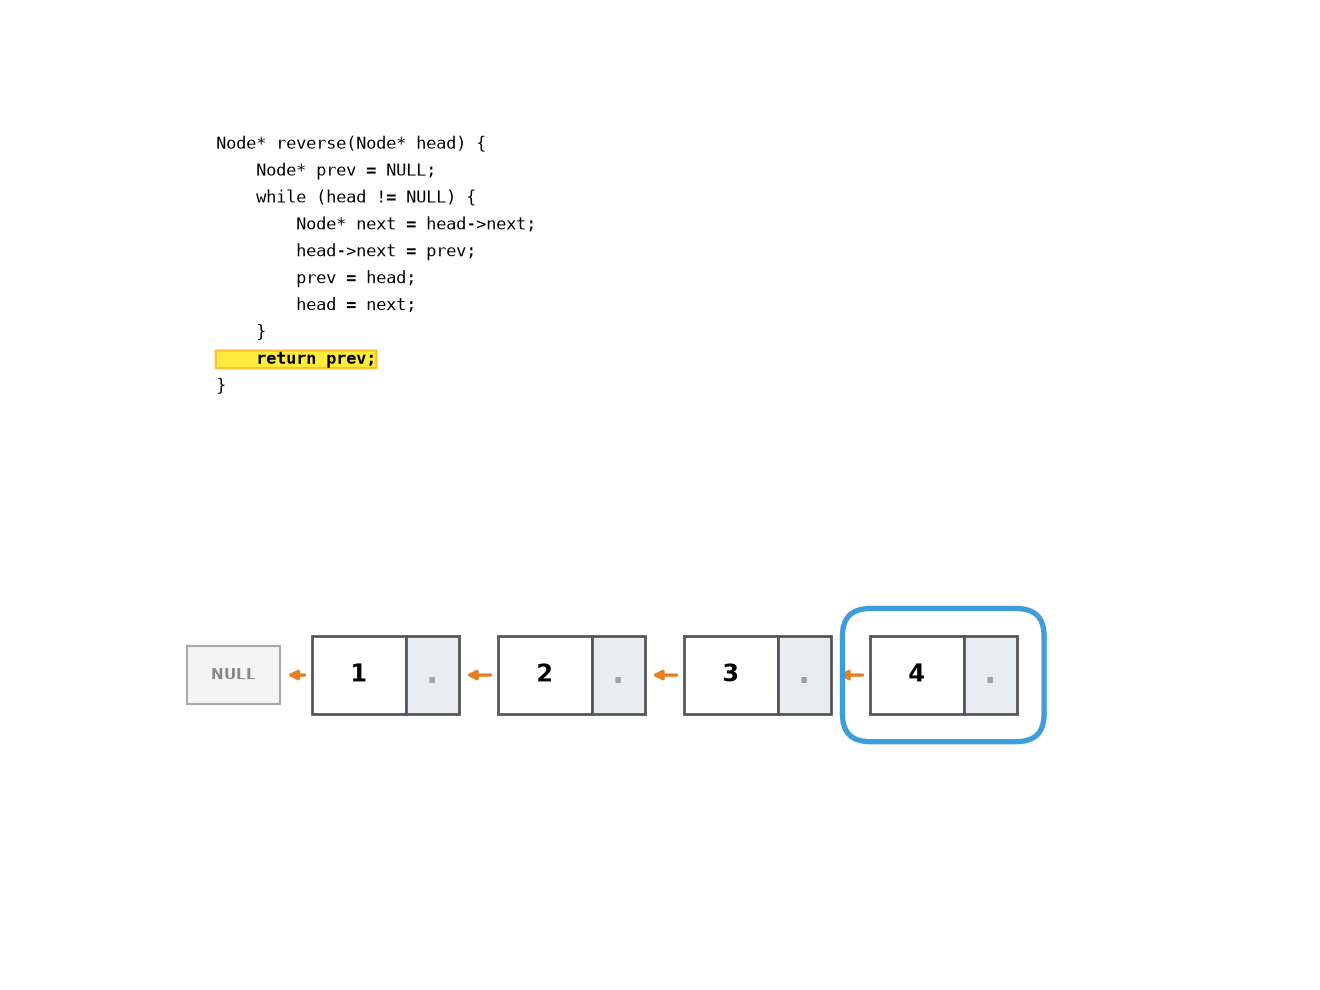
}
递归版反转
// 递归反转 —— 时间 O(n),空间 O(n)(调用栈)
SNode* sll_reverse_rec(SNode* head) {
    if (!head || !head->next) return head;    // 空表或单节点:自身即新表头
    SNode* new_head = sll_reverse_rec(head->next);   // 信任:后半段已完全逆转
    head->next->next = head;                  // 后继回头指向自己
    head->next = NULL;                        // 自己成为新尾巴
    return new_head;
}
理解关键:递归信任”后半段已经逆转完毕”,当前层只做两件事——让后继指回自己、把自己封为新尾。以 1→2→3 为例的调用栈展开:
flowchart TB
  R1["reverse_rec(1)"]
  R2["reverse_rec(2)"]
  R3["reverse_rec(3) → 返回 3(基准情形)"]
  P2["2→next(=3)→next = 2, 2→next = NULL\n链变为 3→2→NULL"]
  RET2["返回 3"]
  P1["1→next(=2)→next = 1, 1→next = NULL\n链变为 3→2→1"]
  RET1["返回 3"]
  R1 --> R2 --> R3
  R3 --> P2 --> RET2
  RET2 --> P1 --> RET1
迭代版 vs 递归版:时间同为 ;空间 vs ——递归的隐藏代价是调用栈深度等于链长,长链表可能栈溢出。这正呼应容器章的论断:所有递归都可改写为迭代 + 显式栈。
双向链表
与单向链表的核心区别
双向链表的每个结点多一个 prev 指针,换来的是”两个方向都能走、已知结点删除不必先找前驱”:
| 对比点 | 单向链表 | 双向链表 |
|---|---|---|
| 结点结构 | data + next | data + prev + next |
| 已知结点删除 | 要前驱,(除非用 **head) | 直接改两根指针, |
| 遍历方向 | 只能正向 | 正向 + 反向 |
| 尾部操作 | 找前驱麻烦 | 有 prev,尾插/尾删方便 |
| 存储密度 | 较低 | 更低(多一个指针) |
| 代码复杂度 | 简单 | 每次插删要维护两个方向 |
差别落到代码上其实只有几行——插入从两行变四行,删除从”找前驱”变两根指针:
/* 在 p 之后插入 s */
s->next = p->next;          /* 单链表到这里只差下面两行 */
s->prev = p;                /* 新增:新结点指回 p */
p->next->prev = s;          /* 新增:原后继指回新结点 */
p->next = s;

/* 删除 p */
p->next->prev = p->prev;    /* ① 后继先接上 p 的前驱 */
p->prev->next = p->next;    /* ② 前驱再接上 p 的后继 */
free(p);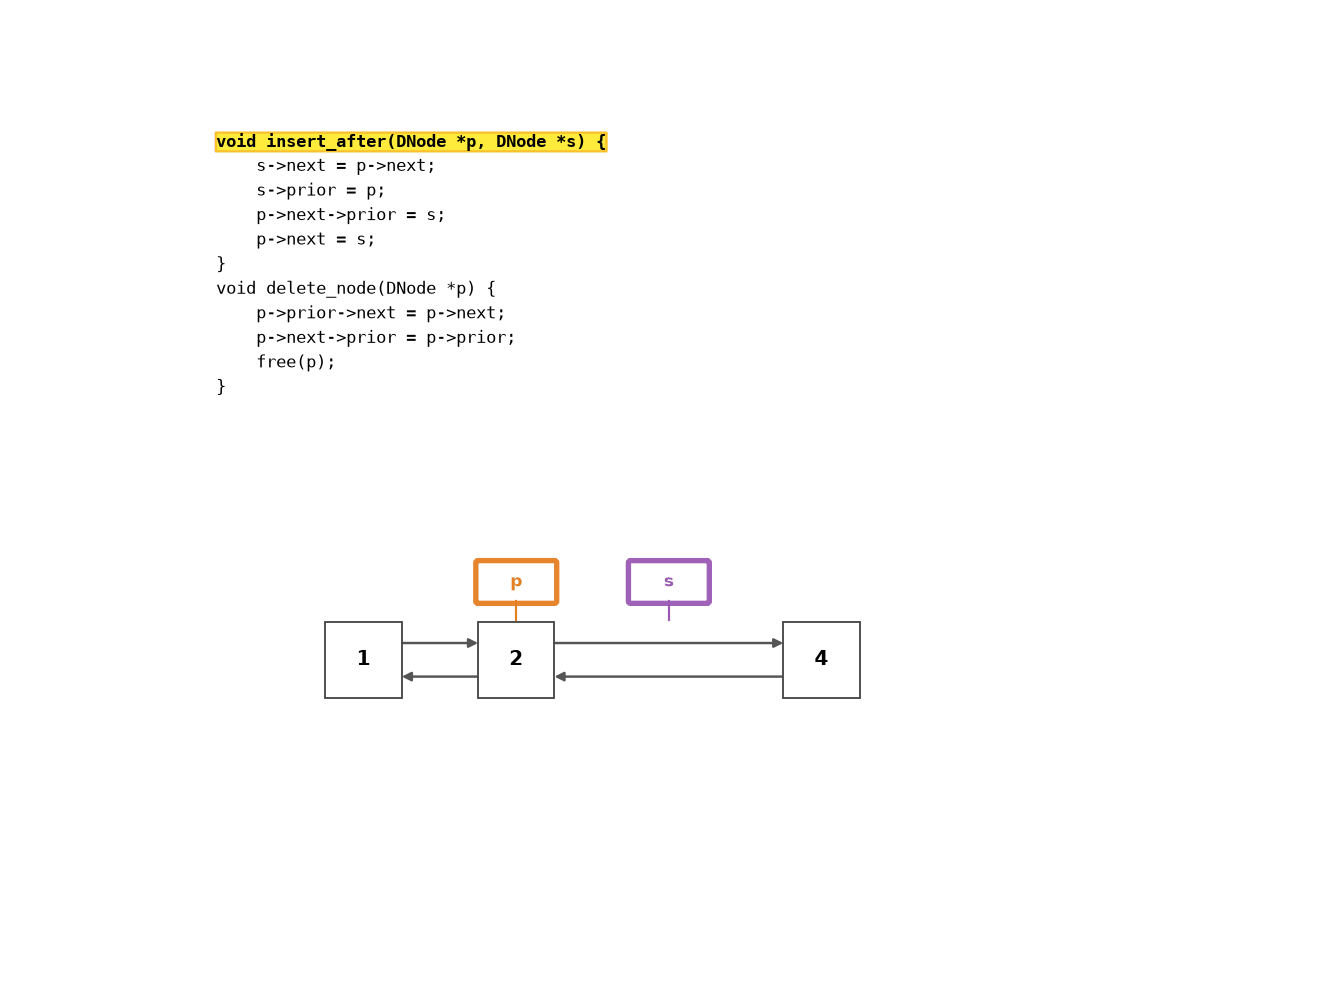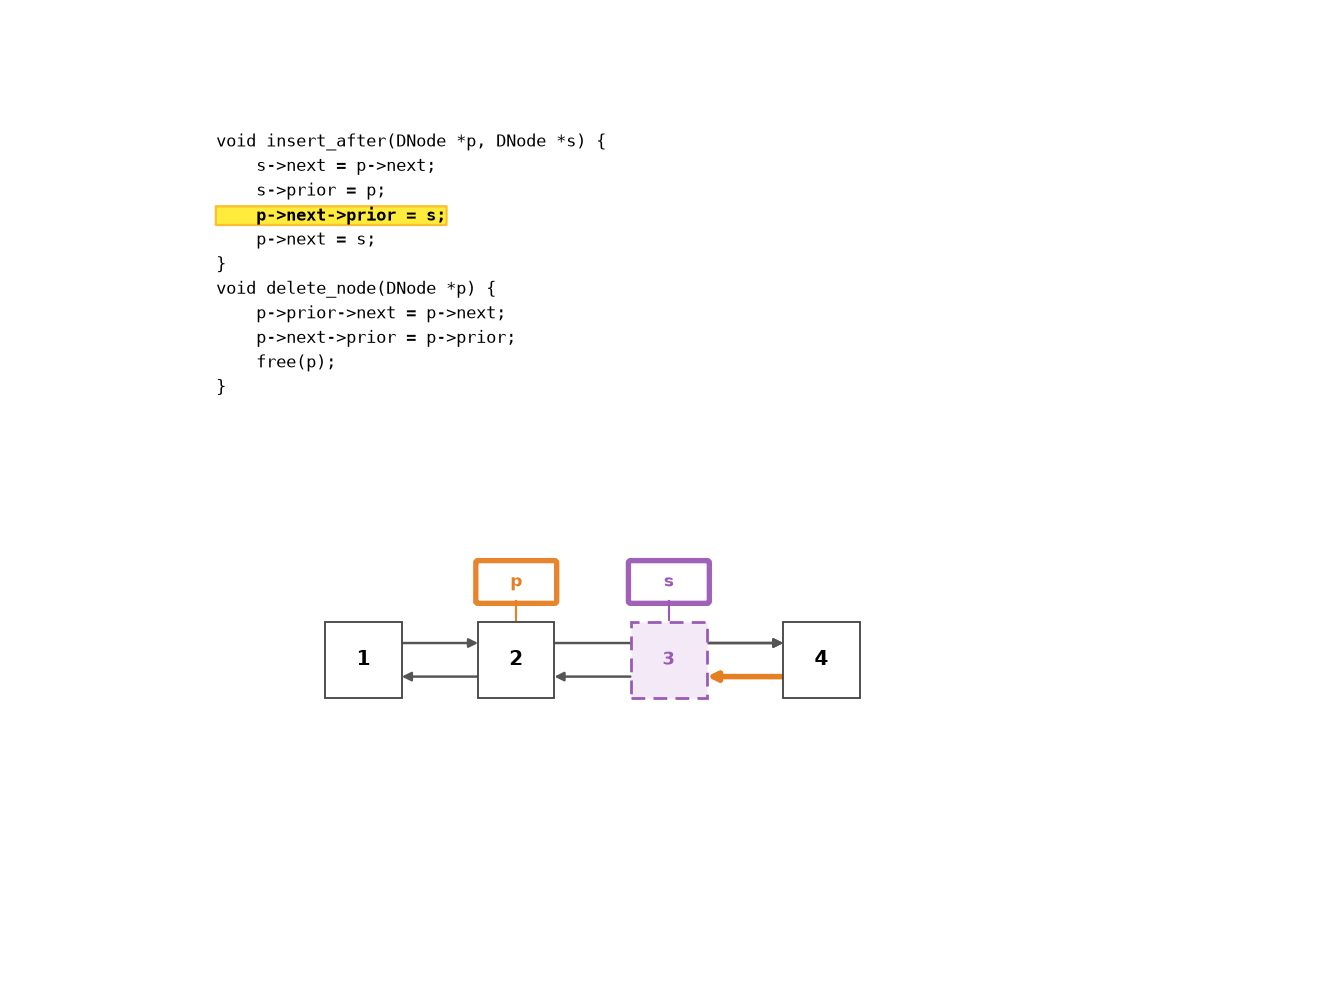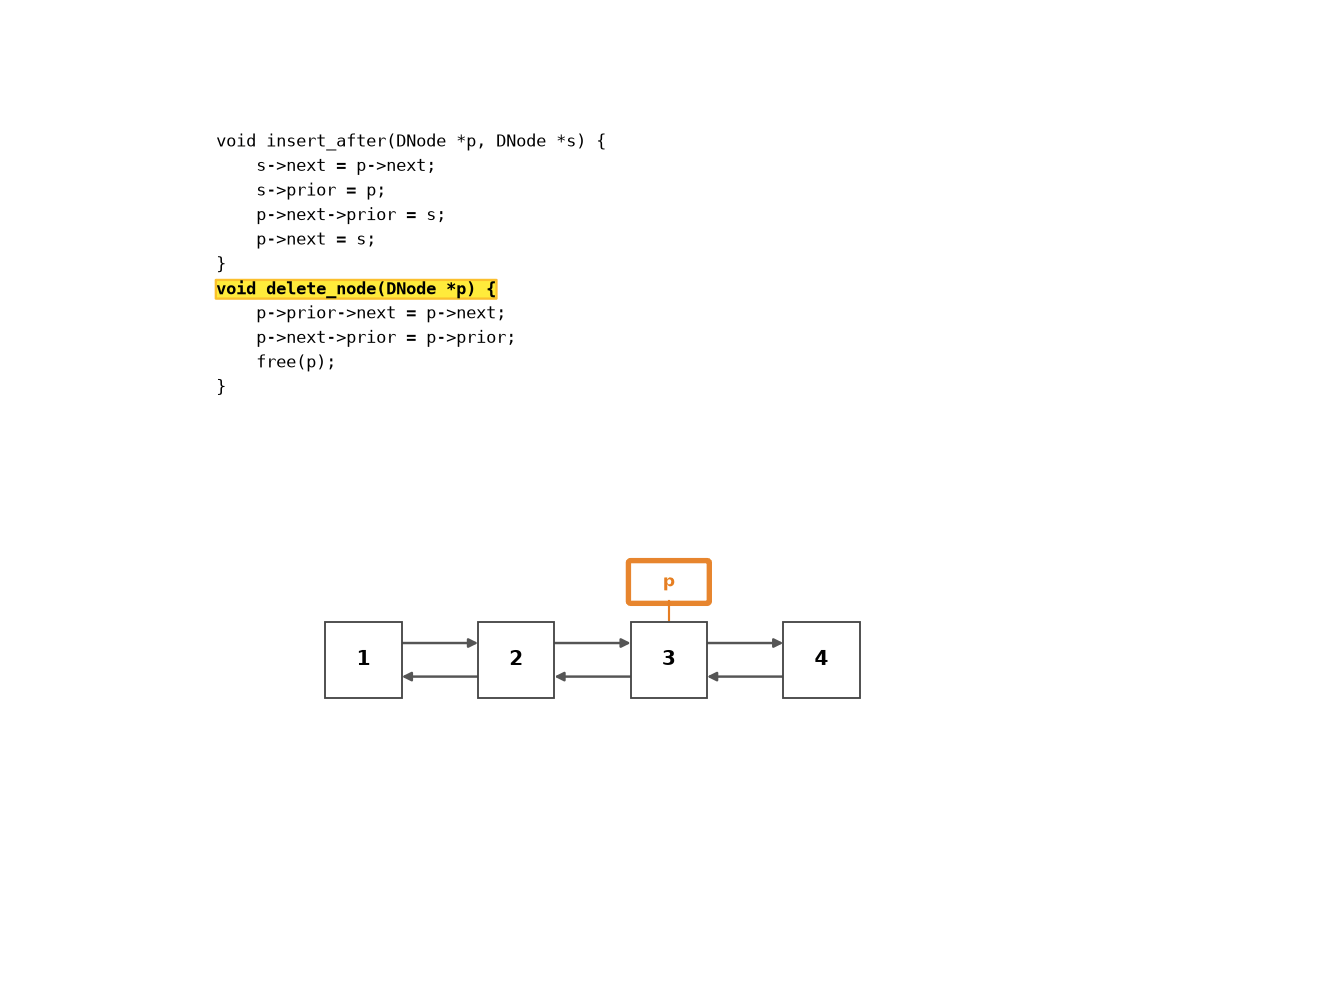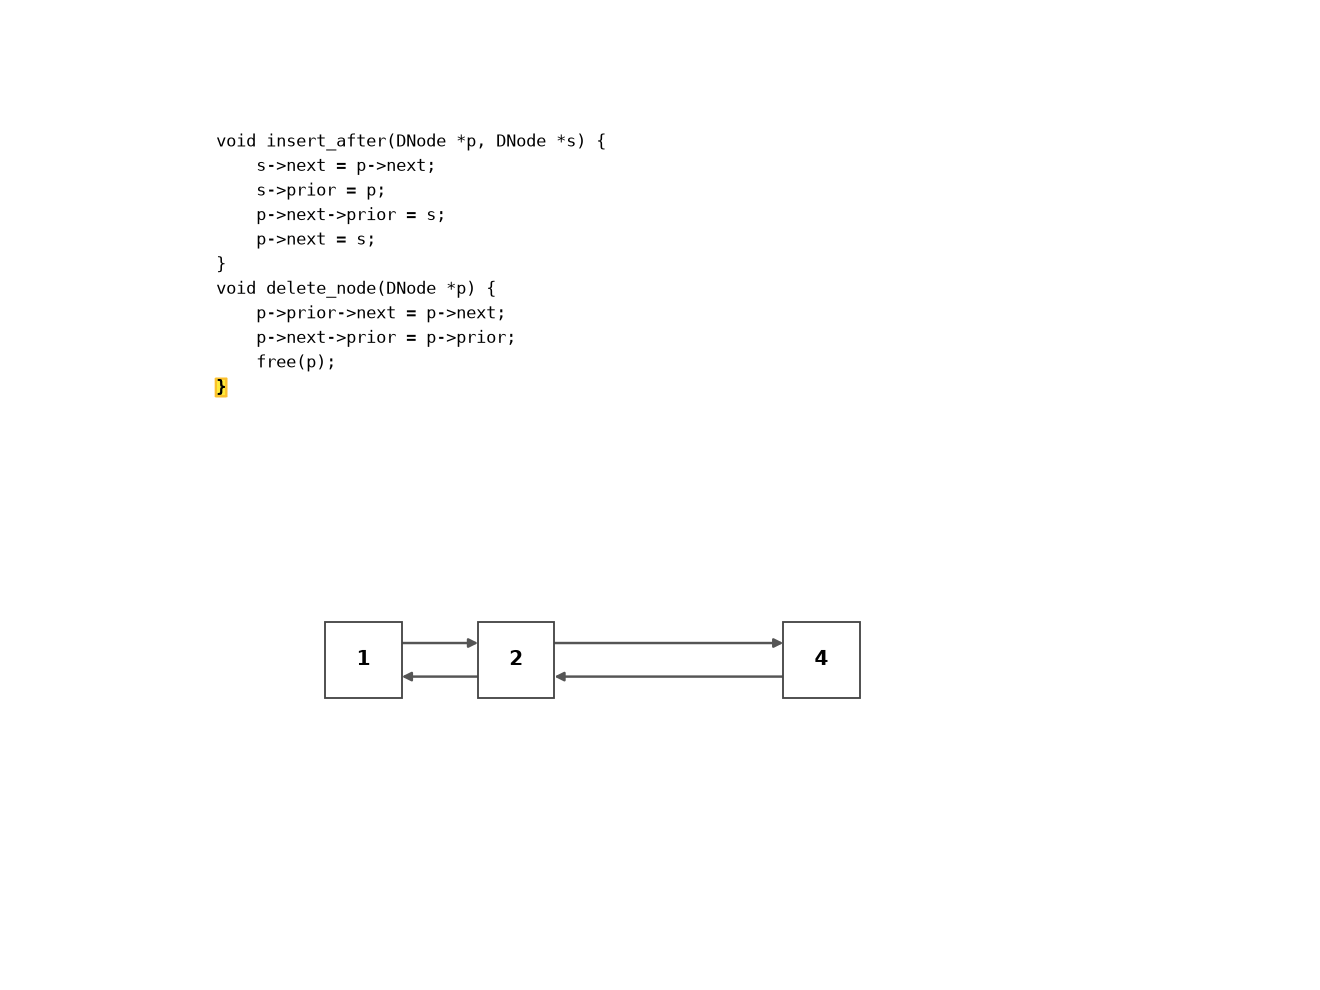
四个指针的改动顺序,记一句口诀:先在新位置把”后继”关系接好,再回头改”前驱”。
- 插入
s:①s->next = p->next(新结点接住后继)→ ②s->prev = p(指回前驱)→ ③p->next->prev = s(原后继回指新结点)→ ④p->next = s(最后才断开旧指针)。关键约束是 ① 和 ③ 都必须在 ④ 之前——④ 一旦执行,p原来的后继地址就找不到了; - 删除
p:①p->next->prev = p->prev(后继接前驱)→ ②p->prev->next = p->next(前驱接后继)→ ③free(p)。删除时两步都只读p->prev / p->next,先后其实都安全,但统一成”先接后继”不易记混,还能保证free一定在最后。
图中先演示在结点 2 之后插入结点 3(四条指针依次变化),再演示删除结点 3(两根指针改线后释放)。
带头结点(哨兵)的实现
双向链表最常用的工程写法是带哨兵——一个不存数据、让首尾自动成环的隐藏结点:
教材术语:哨兵节点通常就称为头结点。头结点不存放有效数据(或只存表长等辅助信息),其作用可以概括为三条:
- 方便首元结点的插入和删除——头指针永远指向头结点,不会因首元结点变化而需要修改头指针;
- 统一空表和非空表的处理——空表也总有一个头结点,
head->next == head即可判空;- 简化边界条件——在表头、表尾、中间插入/删除都能用同一段代码完成。
注意区分头指针与头结点:头指针是指向链表第一个结点的指针,是链表的必要入口;头结点是附加的哑结点。带头结点时头指针指向头结点;不带头结点时头指针直接指向首元结点。
有了哨兵,空表就是”哨兵自己指向自己”,插入删除不用再区分表头、表尾、空表。
需要的函数
结点与链表结构:
typedef struct DNode {
    int data;
    struct DNode *prev, *next;
} DNode;

typedef struct {
    DNode sentinel;      /* 哨兵:next 是真头,prev 是真尾 */
    int size;
} DList;初始化——让哨兵自环:
void dlist_init(DList *L) {
    L->sentinel.prev = &L->sentinel;
    L->sentinel.next = &L->sentinel;
    L->size = 0;
}插入——统一写成”在 node 之前插入”,表头和表尾都是它:
static void insert_before(DNode *node, DNode *s) {
    s->next = node;
    s->prev = node->prev;
    node->prev->next = s;
    node->prev = s;
}

/* 尾插:插到哨兵之前 */
insert_before(&L->sentinel, s);
/* 头插:插到哨兵的下一个之前 */
insert_before(L->sentinel.next, s);删除——摘掉结点,再交给调用方释放:
static void unlink_node(DNode *node) {
    node->prev->next = node->next;
    node->next->prev = node->prev;
}
/* 调用方 free(node) 并把 size 减一 */遍历——两个方向各一个,都从哨兵出发、回到哨兵结束:
void dlist_forward(DList *L) {
    for (DNode *p = L->sentinel.next; p != &L->sentinel; p = p->next)
        printf("%d ", p->data);
}

void dlist_backward(DList *L) {
    for (DNode *p = L->sentinel.prev; p != &L->sentinel; p = p->prev)
        printf("%d ", p->data);
}销毁——反复摘掉哨兵的后继,直到只剩哨兵:
void dlist_destroy(DList *L) {
    DNode *p = L->sentinel.next;
    while (p != &L->sentinel) {
        DNode *nxt = p->next;
        free(p);
        p = nxt;
    }
    dlist_init(L);
}哨兵设计的核心收益:dlist_init 后链表就处于”空但结构完备”状态(哨兵自环),insert_before 对空表、表头、表尾、中间使用同一段代码——没有 if-else 分支;代价是多一个结点、多一层间接。
循环链表
与单向链表的核心区别
把尾结点的 next 指回头结点(而不是 NULL),链表就首尾相接成环。所有区别都来自这一处改动:
| 对比点 | 单向链表 | 循环链表 |
|---|---|---|
| 尾结点 next | NULL | 指回 head(或哨兵) |
| 遍历终点 | p == NULL | 回到起点(p == head) |
| 遍历写法 | while (p != NULL) | do { ... } while (p != head) |
| 判空 | head == NULL / head->next == NULL | 见下面判空表 |
| 从任意结点出发 | 只能向前走到尾 | 能绕行全表 |
核心代码差异就是”把 NULL 换成 head”:
/* 单向链表遍历 */
for (Node *p = head; p != NULL; p = p->next) visit(p);

/* 循环链表遍历:先做一次,回到 head 才停 */
if (head == NULL) return;
Node *p = head;
do {
    visit(p);
    p = p->next;
} while (p != head);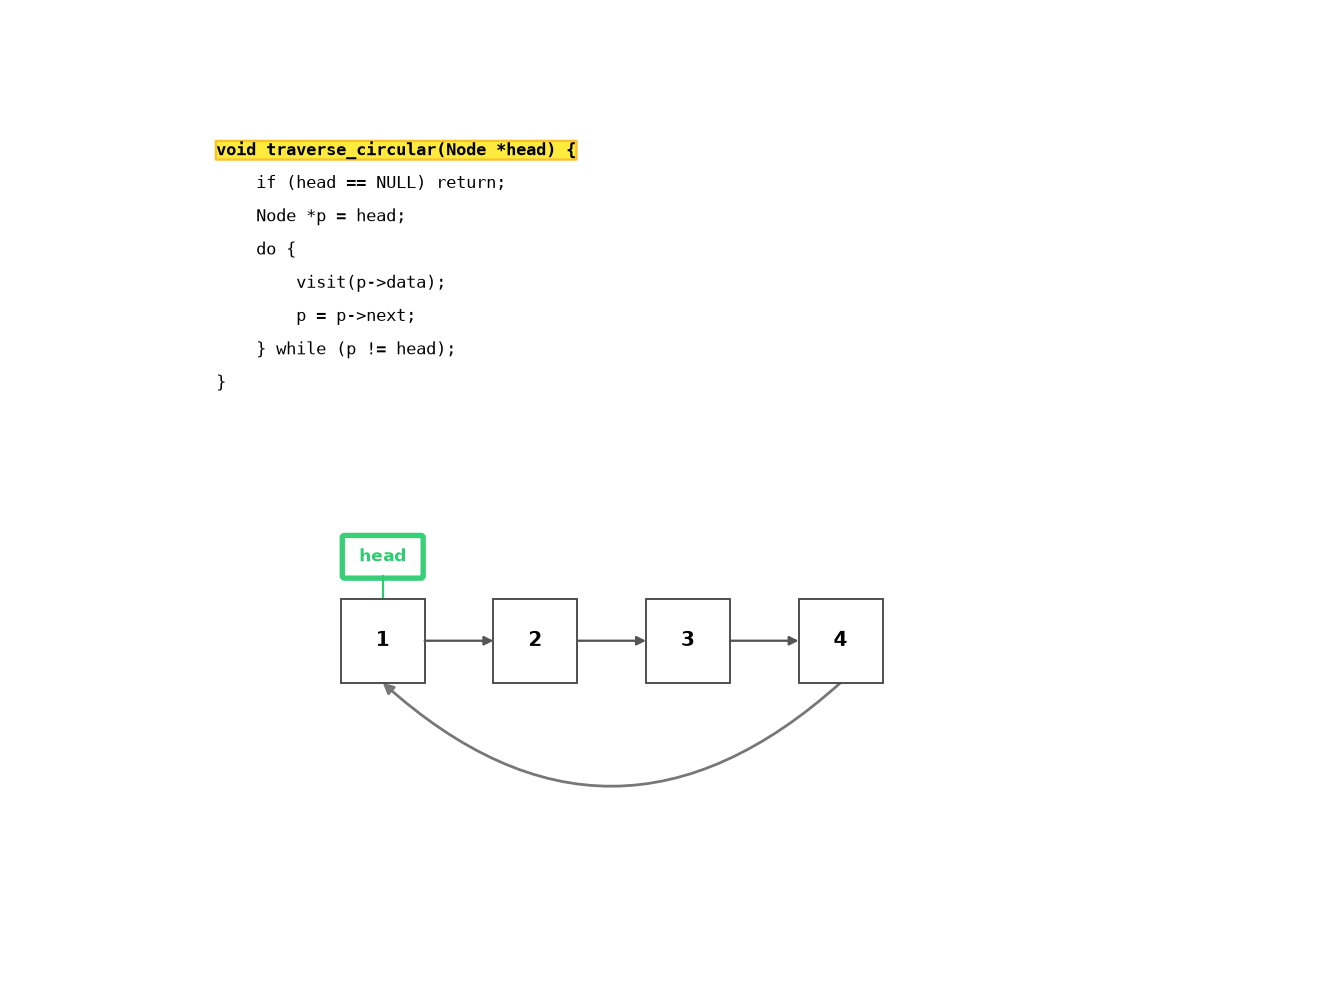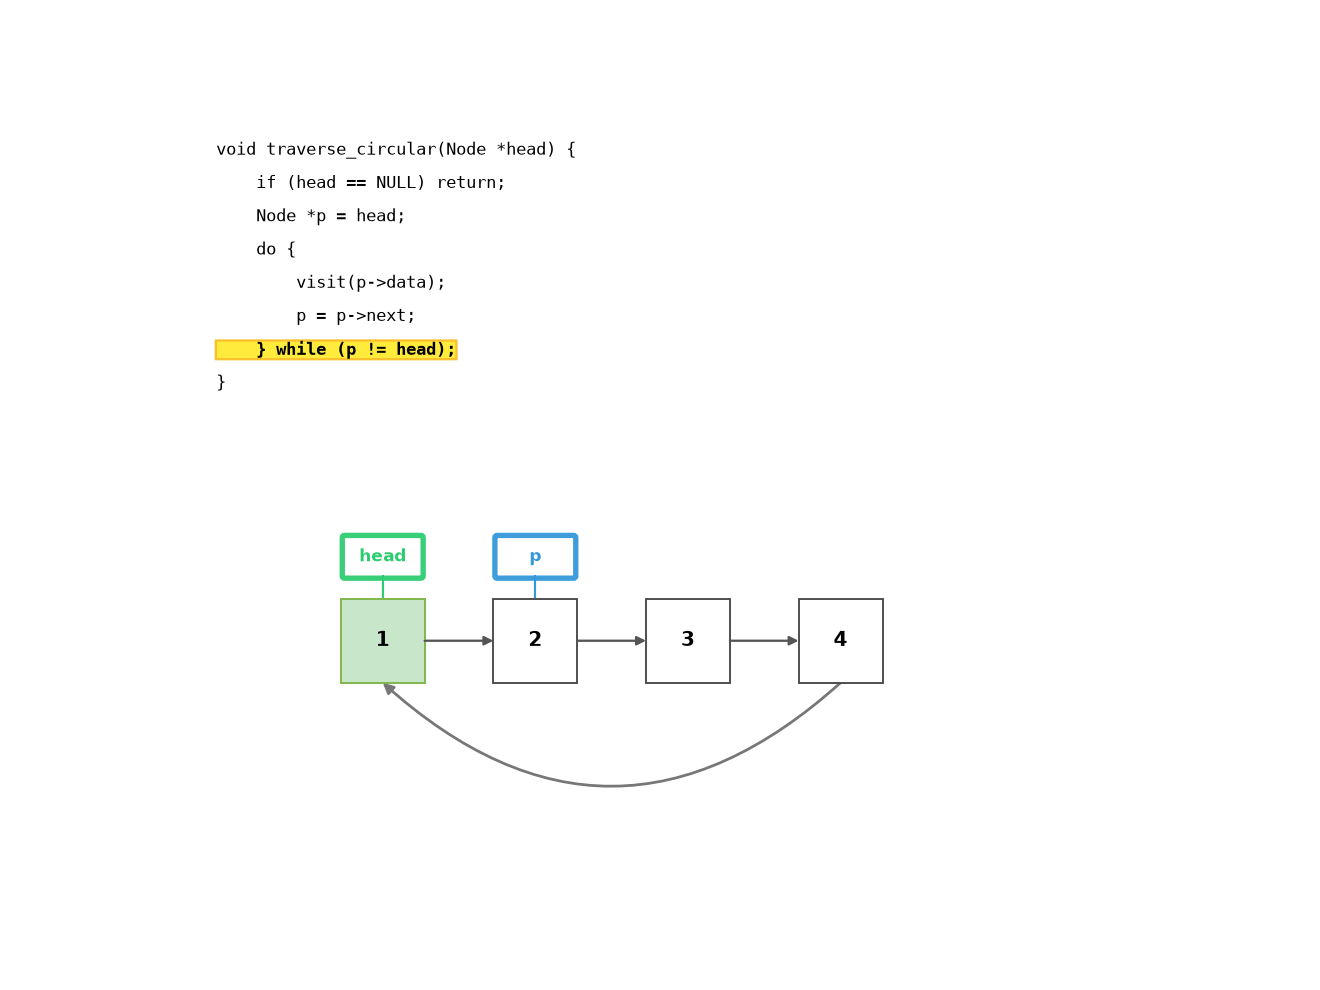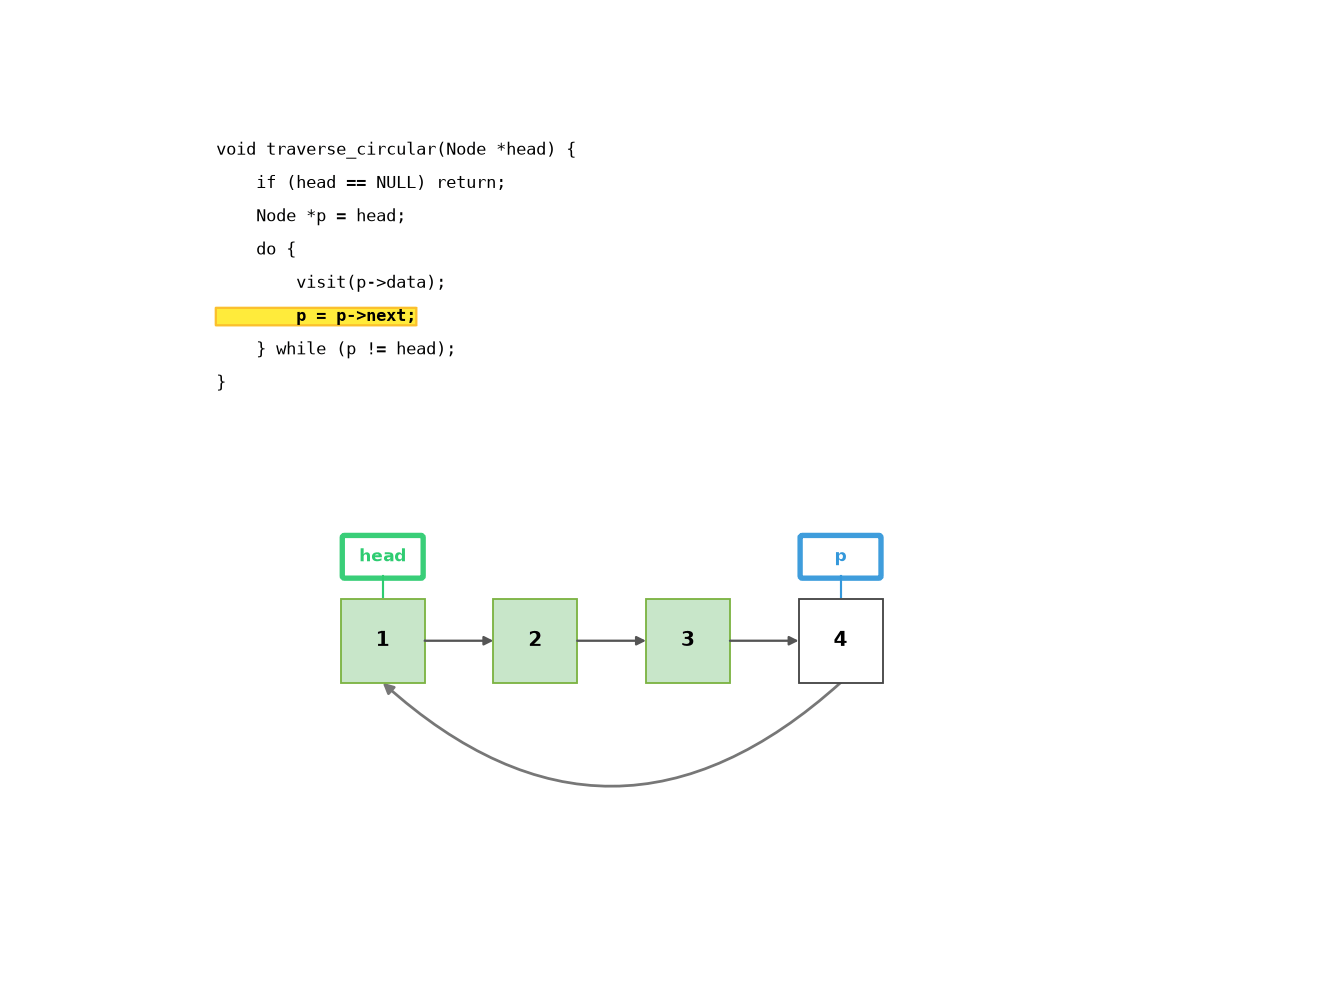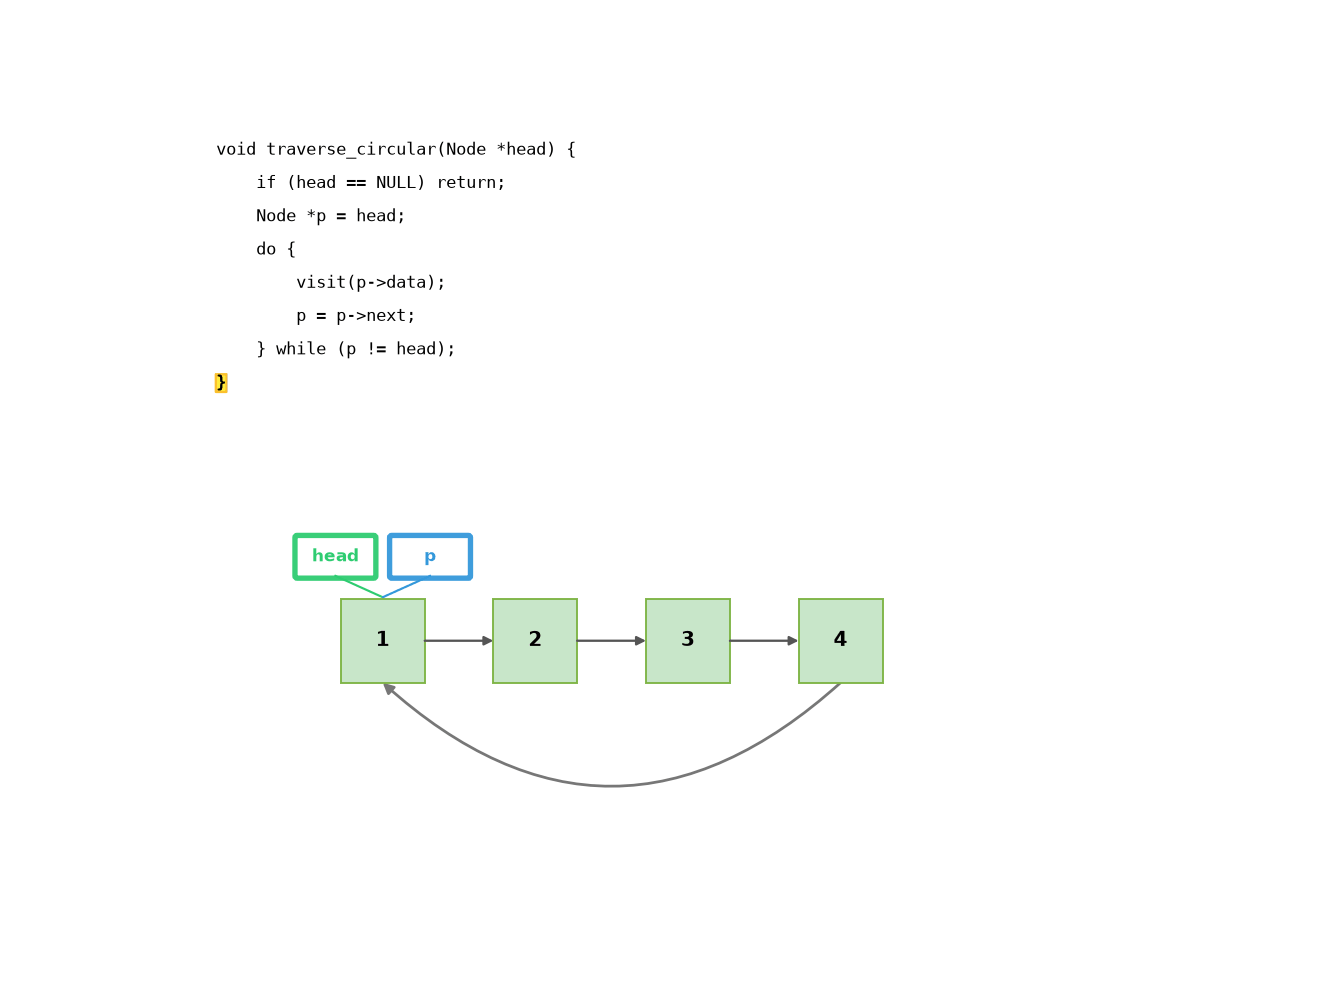
图中的 p 依次走过 1→2→3→4,回到 1 才停止——循环链表没有 NULL 终点,只能”绕一圈回到起点”来终止。
判空与单元素条件
判空条件随形态不同,而且”只有一个元素结点”的判断常常紧跟着一起考:
| 形态 | 判空 | 只有一个元素结点 | 特点 |
|---|---|---|---|
| 循环单链表(不带头结点) | head == NULL | head->next == head | 尾节点 next 指回 head |
| 循环单链表(带头结点) | head->next == head | head->next->next == head | 从任意结点出发可达全表 |
| 循环双链表(带头结点) | head->next == head | head->next != head && head->next->next == head | head->prev 即尾结点,头尾操作全 |
注意”单元素”的判断必须带上前半句 head->next != head:只写 head->next->next == head 的话,空表(head->next == head,此时 head->next->next 也等于 head)会被误判成”有一个元素”。
需要的函数
成环——普通尾插的最后加一行即可:
tail->next = head; /* 尾接首,成环 */在 p 之后插入——写法和单链表一样;如果 p 是原来的尾结点,插入后 s 自动成为新的尾结点,链表依然成环:
void insert_after(Node *p, Node *s) {
    s->next = p->next;
    p->next = s;
}
删除 p 的后继——需要前驱;循环链表有个招牌技巧,可以做到”只给 p 也能 删除 p”:
void delete_after(Node *p) {
    Node *q = p->next;
    p->next = q->next;
    free(q);
}
/* 只给 p、要删除 p 本身时:删 p 的后继 q,
再把 q 的 data 拷回 p——用数据换位代替指针重排 */遍历就是上面的 do-while;销毁时终止条件同样要写成”回到 head”,不能等 NULL。
循环双链表正是深入底层节 Linux 内核 list_head 的形态——知道任何一个节点就能 到达头、尾并自删,这就是”对称性允许在不知道容器头部的情况下执行删除”的结构基础。
带尾指针的循环单链表
进程就绪队列、时间轮这类场景常用带头结点 + 尾指针 rear 的循环单链表:rear 指向尾结点,于是 rear->next 是头结点,而首元结点是 rear->next->next。
graph LR
    H["头结点 head"] --> A["a1 首元"] --> B["a2"] --> C["a3 尾"]
    C -->|"next 指回头结点,成环"| H
    R["rear 尾指针"] -.-> C
有了尾指针,表尾操作和表头操作都变成了”一个指针的活”:
typedef struct Node {
    int data;
    struct Node *next;
} Node;

/* 判空:只剩头结点 */
int empty(Node *head) { return head->next == head; }

/* 取首元结点:注意是 rear->next(头结点)的下一个 */
Node* first(Node *rear) { return rear->next->next; }

/* 尾插:新结点接回头结点,再把原尾结点指向它 */
void push_back(Node *head, Node **rear, int x) {
    Node *s = (Node *)malloc(sizeof(Node));
    s->data = x;
    s->next = head;             /* 新结点接回头结点,保持成环 */
    (*rear)->next = s;          /* 原尾结点指向新结点 */
    *rear = s;                  /* 更新尾指针 */
}真正容易错的是删除首元结点:删掉之后链表变短,一般只要 head->next = q->next;;但如果链表只剩一个元素,删完就变空,尾指针还指着那个已经被释放的结点,必须把它收回头结点:
/* 删除首元结点:q 是首元结点,rear 是尾指针 */
int pop_front(Node *head, Node **rear) {
    Node *q = head->next;             /* 首元结点 */
    if (q == head) return -1;         /* 空表 */
    head->next = q->next;             /* 头结点跳过 q */
    if (q == *rear) *rear = head;     /* ① 只有一个元素:尾指针收回 */
    free(q);
    return 0;
}
if (q == *rear) *rear = head; 就是这一结构的经典边界。若把 rear 写成局部指针、头指针写成 h,它就是教材里更紧凑的那句 if (p == q) p = h;——p 是尾指针、q 是首元结点、h 是头结点,含义相同:删到只剩一个元素时,尾指针必须重新指向头结点。
有了尾指针,尾插 、取尾结点 ;但删除尾结点仍然要 ——循环单链表只靠单指针找不到尾结点的前驱。这也正是”带头结点双循环链表”存在的理由:它用两个方向换取尾删也能 。
经典应用:约瑟夫问题——n 人围成一圈,从第 1 人开始报数,数到 m 的人出列,下一人重新从 1 报起,求出列顺序与幸存者。普通单链表每次走到尾部都要 回跳到头,循环结构天然衔接:
// 约瑟夫问题:打印出列序列,n 人报数、数到 m 出列
void josephus(int n, int m) {
    ListNode* head = malloc(sizeof(ListNode));   // 建环:1..n
    head->data = 1;
    ListNode* tail = head;
    for (int i = 2; i <= n; i++) {
        tail->next = malloc(sizeof(ListNode));
        tail->next->data = i;
        tail = tail->next;
    }
    tail->next = head;                    // 成环

    ListNode* prev = tail;                // prev 始终指向当前报数人的前驱
    while (prev->next != prev) {          // 圈内还剩多于一人
        for (int cnt = 1; cnt < m; cnt++) // 走 m-1 步,停在报数为 m 者的前驱
            prev = prev->next;
        ListNode* out = prev->next;
        printf("%d ", out->data);
        prev->next = out->next;           // 摘除出列者
        free(out);
    }
    printf("幸存者: %d\n", prev->data);   // 最后剩下的节点
}手算示范:n=5、m=3 → 出列顺序 3, 1, 5, 2,最后只剩 4——它就是幸存者。逐步验证:从 1 报起数到 3 → 3 出列;从 4 数到 3(4,5,1)→ 1 出列;从 2 数到 3(2,4,5)→ 5 出列;剩 (2,4),从 2 数三下(2,4,2)→ 2 出列;幸存 4。
自测:循环链表
① n=6、m=2 的约瑟夫问题,写出完整出列顺序与幸存者。
② 带哨兵的循环双链表 L,如何 O(1) 访问首节点和尾节点?判空条件是什么?
③ 循环单链表(不带哨兵)中,只给指针 p 指向某节点,能否在 O(1) 内把它插入为表头?
答案:
① 从 1 报起:数到 2 → 2 出列;3,4 → 4 出列;5,6 → 6 出列;1,3 → 3 出列;剩 (1,5),5,1 → 1 出列。顺序 2, 4, 6, 3, 1,幸存者 5。
② 首节点L.next、尾节点L.prev——哨兵的两个方向各直达一端;判空L.next == &L。
③ 能,且这正是循环链表的招牌技巧:把新节点插到 p 之后(O(1)),然后交换两节点的 data 字段——新数据落位表头语义,原 p 的数据顺移到新节点。数据换位代替指针重排,无需遍历找前驱。
快慢指针 --- 环检测与中点查找
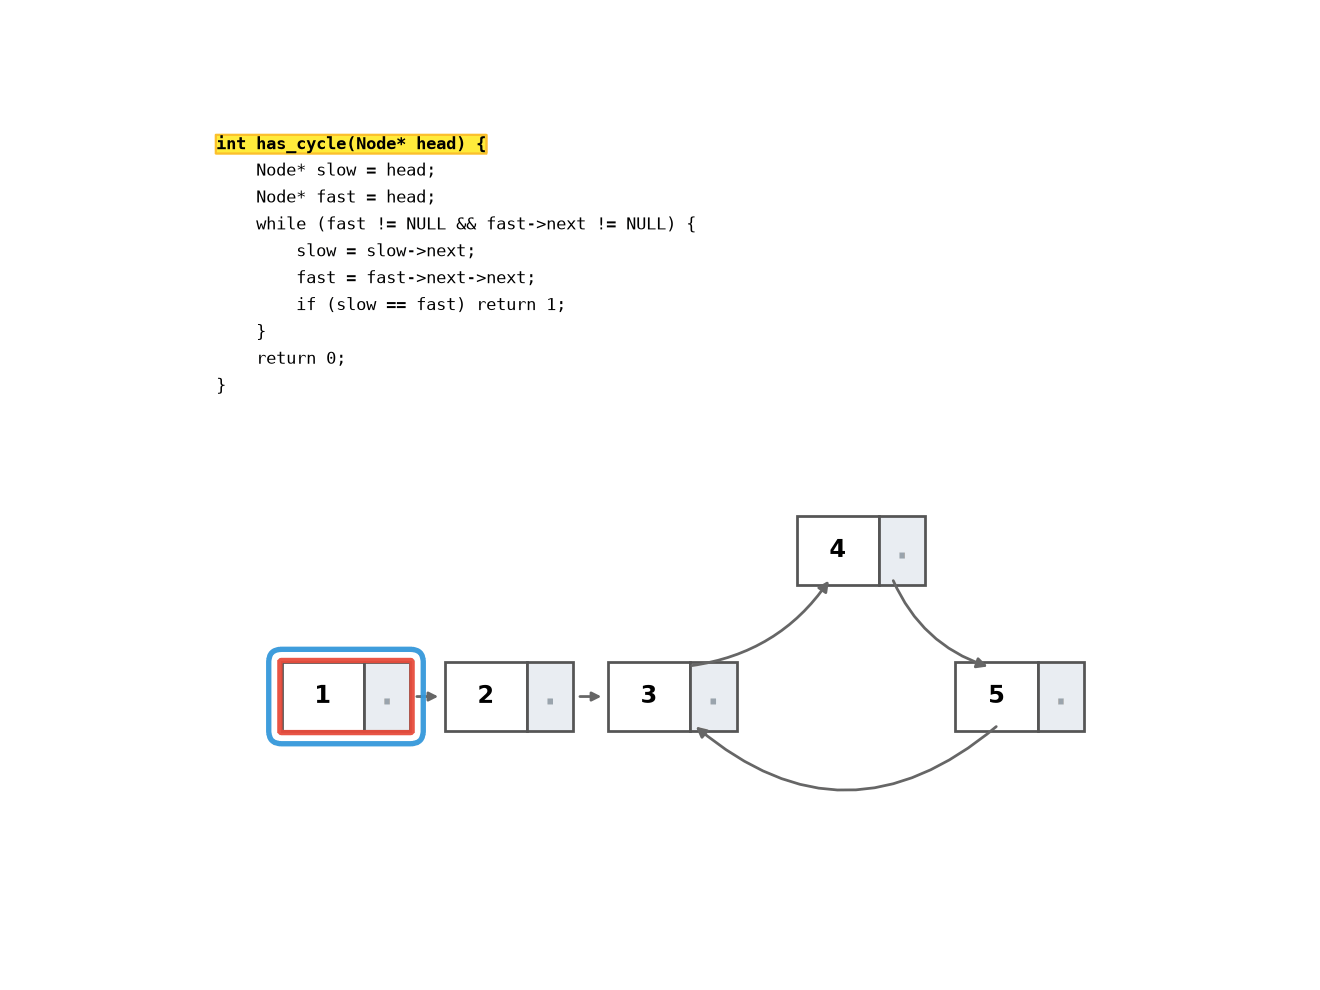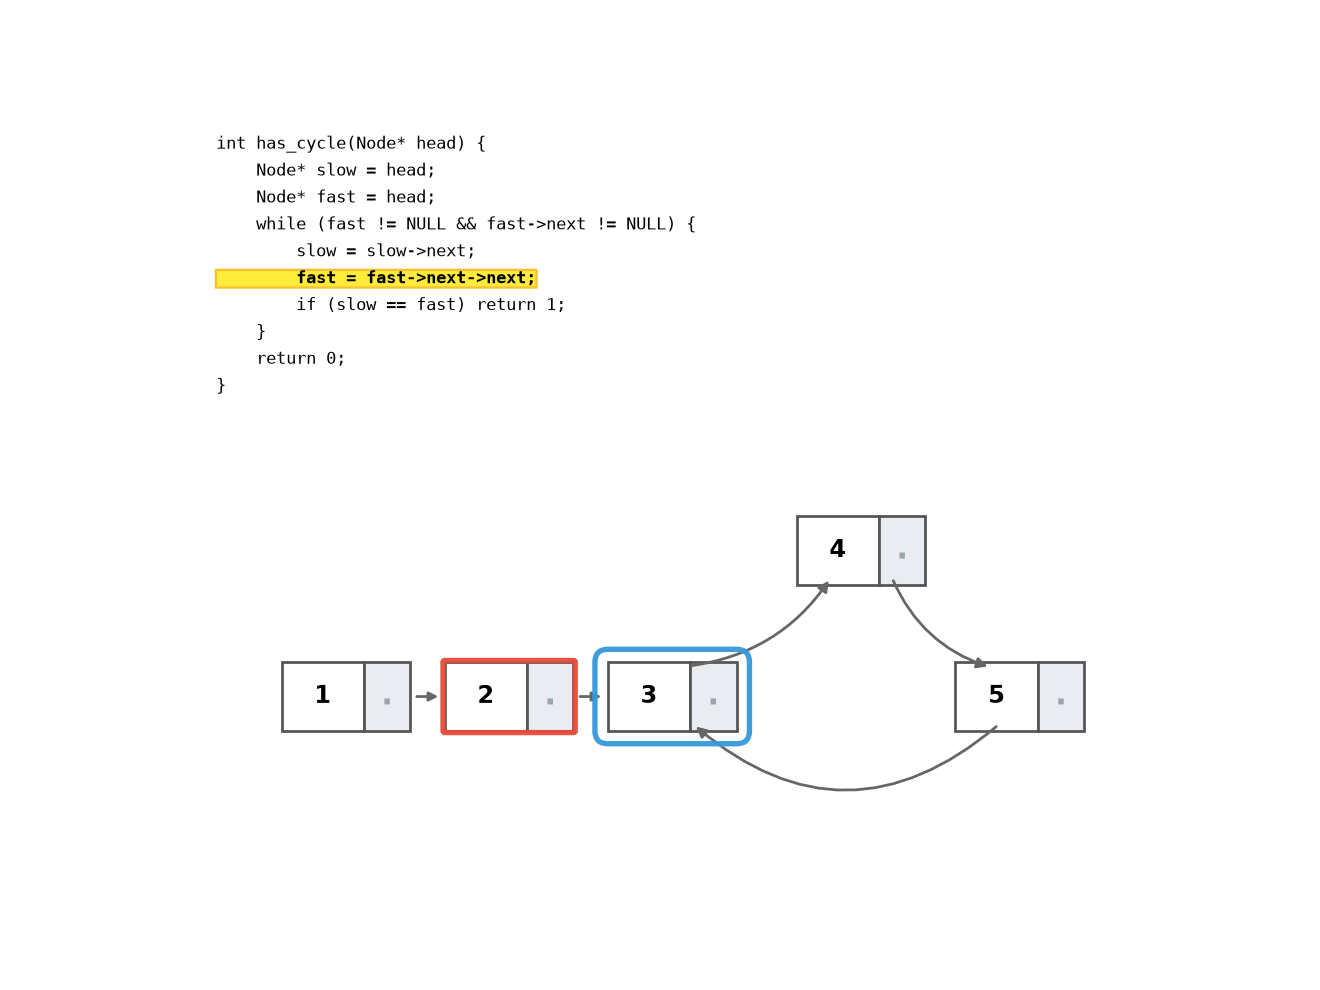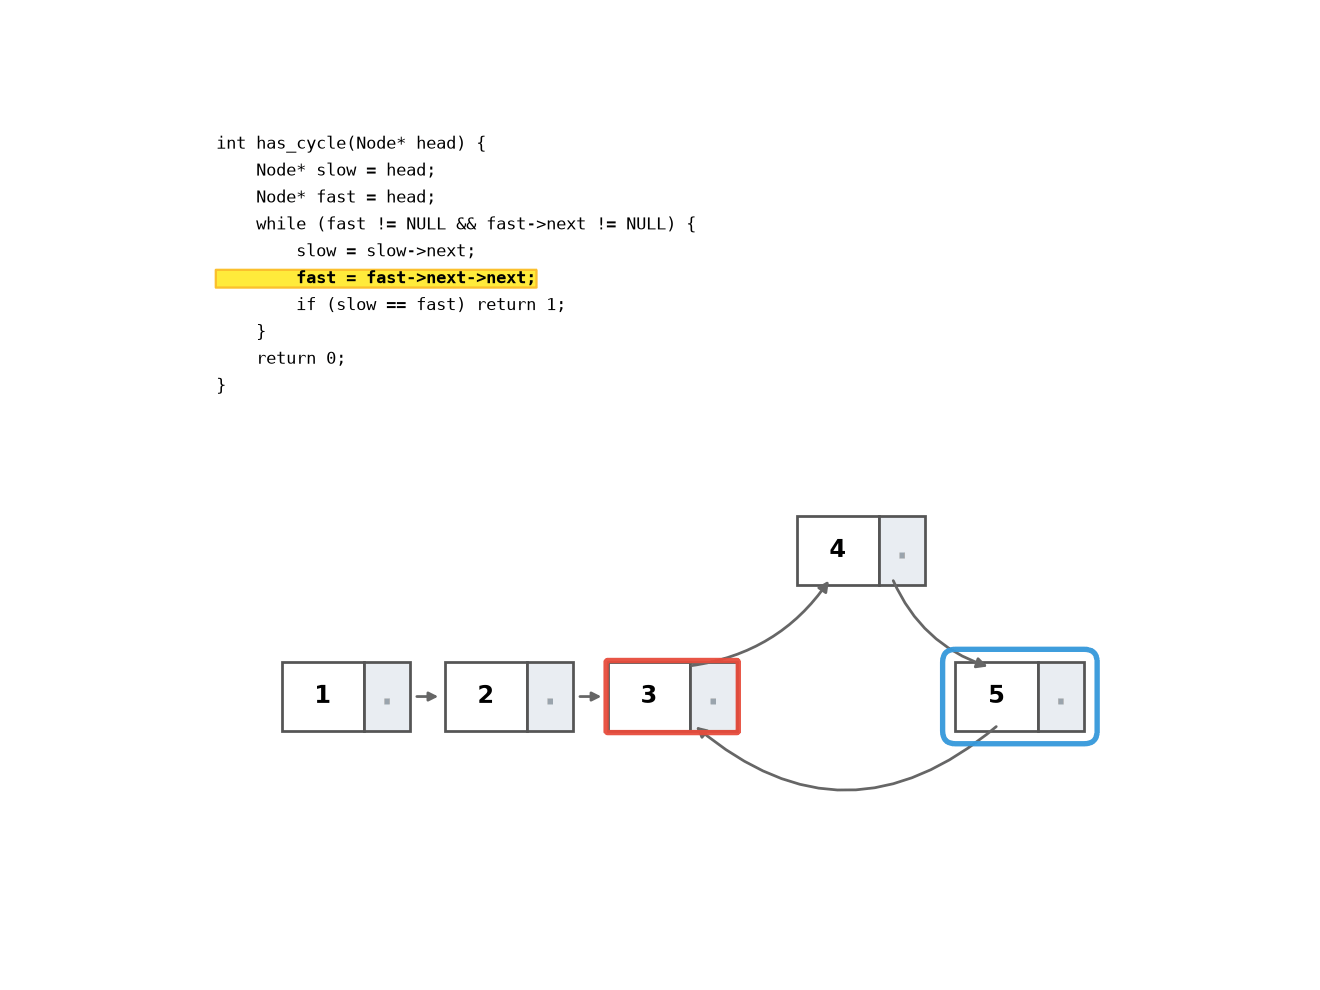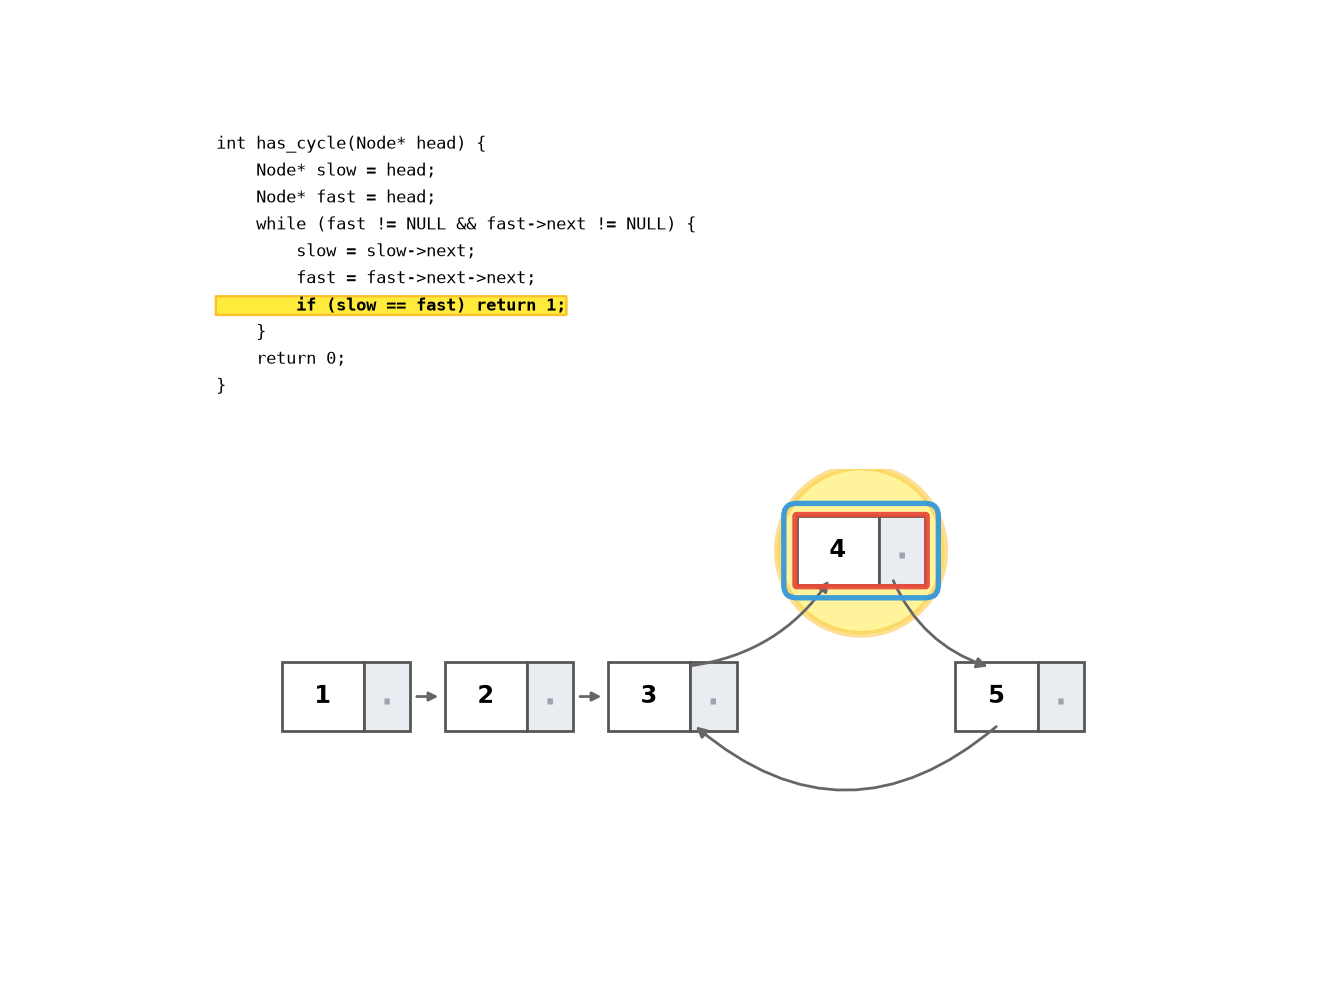
typedef struct ListNode {
 int data;
 struct ListNode* next;
} ListNode;

// Floyd's cycle detection (tortoise and hare)
int has_cycle(ListNode* head) {
 ListNode *slow = head, *fast = head;
 while (fast && fast->next) {
 slow = slow->next;
 fast = fast->next->next;
 if (slow == fast) return 1; // 相遇 = 有环
 }
 return 0;
}

// 确定环的入口: Floyd 算法的第二阶段
// 相遇后,slow 退回 head,两者同速度前进,再次相遇即环入口
ListNode* detect_cycle_entry(ListNode* head) {
 ListNode *slow = head, *fast = head;
 while (fast && fast->next) {
 slow = slow->next;
 fast = fast->next->next;
 if (slow == fast) { // 第一阶段:确认有环
 slow = head; // 第二阶段:slow 回起点
 while (slow != fast) {
 slow = slow->next;
 fast = fast->next; // 两者同速
 }
 return slow; // 再次相遇 = 环入口
 }
 }
 return NULL;
}

ListNode* find_middle(ListNode* head) {
 ListNode *slow = head, *fast = head;
 while (fast && fast->next) {
 slow = slow->next;
 fast = fast->next->next;
 }
 return slow; // fast 到达末尾时,slow 正好到中间
}
Floyd 算法的数学保证基于模运算:设非环部分长度为 ,环长度为 。第一阶段相遇时,fast 比 slow 多走了 步(恰好多走整数圈)。slow 从 head 到相遇点走了 步,fast 走了 步,且 ,即 。slow 在环内,距环入口为 。第二阶段 slow 从 head 再走 步到达环入口,fast 从相遇点走 步(,即刚好到达环入口),两者同时抵达。因此再次相遇位置就是环入口。
高频考点(含历年设计题)
下面这些是历年统考和面试反复出现的模板,值得默写到肌肉记忆。先看真题索引:
| 年份 | 题号 | 题目 | 本题解位置 |
|---|---|---|---|
| 2009 | 42 | 单链表倒数第 k 个结点 | 倒数第 k 个节点(2009 年 408 第 42 题) |
| 2012 | 42 | 两个单词链表的共同后缀 | 两个链表的共同后缀(2012 年 408 第 42 题) |
| 2015 | 41 | 删除单链表中绝对值重复的结点 | 删除绝对值重复的节点(2015 年 408 第 41 题) |
| 2019 | 41 | 重排链表 | 链表重排(2019 年 408 第 41 题) |
倒数第 k 个节点(2009 年 408 第 42 题)
真题题干:
已知一个带有表头结点的单链表,结点结构为
[data|link]。假设该链表只给出了头指针list。在不改变链表的前提下,请设计一个尽可能高效的算法,查找链表中倒数第 k 个位置上的结点(k 为正整数)。若查找成功,算法输出该结点的 data 域的值,并返回 1;否则,只返回 0。要求:(1) 描述算法的基本设计思想;(2) 描述算法的详细实现步骤;(3) 根据设计思想和实现步骤,采用程序设计语言描述算法(使用 C、C++ 或 Java 语言实现),关键之处请给出简要注释。
考察内容:一趟遍历的双指针技巧(快慢指针相差 k 步);同时要处理头结点与”k 超过表长”的边界。
快慢指针拉开 k 的间隔,fast 到达末尾时 slow 恰在倒数第 k:
// 返回倒数第 k 个节点(k 从 1 起算);链长短于 k 返回 NULL
ListNode* kth_from_end(ListNode* head, int k) {
    ListNode *fast = head, *slow = head;
    while (k-- > 0) {
        if (!fast) return NULL;      // 提前越界检查
        fast = fast->next;
    }
    while (fast) { fast = fast->next; slow = slow->next; }
    return slow;
}
一趟遍历完成,无需先数长度再二次扫描——这是考试偏爱的解法。
自测:链表 1→2→3→4→5、k=2,写出 fast/slow 的完整轨迹。
答案:预备阶段 fast 先走 2 步停在 3;随后同步前进——fast=4/slow=2 → fast=5/slow=3 → fast=NULL/slow=4。slow 停在 4,正是倒数第 2 个。
合并两个有序链表(教材经典题)
归并排序 merge 在链表上的翻版;哑结点让结果首节点不再特判:
ListNode* merge_sorted(ListNode* a, ListNode* b) {
    ListNode dummy = {0, NULL};
    ListNode* tail = &dummy;
    while (a && b) {
        if (a->data <= b->data) { tail->next = a; a = a->next; }
        else                    { tail->next = b; b = b->next; }
        tail = tail->next;
    }
    tail->next = a ? a : b;          // 一句接走剩余整段
    return dummy.next;
}
时间 。核心要点:循环结束后 tail->next = a ? a : b——漏掉这句是最常见的失分点。
如果要合并成降序,把每次选出的较小结点用头插法挂到结果表头即可(不必再维护 tail):
ListNode* merge_desc(ListNode* a, ListNode* b) {
    ListNode* head = NULL;
    while (a && b) {
        ListNode* s;
        if (a->data <= b->data) { s = a; a = a->next; }
        else                    { s = b; b = b->next; }
        s->next = head;          /* 头插:逆序,因此得到降序 */
        head = s;
    }
    while (a) { ListNode* s = a; a = a->next; s->next = head; head = s; }
    while (b) { ListNode* s = b; b = b->next; s->next = head; head = s; }
    return head;
}
比较指针最多走 步,时间仍是 ;大 记号下 与 等价(因为 )。尾插保值、头插逆序——这道题把两条结论一次考全。
自测:合并 1→3→5 与 2→4,写出每步 tail->next 的取值与收尾动作。
答案:1≤2 取 1;3>2 取 2;3≤4 取 3;5>4 取 4;此时 a 剩 5、b 为空 → 接上整段 5。结果 1→2→3→4→5。
回文链表(与 2019 年 41 题同套路)
三步模板:找中点 → 逆转后半段 → 双向比对,全程 O(1) 额外空间:
int is_palindrome(ListNode* head) {
    if (!head || !head->next) return 1;
    // ① 快慢指针找中点:slow 停在前半段的最后一个节点
    ListNode *slow = head, *fast = head;
    while (fast->next && fast->next->next) {
        slow = slow->next;
        fast = fast->next->next;
    }
    // ② 逆转后半段
    ListNode *second = slow->next, *prev = NULL;
    slow->next = NULL;
    while (second) {
        ListNode* nxt = second->next;
        second->next = prev;
        prev = second;
        second = nxt;
    }
    // ③ 前半段与逆序的后半段逐对比较(后半段更短或等长)
    ListNode *p = head, *q = prev;
    while (q) {
        if (p->data != q->data) return 0;
        p = p->next; q = q->next;
    }
    return 1;
}
注意 while (fast->next && fast->next->next) 让 slow 停在前半段末尾而非正中——奇偶长度都能正确切分。若题目只要求判断且允许额外空间,复制进数组再双指针更简单,但面试与考试的标准答案是这个 O(1) 空间版本。
自测:判断 1→2→3→2→1 是否回文,写出切分点与两段内容。
答案:slow 最终停在中间的 3(fast 被条件挡在末节点);前半 1→2→3,后半逆转后 1→2;逐对比较 1=1、2=2 全部相等 → 是回文。
分隔链表(模板题)
保持相对次序地把 < x 与 ≥ x 分成两条链再拼接:
ListNode* partition(ListNode* head, int x) {
    ListNode small_d = {0, NULL}, great_d = {0, NULL};
    ListNode *s = &small_d, *g = &great_d;
    while (head) {
        if (head->data < x) { s->next = head; s = s->next; }
        else                { g->next = head; g = g->next; }
        head = head->next;
    }
    s->next = great_d.next;   // 小链尾接大链头
    g->next = NULL;           // 大链必须封口!
    return small_d.next;
}
两个哑结点 + 尾插天然保序。陷阱在大链封口:原链表中大链尾节点的 next 可能还挂着小链成员,不置 NULL 就会成环——这是本题最隐蔽的错误来源。
自测:把 1→4→3→2→5→2 按 x=3 分隔,写出两条临时链的形成过程与最终结果。
答案:<3 链依次收集 1、2、2;≥3 链依次收集 4、3、5。拼接得 1→2→2→4→3→5——两组内部各自保持原有相对次序。
两个链表的共同后缀(2012 年 408 第 42 题)
真题题干:
假定采用带头结点的单链表保存单词,当两个单词有相同的后缀时,则可共享相同的后缀存储空间,例如 “loading” 和 “being” 共享 “ing” 的存储。设 str1 和 str2 分别指向两个单词所在单链表的头结点,链表结点结构为
[data|next]。请设计一个时间上尽可能高效的算法,找出由 str1 和 str2 所指向两个链表共同后缀的起始位置。要求:(1) 给出算法的基本设计思想;(2) 根据设计思想,采用 C 或 C++ 或 Java 语言描述算法,关键之处给出注释;(3) 说明你所设计算法的时间复杂度。
考察内容:链表长度差 + 同步前进;核心是发现”共享后缀必然是 Y 形”这一结构性质。
思路:共享后缀只可能是”Y 形”而不是”X 形”——两个链表一旦在某个结点重合,之后所有结点都相同。所以先求两个链表的长度差,让长链表先走差值步,再同步前进,第一次指针相同的位置就是答案。
ListNode* common_suffix(ListNode* a, ListNode* b) {
    int la = 0, lb = 0;
    for (ListNode* p = a; p; p = p->next) la++;
    for (ListNode* p = b; p; p = p->next) lb++;
    ListNode *p = a, *q = b;
    while (la > lb) { p = p->next; la--; }   /* 长表先走差值步 */
    while (lb > la) { q = q->next; lb--; }
    while (p != q) { p = p->next; q = q->next; }
    return p;                                 /* 同步走到重合点 */
}
时间 ,空间 。
常见错误:想用”逆序后比较”或双重循环——前者会改动链表结构,后者是 。
删除绝对值重复的节点(2015 年 408 第 41 题)
真题题干:
用单链表保存 m 个整数,结点的结构为
[data|link],且 (n 为正整数)。现要求设计一个时间复杂度尽可能高效的算法,对于链表中 data 的绝对值相等的结点,仅保留第一次出现的结点而删除其余绝对值相等的结点。例如,若给定的单链表 head 为head→21→-15→-15→-7→15,则删除结点后的 head 为head→21→-15→-7。要求:(1) 给出算法的基本设计思想;(2) 使用 C 或 C++ 语言给出算法,关键之处给出注释;(3) 说明你所设计算法的时间复杂度。
考察内容:值域受限时用辅助数组记录”是否出现过”,时间 ;对比不借助辅助空间的 暴力法,体会”用空间换时间”。
思路:因为值域有限(),开一个大小为 的标记数组——出现过的绝对值打标记,再次出现就删除。典型的”用空间换时间”。
void delete_abs_dup(ListNode** head, int n) {
    int* seen = calloc(n + 1, sizeof(int));   /* 全 0 */
    ListNode dummy = {0, *head};              /* 哑结点,统一处理首元结点 */
    ListNode* prev = &dummy;
    while (prev->next) {
        ListNode* cur = prev->next;
        int v = cur->data < 0 ? -cur->data : cur->data;
        if (seen[v]) {
            prev->next = cur->next;           /* 删除 cur */
            free(cur);
        } else {
            seen[v] = 1;
            prev = cur;
        }
    }
    *head = dummy.next;
    free(seen);
}
时间 ,空间 。如果没有值域限制,就得改用哈希表,思路完全一样。
链表重排(2019 年 408 第 41 题)
真题题干:
设线性表 采用带头结点的单链表保存,链表中结点定义如下:
typedef struct node {
    int data;
    struct node *next;
} NODE;
请设计一个空间复杂度为 且时间上尽可能高效的算法,重新排列 L 中的各结点,得到线性表 。要求:(1) 给出算法的基本设计思想;(2) 根据设计思想,采用 C 或 C++ 语言描述算法,关键之处给出注释;(3) 说明你所设计算法的时间复杂度。
考察内容:综合运用”快慢指针找中点、原地逆置、合并链表”三个基本操作;考点是能否把大问题拆解成已经掌握的小操作。
思路:三步走,全部是练过的基础操作——找中点、逆置后半、交替合并。
void reorder(ListNode* head) {
    if (!head || !head->next) return;
    ListNode *slow = head, *fast = head;       /* 1. 找中点 */
    while (fast->next && fast->next->next) {
        slow = slow->next;
        fast = fast->next->next;
    }
    ListNode* mid = slow->next;
    slow->next = NULL;                         /* 切成前后两段 */

    ListNode* prev = NULL;                     /* 2. 逆置后半段 */
    while (mid) {
        ListNode* nxt = mid->next;
        mid->next = prev;
        prev = mid;
        mid = nxt;
    }

    ListNode *p = head, *q = prev;             /* 3. 交替合并 */
    while (q) {
        ListNode* pn = p->next;
        ListNode* qn = q->next;
        p->next = q;
        q->next = pn;
        p = pn;
        q = qn;
    }
}
时间 ,空间 。回文链表和重排链表共用同一套三步模板,把其中一个背熟即可。
概念考点速记(选择题/填空题)
算法设计题之外,选择题和填空题更爱考下面这些结论,集中放在这里;正文里不再穿插考点提示,以免打断原理的学习。
1. 存储密度:。顺序表必为 1;单链表小于 1(int + 8 字节指针时约 );结点带其他辅助字段时会更低。
考察内容:比较两种存储结构空间效率的选择题。
2. 两种”插入”的复杂度:在已知结点 *p 之后插入是 (只改两条指针);在给定值为 x 的结点之后插入是 (先按值查找)。题目问插入复杂度时,先判断位置是已知还是查找得到的。
考察内容:选择题的经典陷阱——把”已知位置插删 “套到”按值插删”上。
3. 删除 p 的后继结点(填空):
q = p->next;
p->next = q->next;
free(q);
只做逻辑删除(不释放)时可简写为 p->next = p->next->next;;顺序不能颠倒。
考察内容:填空题写指针操作序列,或判断”先 free 后改指针”的错误写法。
4. 头插法得到逆序:用头插法建表,得到的序列与输入顺序相反;这个性质常与就地逆置、链表重排一起考。
考察内容:选择题给插入序列问最终链表,或判断逆序关系。
5. 首部/尾部插删的效率对比:
| 链表形态 | 末尾插入 | 删除尾结点 | 表头插删 |
|---|---|---|---|
| 单链表 | (需遍历到尾) | (需找前驱) | (不带头结点也可,但需改头指针) |
| 带尾指针的单循环链表 | (需找前驱) | ||
| 带头结点单链表 | |||
| 带头结点双循环链表 |
频繁”末尾插入 + 删除尾结点”选带头结点双循环链表;只做表头操作时,带头结点单链表也能 ——“带头结点”的意义就在于简化首元结点的插删与统一空表处理。
考察内容:结构选型选择题,或综合题里的方案比较。
6. 双向链表插删的指针顺序(填空):删除 p:p->next->prior = p->prior; 然后 p->prior->next = p->next;;在 p 之后插入 q:q->prior = p; q->next = p->next; p->next->prior = q; p->next = q;。先接后继、再改前驱,顺序颠倒会丢失原后继地址。
考察内容:填空题写指针操作顺序,或找出错误顺序。
7. 创建有序单链表是 :无序数据建成有序单链表,每插一个都要找位置,共 ;数据已有序时用头插/尾插创建只需 。
考察内容:复杂度填空/选择。
8. 判空对照表(高频填空):
| 链表形态 | 判空条件 |
|---|---|
| 不带头结点单链表 | head == NULL |
| 带头结点单链表 | head->next == NULL |
| 带头结点循环单链表 | head->next == head |
| 带头结点循环双链表 | head->next == head(或 head->prior == head) |
考察内容:填空题与选择题的常客,特别是”带头结点单链表”这一行。
9. 带头结点双循环链表”只有一个元素结点”(高频填空):
L->next != L && L->next->next == L等价写法:L->next->next == L && L->prior == L->next。前半句排除空表(L->next == L),后半句说明首元结点的后继回到头结点。
考察内容:填空题;常与判空条件一起考。
10. 带尾指针的循环单链表:rear 指向尾结点,则 rear->next 是头结点,首元结点是 rear->next->next。已知 rear 时尾插、取尾结点都是 ;但删除尾结点仍 (找不到前驱)。删除首元结点若链表只剩一个元素,必须更新尾指针:if (q == *rear) *rear = head;,紧凑写法就是 if (p == q) p = h;(p 尾指针、q 首元结点、h 头结点)。
考察内容:填空题问首元结点的表示、删除首元结点的边界判断。
11. 循环链表的指针链推导:循环单链表中,沿 next 走几层回到起点,就说明链上有几个结点。例如 L->next->next->next == L,从 L(头结点)出发走 3 步回到 L,说明链上共 3 个结点(不含头结点);若 L->next == L 则为空表。数 ->next 的层数 = 数结点个数。
考察内容:选择题给一串
->next表达式,问表长或判断是否成环。
12. 有序单链表单次插入是 :保持有序的插入,时间几乎都花在”从头找第一个不小于 x 的结点”上——查找 、改指针 ,总计 。 个无序数据建成有序单链表是 。注意与”已知位置插入 “区分开。
考察内容:复杂度选择/填空,经典干扰项是把两者混为一谈。
13. 升序合并为降序是 :合并两个长度 、 的升序链表,若把每次选出的较小结点用头插法挂到结果表头,得到的就是降序表。比较指针最多走 步,故 ;大 记号下它与 等价()。尾插保序、头插逆序,这是这道题的全部考点。
考察内容:算法设计/复杂度分析,问”升序合并为降序”的实现与复杂度。
14. 静态链表的游标修改:静态链表用数组下标(游标)代替指针,逻辑后继看游标、不看相邻下标。在结点 i 之后插入 s,做 next[s] = next[i]; next[i] = s;;删除做 next[i] = next[next[i]];,被删结点下标挂回备用链表。
考察内容:填空题给”数据 + 游标”表,问插入/删除后游标字段的变化序列。
15. 单链表的遍历局限:单链表只有指向后继的指针,从任一结点出发只能向后走,无法向前;想从中间结点反向遍历全表,只能重新从头开始。要支持双向遍历就得用双向链表(或循环双链表)。顺序表则两边都能随机访问。
考察内容:概念判断题,常与”双向链表的优势”一起考。
16. 带头结点 vs 不带头结点:全面对比
单链表的两种实现方式的区别,几乎覆盖了初始化、插入、删除等所有边界操作,是选择/填空/判断题的高频区(链栈同理,见 栈):
| 对比项 | 带头结点 | 不带头结点 |
|---|---|---|
| 初始化 | 分配一个头结点,head->next = NULL | head = NULL(空表无任何结点) |
| 头指针状态 | 始终非空(指向头结点) | 空表时为 NULL |
| 判空 | head->next == NULL | head == NULL |
| 头插(首元前插入) | s->next = head->next; head->next = s; 头指针不变 | s->next = head; head = s; 头指针被修改 |
| 头删(删除首元) | q = head->next; head->next = q->next; free(q); 头指针不变 | q = head; head = head->next; free(q); 头指针被修改 |
| 任意位置插删 | 有前驱即可统一处理,首元结点不特判 | 首元结点无前驱,插入/删除首元都要单独处理 |
| 空表处理 | 统一(空表也有头结点) | 每次都要特判 head == NULL |
| 头指针是否会变 | 通常不变(只有销毁时置空) | 头插、头删、删空都会变;常需返回新头指针或传 SNode** |
| 参数形式 | 常用 SNode* | 常用 SNode**,或用返回值带回新头指针 |
| 空间开销 | 多一个头结点(不存有效数据) | 无额外结点 |
| 优点 | 边界统一、代码简洁、空表与非空表一致 | 省一个结点、逻辑直观 |
| 代价 | 多一个结点、多一次间接访问 | 边界特判多,容易漏判 |
一句话:带头结点的好处都来自”头指针永远不为空、首元结点也有前驱”——首元结点被变成普通结点,头插/头删/插入/删除就能共用一段代码。
考察内容:判断题常考”带头结点后头指针在头插/头删时是否改变”;填空题给判空条件、插入/删除语句;选择题问”带头结点的优点”。
17. 清空 vs 销毁
“清空”和”销毁”都释放结点,但含义不同,是概念题常考点:
| 对比项 | 清空(Clear) | 销毁(Destroy) |
|---|---|---|
| 目的 | 删除所有数据元素,使表回到初始空状态 | 释放整条链表(含头结点)占用的全部内存 |
| 链表是否还能用 | 能,可以继续插入 | 不能(除非重新初始化) |
| 带头结点时 | 释放数据结点,保留头结点,head->next = NULL | 释放数据结点和头结点,head = NULL |
| 不带头结点时 | 释放所有结点,head = NULL(代码与销毁基本相同) | 释放所有结点,head = NULL |
| 复杂度 | ||
| 关键区别 | 保留”入口”(头结点) | 连同”入口”一起释放,头指针必须置空 |
| 接口命名 | ClearList | DestroyList / Destroy |
易错点:清空后头指针不能变成野指针——带头结点时
head仍指向头结点,不带头结点时head应指向NULL;而销毁后必须把head置NULL,否则是悬空指针,重复销毁还会 double free。
考察内容:概念选择/填空”清空后链表还能否使用""销毁后头指针应为何值""带头结点清空保留了哪个结点”。
扩展:隐藏节点与更多实现
链表的核心就是”结点 + 指针”,围绕它还有不少工程变体与技巧值得了解。
隐藏节点:哑结点、头结点、哨兵
它们指的是同一类东西——不存放数据的辅助结点,作用是让边界情况消失:
| 名称 | 位置 | 作用 |
|---|---|---|
| 哑结点(dummy) | 临时放在表头之前 | 让”插入/删除首元结点”和中间结点用同一段代码 |
| 头结点 | 永久挂在表头之前 | 头指针永远不空,统一空表与非空表的处理 |
| 哨兵(sentinel) | 表头或表尾 | 消除 NULL 判断或循环边界判断 |
没有头结点时,删除首元结点要单独写一段”改 head”的代码;有了头结点,prev->next = cur->next 对首元结点同样成立。代价是多一个结点、多一次间接访问。判断”要不要带头结点”,就看边界处理是否已经复杂到值得多花这个结点。
带尾指针的单链表
普通单链表尾插要走到表尾()。如果额外维护一个 tail 指针,尾插就是 tail->next = node; tail = node;,。这就是”用空间换时间”的一行注脚——代价是多存一个指针,好处是尾部操作从 降到 。
内存池与空闲链表
频繁 newNode / free 会让 malloc 反复分配与回收小块内存,开销和碎片都不小。工程做法是一次申请一大块结点,自己维护一条空闲链表:要结点时从空闲链摘一个,删除时还回去。Linux 内核、游戏引擎、高性能服务器里都很常见。
更多链表形态
单向、双向、循环只是最基础的三种。链表其实可以从三个方向继续变:一个结点挂几条链(多重链表)、链上放的是数据还是整张表(广义表)、一段连续空间还是单个结点(块状链表、展开链表)。前面”深入底层”已经讲过展开链表、静态链表、XOR 链表、侵入式链表,这里再补几种常见变体和它们的核心写法。
广义表:链表的递归形态
本节只讲广义表与链表的联系;完整的定义、Head/Tail、长度/深度、递归表与典型题见 广义表。
广义表是线性表的推广,元素既可以是原子,也可以是子表:(a, (b, c), d)。实现的关键是一个 tag 区分两种结点,再用 union 复用同一片空间:
typedef enum { ATOM, LIST } ElemTag;

typedef struct GLNode {
    ElemTag tag;                 /* 标记这是原子还是子表 */
    union {
        int atom;                /* tag == ATOM:存数据 */
        struct GLNode *hp;       /* tag == LIST:指向子表 */
    } val;
    struct GLNode *tp;           /* 指向同一层的下一个元素 */
} GLNode;
hp 和 tp 就是 Lisp 里的 head 与 tail:取表头 GetHead 是”拿 hp 指向的那个元素”,取表尾 GetTail 是”拿去掉表头后剩下的表”。广义表的长度是顶层元素个数,深度是括号嵌套的层数,两个都要递归地数。考点基本都围绕这两者展开。
多重链表:一个结点挂多条链
普通链表的结点只有一个 next;多重链表的结点带多个指针域,同一个结点同时串在多条链上:
typedef struct OLNode {
    int row, col, val;
    struct OLNode *right, *down;   /* 同行、同列各串一条链 */
} OLNode;上面这个结构就是十字链表——每个非零元素既在第 row 行的链上(right),也在第 col 列的链上(down)。还有:
- 邻接多重表:无向图的一条边只存一份,两个端点各用一根指针串进自己的边链;
- 孩子兄弟表示法:树的结点用
firstChild(第一条孩子链)和nextSibling(同层兄弟链)表示,一棵多叉树就被改造成了二叉树。
共同点是用多个指针域换取”同时属于多条链”的能力。具体应用见 稀疏矩阵、图、树 各章。
舞蹈链(DLX):十字交叉双向循环链表
舞蹈链(Dancing Links, DLX)把每个结点上下左右都接起来,形成十字交叉的双向循环链表,用来高效求解精确覆盖问题(数独、N 皇后等)——回溯时”删一列/恢复一列”只动指针,不搬数据。核心就两个函数:
typedef struct Node {
    struct Node *L, *R, *U, *D;    /* 左、右、上、下四个方向 */
} Node;

void remove(Node *c) {             /* 删除第 c 列 */
    c->L->R = c->R;
    c->R->L = c->L;
    for (Node *i = c->D; i != c; i = i->D)
        for (Node *j = i->R; j != i; j = j->R) {
            j->U->D = j->D;
            j->D->U = j->U;
        }
}

void restore(Node *c) {            /* 恢复第 c 列(与删除顺序相反) */
    for (Node *i = c->U; i != c; i = i->U)
        for (Node *j = i->L; j != i; j = j->L) {
            j->U->D = j;
            j->D->U = j;
        }
    c->L->R = c;
    c->R->L = c;
}
能”删了还能原样长回来”的关键,是 restore 严格按 remove 的逆序操作。这是链表结构里少见的、被算法竞赛反复使用的高级技巧。
自组织链表:会”自我调整”的链表
链表的查找是 ,但”常查的元素如果能往前挪”,平均代价就会下降。三种经典策略:
| 策略 | 做法 | 特点 |
|---|---|---|
| 前移法 | 找到后直接移到表头 | 最常用,实现简单 |
| 转置法 | 找到后与前驱交换 | 每次只前进一步,更稳 |
| 频度法 | 按访问次数排序 | 需要额外计数域 |
前移法的核心代码——找到 x 后把它摘下来、挂到表头:
Node* find_mtf(Node **head, int x) {
    Node *prev = NULL, *cur = *head;
    while (cur && cur->data != x) { prev = cur; cur = cur->next; }
    if (!cur || prev == NULL) return cur;   /* 没找到,或已经在表头 */
    prev->next = cur->next;                 /* ① 从原位置摘下来 */
    cur->next = *head;                      /* ② 挂到表头 */
    *head = cur;
    return cur;
}
工程里的 LRU 缓存就是前移法的加强版:哈希表负责 定位,双向链表负责 把它挪到”最近使用”的一端。
块状链表:数组与链表的杂交
把长序列切成若干块,块内用数组、块间用链表串起来,每块约 个元素:
#define B 512
typedef struct Block {
    int data[B];
    int size;
    struct Block *next;
} Block;- 按下标访问:沿链找到所在块,再在块内随机访问,;
- 插入/删除:块内搬移 ;块写满就分裂成两块,太短就与邻居合并。
它和”深入底层”讲过的展开链表长得像,区别在于支持块的分裂与合并,能稳定维护”第 个元素”的位置,常用于文本编辑器(rope)和大型序列的中间层。
有序链表与循环有序链表
如果建表时始终让结点有序,查找一旦遇到更大的值就能提前停下,合并、去重、求交并差都变得顺手。插入的核心是”找到第一个不小于 x 的结点,插到它前面”:
void insert_sorted(Node **head, int x) {
    Node *s = newNode(x);
    while (*head && (*head)->data < x)
        head = &(*head)->next;   /* 二级指针一路递推,省掉 prev */
    s->next = *head;
    *head = s;
}
这里的技巧是用 **head 沿链递推,不用单独维护 prev,插表头和插中间就自然统一了。注意单次插入的时间几乎都花在”找位置”上,是 ;把 个无序数据建成有序表则是 。循环有序链表(两个有序循环链表合并后仍成环)常见于操作系统的时间轮与轮询调度。
还能用链表做什么
- LRU 缓存:哈希表定位 + 双向链表调整顺序,get/put 均 (见 哈希表)
- 跳表:给有序链表加多级索引,把查找从 降到 (见 跳表)
- 邻接表:图的存储方式之一,每个顶点挂一条边链表(见 图)
- 侵入式链表:把
next/prev嵌进业务结构体,结点零额外分配(见本章”深入底层”)
各语言标准库对比
| 语言 | 单向链表 | 双向链表 | 说明 |
|---|---|---|---|
| C | 无(手写) | 无(手写) | 内核提供侵入式 list_head |
| C++ | std::forward_list | std::list | std::list::size() 在 C++11 前为 O(n) |
| Java | 无 | LinkedList | 实现 Deque 接口,可用作队列 |
| Python | 无 | collections.deque | 用双向链表实现,O(1) 两端操作 |
| Rust | 无(LinkedList 已标记 deprecated 倾向) | LinkedList | Rust 社区推荐用 VecDeque |
| Go | 无 | container/list | 侵入式设计,存储 interface{} |
应用场景
- LRU 缓存:双向链表 + 哈希表。哈希表将 key 映射到链表节点——O(1) 定位,链表将节点移到头部 O(1)。淘汰时删除尾部节点。详见 哈希表
- 空闲块管理器:
malloc的空闲链表。操作系统和内存分配器用双向链表或循环链表管理空闲物理页框(free page list)。详见 内存分配器 - 多项式表示:每个节点存储一个项(系数 + 指数),按指数排序。加法操作即归并两个有序链表。O(m+n) 而非 O(mn)
- 图的邻接表:每个顶点的邻接顶点列表。在邻接表中使用链表(而非
vector)允许 O(1) 增量插入边。详见 图
练习
| 题号 | 题目 | 说明 |
|---|---|---|
| 206 | 反转链表 | 迭代/递归双解(见正文两版实现) |
| 141 | 环形链表 | Floyd 快慢指针 |
| 142 | 环形链表 II | 定位入口(正文 Floyd 第二阶段 + 数学证明) |
| 21 | 合并两个有序链表 | 归并思想(见手写题型专练) |
| 19 | 删除链表的倒数第 N 个结点 | 倒数第 k 模板 + 前驱处理 |
| 234 | 回文链表 | 找中点 + 逆转 + 比对三步模板 |
| 160 | 相交链表 | 双指针消除长度差 |
| 86 | 分隔链表 | 双哑结点保序分隔 |
核心推演清单
练习题与上面的 LeetCode 互补——侧重手算推演与代码默写,全部在正文中带完整答案:
| 自测 | 位置 | 内容 |
|---|---|---|
| 循环链表 ×3 问 | 约瑟夫问题之后 | 出列序列推演、哨兵环的首尾访问、数据换位插表头技巧 |
| 倒数第 k | 手写题型专练 | 双指针间隔轨迹 |
| 合并有序 | 同上 | 归并取值次序与剩余段收尾 |
| 回文链表 | 同上 | 中点切分与逐对比较 |
| 分隔链表 | 同上 | 保序收集与封口陷阱 |
动手实验
| 编号 | 题目 | 说明 |
|---|---|---|
| E1 | 链表 vs 数组遍历硬件计时 | 构建 1 千万个 int 元素,分别用链表和数组顺序遍历并累加求和。用 perf stat -e cycles,instructions,cache-references,cache-misses 统计两者的 IPC(instructions per cycle)和 cache miss 率。验证数组 IPC 接近 2(超标量流水线满负荷),链表 IPC 接近 0.1(停顿在等待 DRAM) |
| E2 | malloc 元数据开销测量 | 分配 N=100000 个链表节点并记录每个节点的地址。计算相邻节点之间的地址差分布——展示 malloc 分配的不可预测性。再通过 malloc_usable_size 获取每个节点实际占用的堆内存(包括元数据),与 sizeof(SNode) 对比 |
| E3 | 哨兵设计 vs 非哨兵设计的边界条件统计 | 分别用哨兵链表和无哨兵链表实现 push_front/push_back/pop_front/pop_back 的完整测试(含空链表、单元素、多元素边界情况)。统计两版代码中 if (head == NULL) 类条件判断的数量 |
| E4 | 展开链表构建与遍历 | 实现展开链表(展开因子 8),与普通链表同时插入 100 万个元素,然后顺序遍历累加求和。计时对比,用 perf stat 统计 cache miss |